2.2 显存账本与三重浪费
2.2 显存账本与三重浪费
本节摘要:KV Cache 的显存开销分两类:必要的(真实上下文的键值)与浪费的(预留、内部碎片、外部碎片)。本节逐笔算出三重浪费的量级,解释"利用率长期三成上下"的来源,并说明为什么只要沿用"连续整块、按最坏预留"的管理方式,浪费就无法自救。问题钉死之后,第 3 章的块表设计便水到渠成。
把一张卡想成一座停车场:模型权重是固定租用的车位,KV Cache 则是随到随停的临时车位。停车场管理员最怕的不是车位太少,而是明明有空位、却有车进不来的局面——某些车位被长期预订却常年空着,某些空位零散地散落在各处、拼不成一辆大车需要的连续车位。传统推理框架的显存管理,正处在这种"有位无用"的尴尬里。本节把账本翻到浪费那一页,逐笔核对。
第一笔:预留浪费——按最坏情况发牌
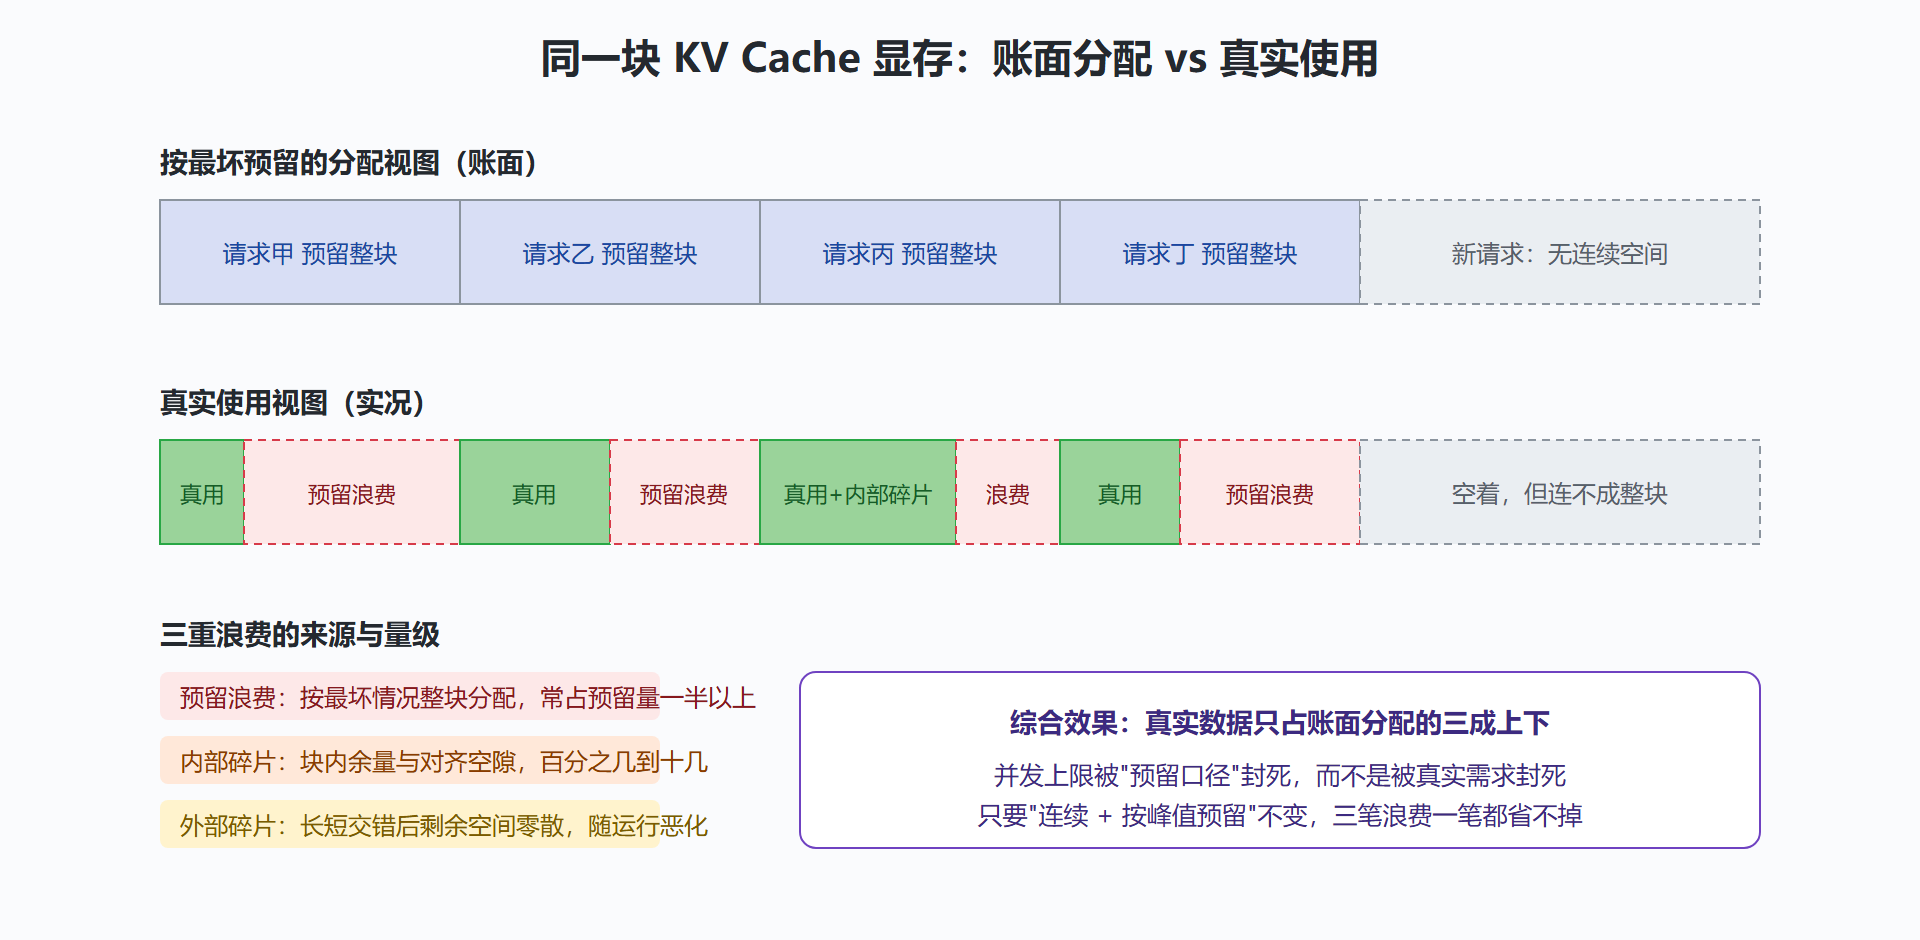
传统框架(以朴素的 Hugging Face 部署方式为典型)为每条请求一次性分配一块连续显存,大小按 max_seq_len(最大序列长度)计算。无论这条请求最终生成五十个 token 还是四千个,预留都按四千算。
算一笔具体的账。沿用第 2.1 节的 8B 模型(GQA 后 KV Cache 约每千 token 0.125 GB),设 max_seq_len 为 4096:
每条请求预留:4096 token × 0.125 GB/千token ≈ 0.5 GB 实际对话平均输出后总长约 800 token,真实占用 ≈ 0.1 GB 预留浪费 ≈ 0.4 GB/条 —— 预留量的八成躺在卡上睡大觉
放大到整卡:假设 50 GB 显存分给 KV Cache,按预留口径只能容纳一百条请求;而这批请求真实的 KV Cache 总和可能只有十几个 GB。换句话说,同一时刻这张卡上有一半以上的 KV Cache 显存从未被真实数据填过,却让后续请求吃到了"显存不足"的闭门羹。并发上限被预留口径而不是真实需求封死——这是三笔浪费里最大的一笔。
第二笔:内部碎片——预留还留有余量,块内照样用不满
预留式分配为了安全还会再加缓冲:有些实现按"最大长度再加一段"分配,或者按分配粒度向上取整。结果是即使请求真的用满了预期的上下文长度,块内仍有一段永远用不上的空隙。
这就像货轮装集装箱:每个箱位按最大箱型焊死,装小箱时四壁的空隙白白跟着跑完全程。内部碎片的量级取决于实现,通常又吃掉预留量的百分之几到十几。单独看不大,但它是结构性的——只要"按峰值预留"的设计不变,它就永远在。
第三笔:外部碎片——零散空位拼不成整块
请求有长有短、有先有后,释放顺序也不会按分配顺序来。运行一段时间后,显存里留下的是大空块与小空块交错的局面:加起来明明还剩几个 GB,却找不到一块连续的 0.5 GB 给新请求的 KV Cache——因为"连续整块"是硬约束。
外部碎片最阴险的地方在于它随时间恶化:服务跑得越久,空块越碎,"明明有内存却分配失败"的报错越频繁。很多团队遇到这个问题后的第一反应是重启服务——那是清账,不是治账。
图:显存账本上的三重浪费
三笔账合起来:利用率三成从哪来
把三个数字相乘大致就是传统方案的真实利用率:真实长度与预留长度之比(长对话场景常见两到五成),乘以块内有效比(九成上下),再乘以碎片造成的可用比(八到九成)——落到整体,KV Cache 显存的有效利用率长期在三成上下徘徊,这与 vLLM 论文对现有系统 20% 到 40% 利用率的实测一致。
| 浪费类型 | 成因 | 量级 | 能否用小技巧缓解 |
|---|---|---|---|
| 预留浪费 | 按 max_seq_len 整块预留 | 预留量的一半以上 | 调小 max_seq_len 治标,伤害长请求 |
| 内部碎片 | 对齐、缓冲、峰值思维 | 几个百分点到十几 | 换实现也难根除 |
| 外部碎片 | 连续分配 + 乱序释放 | 随运行时间恶化 | 重启清账,不治本 |
表里"缓解"一列说清楚了为什么这个问题不能靠调参自救:调小 max_seq_len 能减少预留浪费,但长上下文请求直接被拒;换分配器能缓解外部碎片,却动不了"必须连续"的前提。三笔浪费共享同一个病根:把 KV Cache 当成"连续的、一次性给足的"普通大数组来管。
亲手验证:三分钟量出你服务的浪费率
这笔账不必信任何人,可以自己量。步骤是拿三个数字做除法:
第一步:从启动日志读出块池总容量(比如 50 GB 折算成可容纳的 KV Cache token 总量)。 第二步:从监控读出当前并发条数与平均序列长度,算出"真实在用的 KV Cache 量"。 第三步:真实量 ÷ 容量 = 利用率。 再对比"按 max_seq_len 预留口径的占用量",两者之差就是预留浪费。
如果量出来的利用率远低于五成,第 3 章的改造对你就是数倍级的收益;如果已经接近八成(说明负载本身很长、预留接近真实),块表的边际收益会小一些,优化重心应移向批处理与缓存。先量再改,是调优与玄学的分界线。
历史的注脚:这个问题曾经被当作"必然代价"
在 PagedAttention 论文发表之前,社区普遍把低利用率当成大模型推理的固有成本——讨论集中在"买更大的卡"与"限制上下文长度"之间。回看那段时间的论坛与工单,大量"显存不足"的抱怨其实不是容量问题,而是管理问题,只是当时没有人把三笔浪费拆开来算。这也是本册把这一章放在最前面的原因:看清浪费的构成,是所有优化叙事的起点。同样的故事在计算史上反复上演——先有清晰的账本,才有对症的药方。
本节要点回顾
- 预留浪费是最大头:按最坏情况发牌,让大半 KV Cache 显存常年空转,并发上限被预留口径封死。
- 内部碎片是结构性的,峰值思维不改,对齐空隙永远在。
- 外部碎片随时间恶化,"重启大法"是清账不是治账。
- 三项相乘得出三成上下的真实利用率,与 vLLM 论文实测吻合——这就是全册要追回的空间。
- 病根是"连续整块 + 按峰值预留"的管理范式,治本必须同时取消连续性假设与峰值假设。
病根找到了,药方也就呼之欲出:取消连续性、按真实需求小颗粒分配。第 3 章看 PagedAttention 怎么把这对组合落地成块表——那是 vLLM 全部魔法里最核心的一枚齿轮。