4.1 静态批的等待浪费与迭代级调度
4.1 静态批的等待浪费与迭代级调度
本节摘要:静态批把一批请求捆成同进同出的命运共同体,短请求必须陪跑到批里最长的那个结束;连续批处理把批的进出粒度从"一轮"细到"一步",完成即走、到达即入。本节先用一个数值例子算出陪跑损耗,再拆解迭代级调度的循环结构,解释它能同时改善吞吐与 TTFT的原因。
为什么夜里的卡明明闲着,吞吐却只有白天的几分之一?上一章末尾留下的这个疑问,答案藏在批的生命周期里。本节先算一笔陪跑账,再看 vLLM 的调度循环怎么把这笔账省下来。读完你会明白:吞吐与 TTFT 在传统架构下是"二选一"的取舍,在迭代级调度下却可以同时改善。
陪跑账:一批请求的等待有多贵
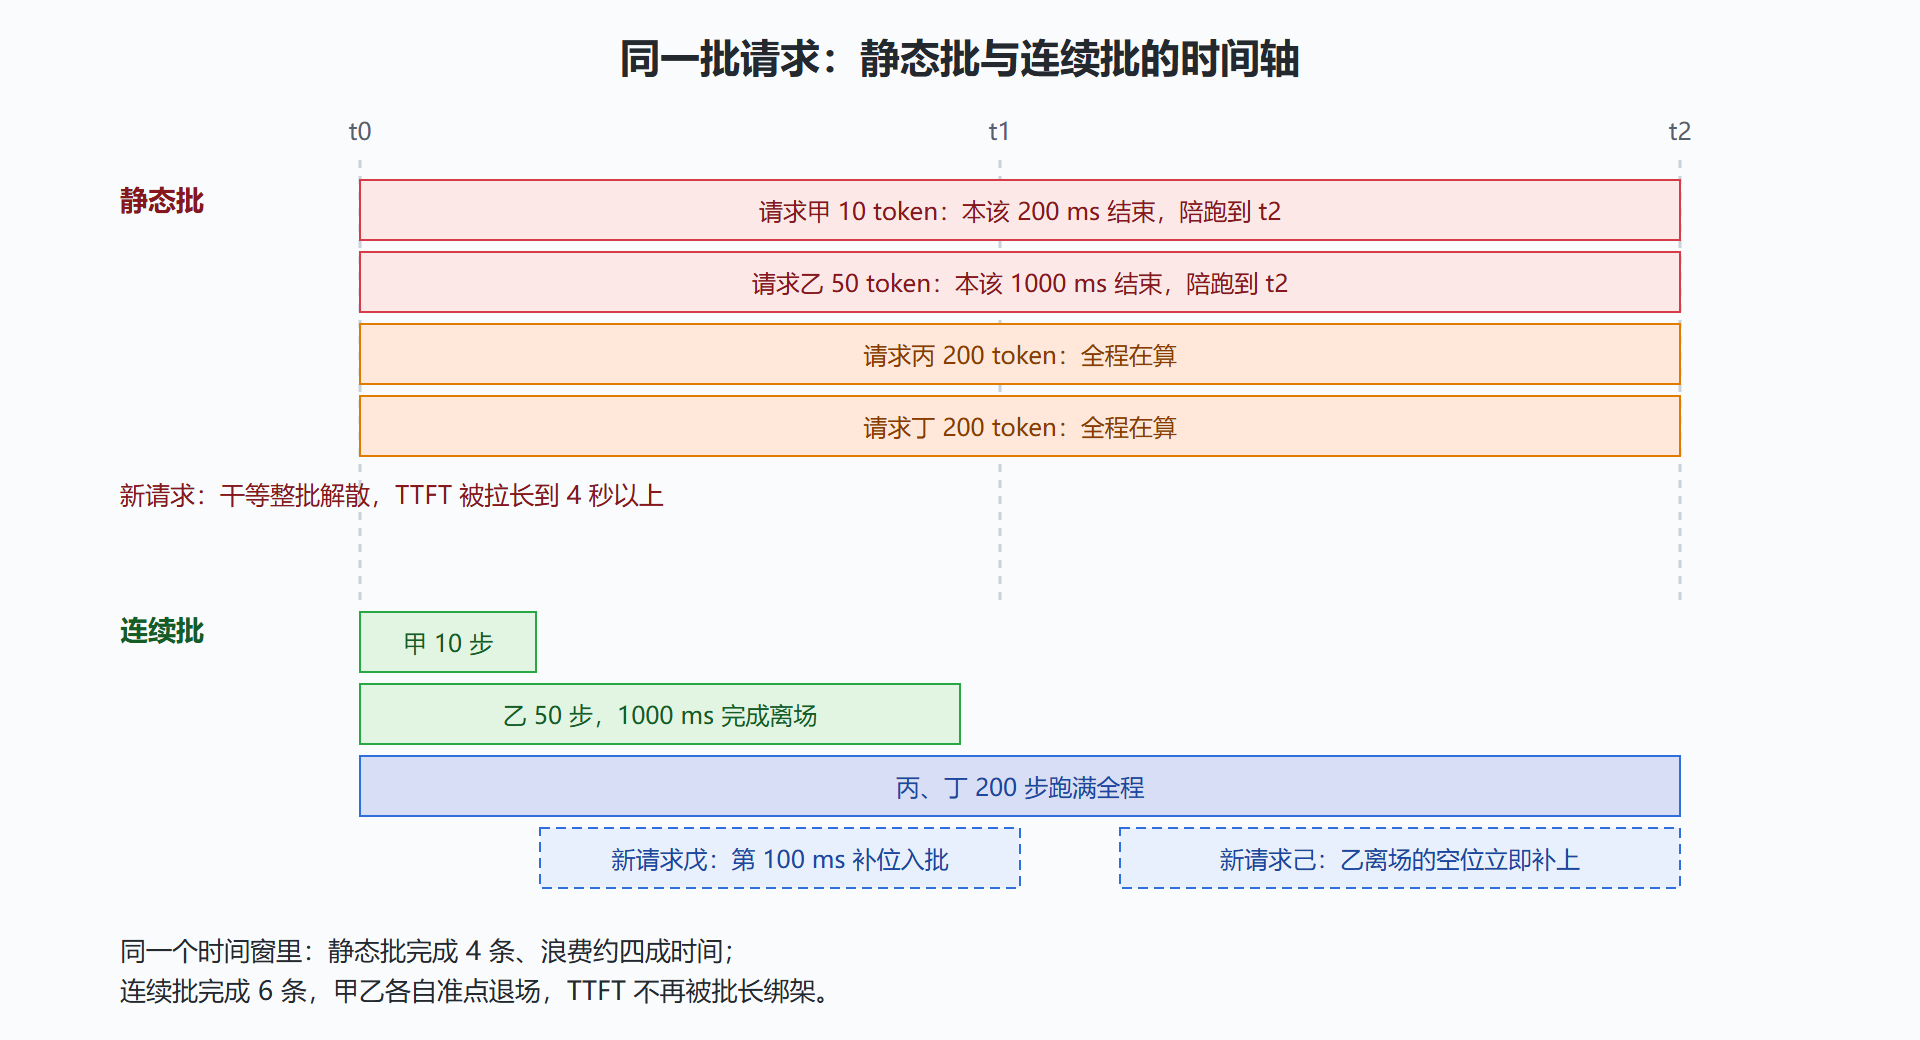
设一个批里有四条请求,输出长度分别为 10、50、200、200 个 token,批必须等最长者完成才能解散。用每 token 一步、每步 20 毫秒粗算:
静态批(同进同出): 批的总时长 = 200 步 × 20 ms = 4000 ms 四条请求各占的 GPU 时间片 = 4000 ms(整批被捆在一起算) 有效工作 = (10 + 50 + 200 + 200) 步 = 460 步 陪跑浪费 = 4 × 4000 - 460 × 20 = 16000 - 9200 = 6800 ms ≈ 42.5% 的时间在空转 更糟的是体感:输出 10 token 的那条请求在第 200 ms 就该结束, 却要等到 4000 ms 才拿到结果——它"贡献"了完整的批时长。
问题还不止陪跑。静态批有第二个连带伤害:新请求干等。批在跑,哪怕批里只剩一条请求、哪怕显存大量闲置,新到的请求也只能排队等下一轮——第 1 章主线场景里"夜里吞吐崩塌"的另一半原因正在于此:请求到达的稀疏时段,每轮批都在"装不满 + 陪跑"的双重浪费中度过。
传统架构下这两个问题几乎无解,因为批的成员在启动时就焊死了:往批里加请求需要为它腾出整块 KV Cache(第 2 章说过这多难),还需要让整批重新走一遍对齐。块表改变了前提——每条请求的显存按块计价、随取随还,批的成员增减从"伤筋动骨的重组"变成"改一行名单"。
图:静态批与连续批的时间轴对比
迭代级调度:每一步都重组一次批
连续批处理(continuous batching,也叫迭代级调度 in-flight batching)把调度决策的频率从"每轮一次"提到"每步一次"。主循环长这样:
while True: # 1. 收割:本步有 token 生成完毕(遇到结束符或达到长度上限)的请求立即离场 for req in running_batch: if req.finished(next_token(req)): release_blocks(req) # 物理块归还空闲池(第 3 章的机制) running_batch.remove(req) # 2. 补位:等待队列按先到先得扫一遍,能装下的立即入批 for req in waiting_queue: if scheduler.can_admit(req): # 检查块池余量、批上限等 admit_and_prefill(req) # prefill 后加入运行批 waiting_queue.remove(req) else: break # 块池吃紧,后面的一起等等 # 3. 推进一步:当前批的所有请求各生成一个 token step(running_batch)
三个动作的顺序体现着优先级:先腾位置、再进新人、最后干活。每一步之间批都可能变了形状——有人离场、有人补位、没人进出的步骤则原批推进。注意第 2 步的入批检查依赖块池水位:这就是第 3 章与本章的咬合点,块表让"显存够不够"变成一次精确的算术检查,而不是"试试看会不会爆"。
为什么吞吐与 TTFT 能同时改善
传统静态批想提高吞吐就加大批容量,批越大陪跑越严重、新请求等得越久——吞吐与延迟此消彼长。连续批处理打破这对矛盾的方式,是消灭"等待"这个类别本身:
- 对吞吐:批内永远保持饱和——有请求离开立刻有人补位,GPU 每一步面对的都是满员批,权重搬运的成本始终被摊在最宽的批上。
- 对 TTFT:新请求不再等"上一轮结束",只等"下一步开始"——最坏等待从一个批时长降到一步(几十毫秒)。短请求也无需陪跑,各自生成完最后一个 token 就离场。
- 对显存:批成员的进出让块池高频周转,配合第 3 章的按需分配,显存水位稳定在真实需求附近而非预留峰值。
实测的形状通常是:同等硬件上吞吐提升数倍,P99 TTFT 从秒级降到百毫秒级,而且负载越高、长短请求混合越严重,对比越悬殊。调度本身不产生任何算力,它只是消灭了"算力在等事情"的时间——这也是第 1 章那句话的下半句:利用率不高,很多是因为 GPU 在等人。
💡 关键直觉:静态批是"班车"——发车时间固定,坐满发车,到站统一下客;连续批处理是"地铁"——不设班次,随到随上,到站即下。乘客(请求)的体验与车辆(GPU)的满载率同时改善,靠的不是跑得更快,而是把"等人"从系统里删掉。
陪跑账的推广:浪费率与"长度离散度"成正比
前面那个四条请求的例子可以推广成一条规律:静态批的陪跑浪费,取决于批内请求长度的不均匀程度。全批都是 200 token 的请求时几乎没有陪跑;长度从 10 到 200 混杂时浪费超过四成。这条规律给了一个实用的流量视角:请求长度越参差的服务,连续批处理的收益越大。通用开放接口就是最极端的例子——你完全无法预知下一条请求是一句话还是一篇论文,静态批在这种流量下长期处在严重陪跑状态。
调度循环的两个细节,读日志时会用到
其一,收割与补位发生在步骤边界:vLLM 的一步是批内所有请求各前进一步,调度决策插在步与步之间,所以新请求的最坏等待约等于一步耗时加一次 prefill——这是"TTFT 不再被批长绑架"的精确含义。其二,补位有准入检查,检查不过会连带阻塞队列里排在后面的请求(先到先得的公平性),所以看到"队列非空但批未满"的日志时,先查准入失败的缘由(通常是块池水位或并发上限),而不是急着加机器。
这两处细节在压测复现时会反复用到:第 8 章的排查对照表里,"批不满但队列长"这一行的第一嫌疑就是准入检查的配置项。
本节要点回顾
- 静态批的双重浪费:批内短请求陪跑(可达四成以上时间)、批外新请求干等整轮。
- 块表是连续批处理的前置条件:按块计价的显存让批成员增减变成轻量操作。
- 调度循环三步曲:收割完成的、补位等待的、推进一步——每步都重组批。
- 吞吐与 TTFT 同时改善的机理是消灭等待类别,而不是加快单步计算。
- 负载越混合、越高峰,连续批处理的相对收益越大;深夜低峰的吞吐塌陷也随之缓解。
批常态饱和之后,剩下的是极端时刻的取舍:流量洪峰把批和显存同时顶满,谁该被让路?下一节讲调度器的三张底牌。