4.2 抢占、交换与重计算:批满了牺牲谁
4.2 抢占、交换与重计算:批满了牺牲谁
本节摘要:连续批处理让批常态饱和,于是洪峰时刻必然遇到"批满 + 块池见底"的组合局面。调度器此时有三张底牌:按优先级抢占运行中的请求(Preemption)、把它的 KV Cache 换出到主存(Swap)、或干脆丢弃状态等恢复时重算(Recompute)。本节讲清三者的触发条件、代价曲线与参数配置,让你在洪峰来临时知道系统正在做什么、该怎么调。
上午十点,运营临时上线一个营销活动的弹窗,对话流量在一分钟内翻了两倍。监控上先是等待队列拉长,接着日志里出现一行很多团队从未见过的记录:Preempted X requests。有人慌了:"请求被杀了?"——没有。请求还活着,只是被调度器请出了运行批,让它暂时让路。本节就讲这套洪峰兜底机制:它为什么必须存在、三种让路方式的代价差异、以及参数怎么配。
为什么必须有人让路
第 4.1 节的调度循环里有一条铁律:decode 每一步都要求批内所有请求的 KV Cache 完整在场——注意力的回看依赖全部历史状态,缺一块就算不下去。块池水位充足时一切安好;但当等待队列里挤着高优先级请求、而运行批里的长请求又占着大量块时,矛盾出现了:不腾位置,新请求永远进不来;腾位置,就得让某个运行中的请求暂时中断。
调度器的选择排序通常是:优先让"最省事"的请求让路。所谓省事,是指让路的代价最小——这就引出了三种让路方式。
三张底牌:让路的代价各不相同
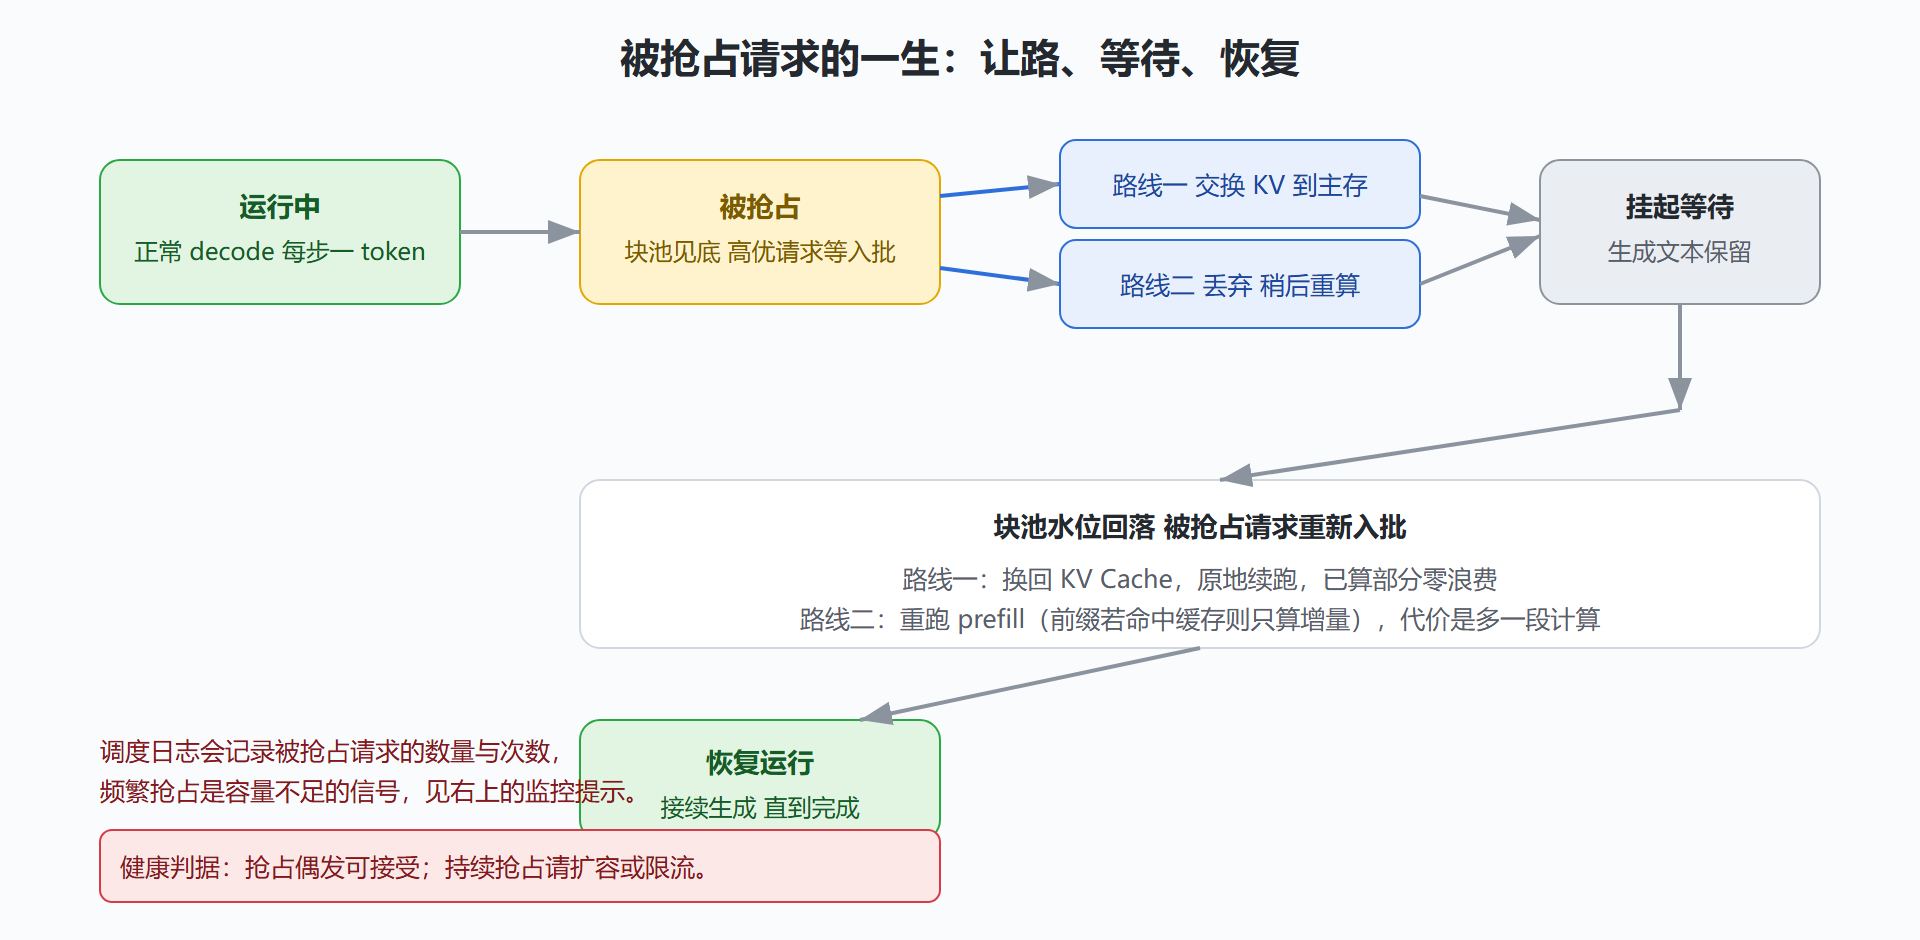
交换(Swap):把被抢占请求的 KV Cache 从显存搬到主存,请求挂起;块池腾出空间、高优请求入批;等水位回落,再把状态搬回来、原地续跑。代价是两次 PCIe 搬运——几十 MB 到几百 MB 的量级,毫秒到几十毫秒级。优点是之前算过的 token 一个都不浪费,恢复即接续。
重计算(Recompute):更简单粗暴——直接丢弃被抢占请求的 KV Cache,只保留它已生成的 token 文本;等它被重新调度时,把"原 prompt + 已生成部分"重新跑一遍 prefill,状态就恢复了。代价是多花一次 prefill 计算,优点是不占用主存、不需要搬运带宽,实现也最简单。
排队(不抢占):如果业务允许,最温和的方式是让新请求在等待队列里排队,运行批保持不动。代价是洪峰时 TTFT 恶化——但这是"变慢"而不是"返工"。
| 方式 | 状态去向 | 恢复成本 | 额外资源 | 适用场景 |
|---|---|---|---|---|
| 交换 | KV Cache 换出到主存 | 一次换回搬运 | 主存容量 | 主存充裕、抢占频繁 |
| 重计算 | 丢弃,保留生成文本 | 重跑一遍 prefill | 计算时间 | 前缀有缓存、或主存紧张 |
| 排队 | 无(请求未入批) | 无 | 等待时间 | 可接受 TTFT 上升的业务 |
三种方式不是互斥选项,而是调度器在不同水位下的组合拳。vLLM 默认的抢占模式即是"先重算,可切换为按层交换"(参数 --swap-space 控制每卡用于交换的主存 GB 数,默认给了几 GB 的余量)。前缀缓存(第 5 章)会让重计算的实际代价大幅下降——如果被抢占请求的前缀恰好命中缓存,"重算"其实只需重算分叉之后的增量。
图:一次抢占的生命周期——从让路到恢复
被抢占请求的体感:毛刺从哪来
对被抢占的那条请求而言,让路的直接体感是 TBT 出现一段毛刺:本来每 20 毫秒一个 token,抢占期间一个都不来,恢复后又突然涌出。用户端表现为"打字机卡了一下又狂奔"。这就是第 1.2 节说的"批越大 TBT 越差"之外的另一个 TBT 杀手——判别方法也简单:毛刺时刻与日志里的抢占记录对得上,就是抢占;对不上,再查网络与负载。
压测时有个实用技巧:故意把并发打到略超容量,观察抢占频率与 P99 TBT 的联动。如果抢占只发生在压测的峰值段、且恢复后 TBT 迅速回稳,说明兜底机制工作正常;如果抢占贯穿全程,说明容量缺口是结构性的,调参救不了,该加卡或该限流。
⚠️ 一个容易忽略的联动:抢占模式与 max-num-seqs(最大并发序列数)互相制约。把并发上限设得过于激进,块池常年贴顶,抢占成为常态,重计算的开销会吃掉连续批处理赚来的收益。容量规划宁可让 max-num-seqs 略保守,也别让调度器长期在刀尖上跳舞。
换一个视角:抢占是"公平性"的实现机制
把抢占只当成"洪峰兜底"其实窄了。它同时是调度公平性的执行手段:当一条高优先级请求(比如付费用户的实时对话)与一批离线批处理任务(比如夜间批量摘要)共享同一实例时,抢占让高优请求不必等待长任务走完。围绕这个能力,运维可以玩出的花样包括:按请求来源打优先级标签、把批处理流量安排在低峰并主动让路、用抢占计数反推混合负载的相互干扰程度。抢占不是故障,是调度器的正常工具——这个认知能避免很多不必要的深夜恐慌。
主存换出的容量账
如果决定用交换路线,主存配额要算一笔账:每条被换出请求占用的是它当前序列长度的 KV Cache(比如 8K 上下文、FP8 缓存约零点几个 GB),swap-space 的配额必须能同时容纳"预期的最大同时换出条数 × 单条大小"。配额不足时,调度器会退回重计算路线或限制换出数量,表现为抢占行为模式的突然变化。给主存做配额前,先回答"洪峰时最多会有多少条请求同时被换出"——这个数字从历史抢占日志的尖峰取,别凭感觉拍。
一条运维经验:给抢占设"预算"而不是"禁令"
有团队曾问:能不能干脆禁止抢占,宁可让新请求排队?可以配置,但通常不值得。禁止抢占换来的是确定性——运行批永不被打断,TBT 绝无毛刺;代价是高优请求的 TTFT 在洪峰时完全失控。更实用的做法是给抢占设预算:正常运行时抢占计数应接近零,把它做成带阈值的告警项,一旦持续触发就说明容量需要重新对账。抢占是症状指标,不是需要消灭的敌人——这个定位摆正了,第 8 章的监控体系就顺了。
本节要点回顾
- 批满 + 块池见底时必须有人让路,decode 的全量回看依赖决定了 KV Cache 必须完整在场。
- 交换省计算、重计算省资源:前者用主存搬运换零浪费,后者用多一次 prefill 换实现简单;前缀缓存会让重计算的实付代价大降。
- 抢占的体感是 TBT 毛刺,判别靠日志时间对齐,不要急着查网络。
- 抢占常态化是容量信号:偶发可接受,持续抢占请扩容或限流。
- 参数联动:max-num-seqs、swap-space 与块池水位共同决定抢占频率,调参时一起看。
洪峰兜底讲完,调度的故事完整了。下一章把镜头转向另一类浪费——重复劳动:相同的开头算了一遍又一遍,解码一步一步爬。前缀缓存与投机解码分别接手这两件事。