4.5 子电路与参数化:.SUBCKT、.PARAM、.STEP
4.5 子电路与参数化:.SUBCKT、.PARAM、.STEP
本节摘要:当网表超过一页,重复电路块与散落的魔法数字就成了维护灾难。.SUBCKT 把重复块打包成可调用的"器件",.PARAM 给参数起名字,.STEP 让一个参数的变化自动展开成一族曲线。三件套加起来,网表就从"一次性脚本"升级为"可维护的工程文件"。
打包:.SUBCKT 的两端协议
子电路的定义与调用遵循清晰的协议。定义端声明"我有哪些端子",调用端声明"我插在哪几个节点上":
* 一阶 RC 低通子电路 .SUBCKT RCLP in out param: FC=1.6k R1 in n1 {159/(FC*1m)} C1 n1 out {1m} .ENDS
上面是现代方言里带参数的写法,下面用最通用的基础形式重新表达,两者任选其一即可:
.SUBCKT RCLP in out R1 in n1 1k C1 n1 out 100n .ENDS
.SUBCKT 行声明子电路名与对外端子(in 和 out),.ENDS 收尾,中间夹着的器件构成内部世界;n1 是内部节点,外界看不见也碰不着。调用端把子电路当成一个"自造器件",用首字母 X 引用:
X1 vin v1 RCLP X2 v1 vout RCLP
两行调用串起两级一模一样的低通。仿真器在解析后会把调用"压扁":每级子电路的内容复制展开,内部节点自动重命名成带层次前缀的唯一名字(比如 x1.n1),器件同名不冲突。压扁发生在求解之前——所以最终进入方程组的仍然是一个大平网表,层级只是书写期的组织手段。理解这一点很重要:子电路不带来任何求解开销,纯粹是给人看的抽象。
子电路可以嵌套——一个"两级放大器"子电路内部调用两个"单级放大器"子电路。层数没有硬限制,但第 6 章会讲到:层次过深会让错误信息里的节点名变得冗长难读,工程上以两三层为度。
起名字:.PARAM 与表达式
散落在网表各处的裸数字是维护事故的温床。.PARAM 给数字起名字,正文用花括号引用:
.PARAM RLOAD=1k CVAL=100n GAIN_REQ=10 R1 in out {2*RLOAD} C1 out 0 {CVAL}
花括号里允许算术表达式与已定义参数的组合,改一处 CVAL,所有引用点同步更新。更进一步可以用 .FUNC 定义函数,把重复的表达式模板化。工程网表的经验法则:同一个数出现两次以上,就该给它起名字。
参数还能跨进子电路:定义行写成 .SUBCKT RCLP in out param: FC=1.6k,调用时 X1 vin vout RCLP FC=3.2k 就把截止频率翻倍——子电路从"固定积木"变成"可配积木",这是工艺库器件卡的通用做法,你在厂商模型里看到的每个可配参数,背后都是这套机制。
扫描:.STEP 展开一族曲线
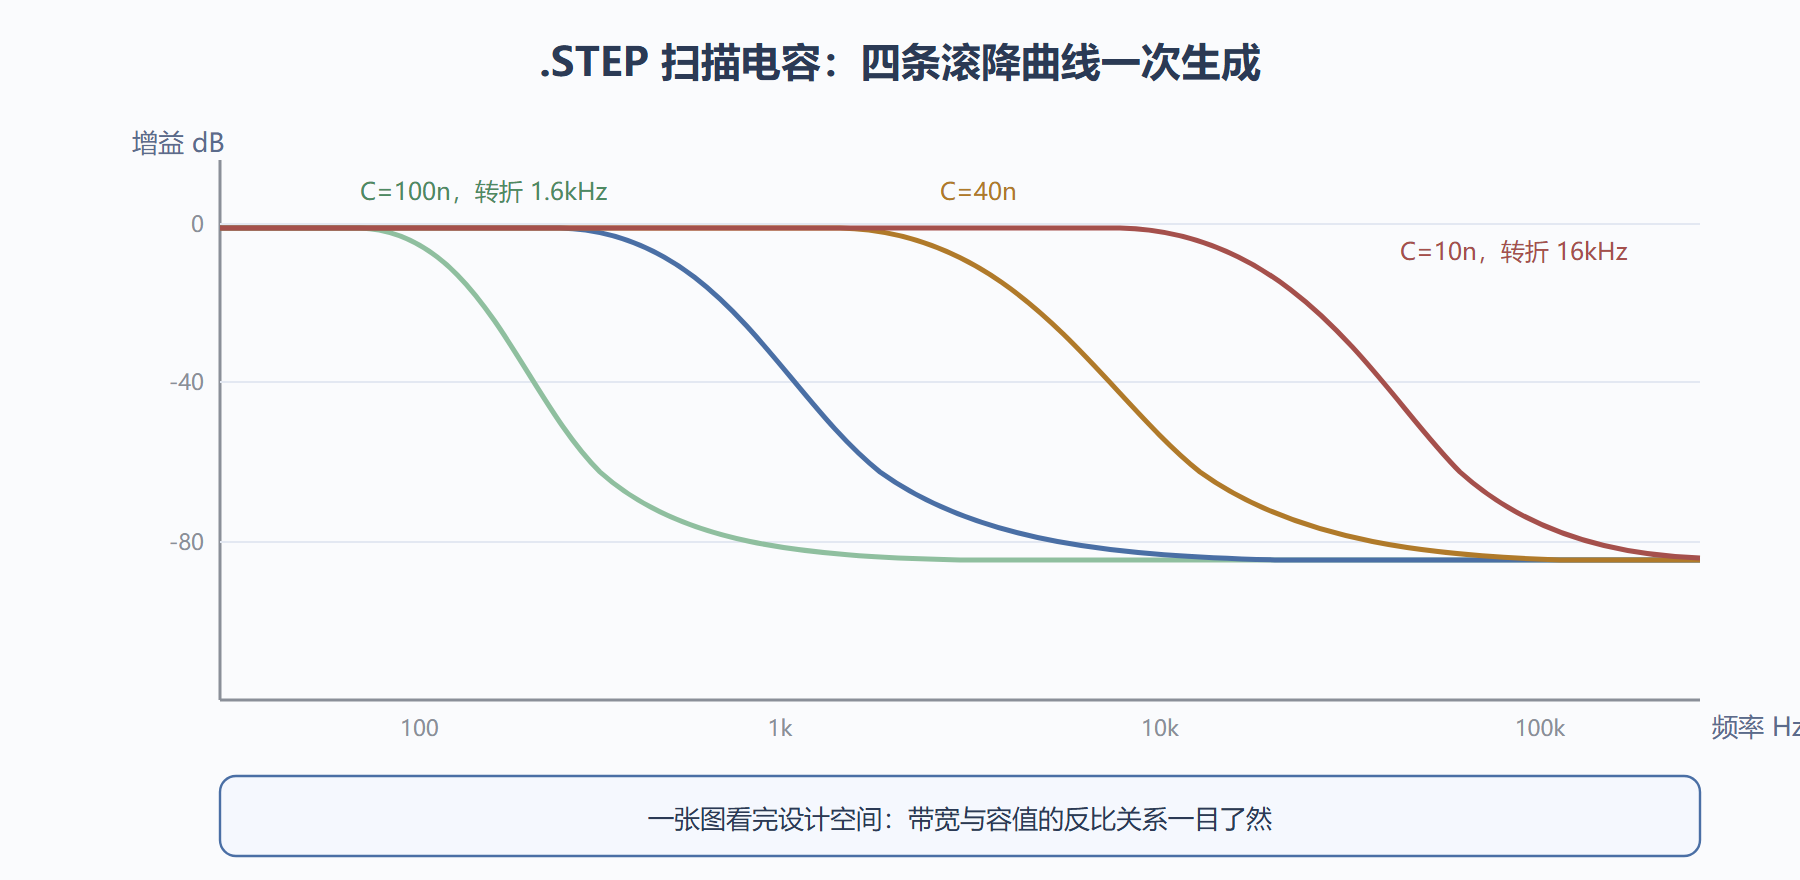
参数化之上再进一步:让仿真器替你把参数从起点扫到终点,每个取值跑一遍完整分析。以滤波器设计为例——电容从十纳法扫到一百纳法,看截止频率如何移动:
.PARAM CV=10n V1 in 0 AC 1 R1 in out 1k C1 out 0 {CV} .AC DEC 20 10 1MEG .STEP PARAM CV 10n 100n 30n .PLOT AC VDB(out) .END
.STEP 行告诉仿真器:电容取十、四十、七十、一百纳法四档,交流分析跑四遍,输出四条滚降曲线画在同一张图上。截止频率与电容成反比,四条曲线的转折点依次左移,从约十六千赫滑到一点六千赫——一张图看完整个设计空间的走向,选值时哪个组合兼顾带宽与面积,一目了然。
主流方言都支持这一机制,语法细节略有出入:有的写成 .STEP PARAM CV LIST 10n 47n 100n(列表式),有的支持在器件行直接内联 .STEP。开源的 ngspice 若版本不支持该语句,用 .control 里的循环加 alterparam 也能达成同样效果——写法如下,逻辑与蒙特卡洛一节的循环完全同构:
.control foreach cv 10n 40n 70n 100n alterparam CV=$cv reset ac dec 20 10 1meg end plot db(v(out)) .endc
图:参数扫描把一次分析展开成一族曲线
组合拳:库的雏形
把三件套连起来,你就拥有了自建元件库的全部技术:.SUBCKT 打包电路、param 暴露配置、.PARAM 统一全局数值、.STEP 做设计空间探索。典型组织是一个"公共定义区"加"调用区"的网表骨架——文件头部集中放着所有 .PARAM 与模型卡,正文只有几十行 X 调用。拿到别人的大型参考设计,先看它的定义区,调用区几乎不需要读;反过来,你自己交付网表给别人时,这个结构能让对方在最短时间内看懂可调之处在哪里。
💡 判断网表工程化的成熟度有个速查口径:全文搜裸数字。满屏的都是一次性脚本;数字几乎全被参数名替代、电路块全部 X 化的,是可维护的工程文件。这两类文件的修改成本,差着十倍不止。
本节要点回顾
- 两端协议:定义端声明端子,调用端 X 引用;压扁发生在求解前,层级零求解开销。
- 参数命名:同一数字出现两次以上就该 .PARAM 化,花括号表达式支持派生数值。
- .STEP 扫设计空间:一条语句展开一族曲线,选型决策从"猜"变成"看"。
- 库的雏形:定义区加调用区的网表骨架,是读懂与交付大型参考设计的通用格式。
积木有了、参数化了,还差最常用也最贵的那块积木:运放。下一节用行为级源手搓一个带带宽与压摆率的运放宏模型。
问题:子电路参数与全局参数重名了怎么办
方言的处理规则略有差异,但方向一致:子电路内部的形式参数优先于全局定义。这带来了一个好处——库作者可以放心用通用名字做局部参数,不必担心污染调用方;也带来一个坑——全局参数"悄悄失效"时的排查,需要检查子电路定义行有没有同名形式参数。写库的第一条纪律由此而来:全局参数加前缀区分用途,冲突从命名上杜绝。
问题:压扁之后还能看层次化的仿真结果吗
多数现代工具支持层次化的波形命名与结果分组:压扁只发生在求解的矩阵层面,结果数据仍按层次归档,可以直接查看某一级子电路内部的电流。这让"顶层调参、下层定位"的双层工作流成为可能——先在顶层扫描发现指标偏了,再下钻到具体子电路看哪个器件越界,效率远高于在平网表里大海捞针。
问题:.STEP 与蒙特卡洛是什么关系
扫描是确定性的取样:参数按你指定的序列取值,适合看趋势与极端点;蒙特卡洛是随机的取样:参数按分布抽样,适合估良率。两者共享同一套参数化基建,甚至可以组合——对每个工艺角跑一轮蒙特卡洛,是统计验证的标准姿势。记住先后次序:先扫描找到敏感方向,再蒙特卡洛量化散布,顺序反了会浪费大量算力。
动手实验单
三个递进练习把本节焊牢:把 RC 低通子电路改造成带截止频率参数的版本,用参数调用实例化出两档规格;给第 4.3 节的共源放大器做负载电阻扫描,从一千欧扫到一万欧,观察增益与带宽的此消彼长;用 .control 循环实现一次双参数组合扫描,体会脚本化扫描的自由度。做完这三步,你的网表才算从"能跑"升级为"可复用"。