4.2 神经解码:从尖峰到刺激
4.2 神经解码:从尖峰到刺激
上一节把码本立好,本节做翻译:给定一段尖峰序列,反推出它对应的刺激。解码不只是应用技术——它同时是最严格的编码假设检验器:你声称信息在时序里,那就构造一个专门读时序的解码器,读得出来才算数。本节从最常用的描述统计(PSTH、光栅图)走到线性与贝叶斯解码器,并解释它们与第 8 章脑机接口的连续谱关系。
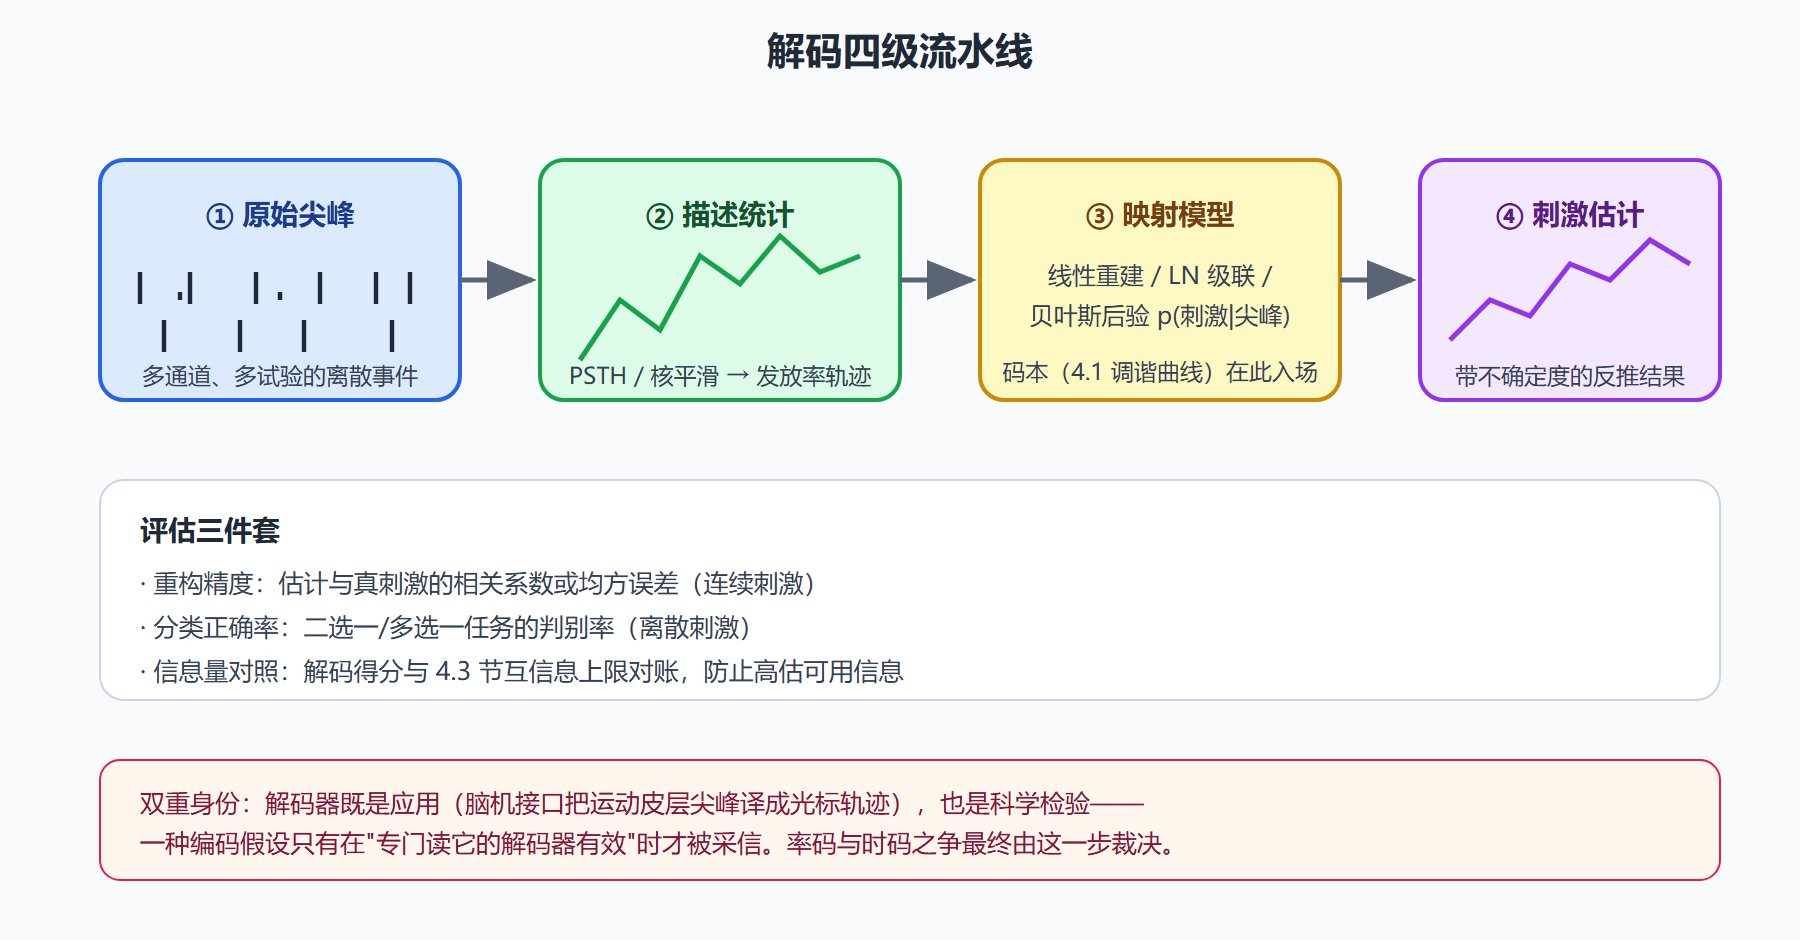
第一步:把原始尖峰整理成可读形式
拿到一段记录,先做两张标准图。光栅图(raster):每次重复试验占一行、每个脉冲一个点,几十行叠起来,刺激锁定的模式直接显形。刺激后时间直方图(PSTH):把所有试验按时间对齐后数柱状密度,等于对光栅做纵向平均,得到随时间变化的发放率估计。两张图回答的问题不同:光栅看试验间变异性(同样刺激下每次发放都一样吗——这本身就是信息),PSTH 看平均趋势。
实践要点在 bin 宽的选择:bin 太细(1 ms)每个格子脉冲数太少、统计噪声淹没趋势;bin 太粗(50 ms)把快速瞬态抹平。常用折中是 5 至 20 ms,或者用核平滑(对每个脉冲放一个高斯核再求和)代替硬分箱——核宽的角色与 bin 宽相同,但曲线连续、无分箱伪影。
线性解码:一根反向滤波器
最常用的解码器假设:刺激是尖峰序列的线性泛函加噪声。以时间维度的线性重建为例,估计的刺激 ŝ(t) = Σ Σ w(τ)·k 次试验在 t−τ 处的脉冲。权 w 通过最小均方误差从训练数据学出。这个"反向相关"方法在视网膜上效果惊人:对白噪声刺激,用一组视神经节细胞的尖峰反向卷积,重建出的图像肉眼可辨——视网膜上的线性解码告诉我们,至少对这类刺激,视网膜已把大部分非线性处理做在了上游。
线性解码器的适用判据值得写进肌肉记忆:刺激分布接近高斯、系统近似线性时它接近最优;分布偏斜(自然影像、稀疏事件)或系统强非线性(阈值、饱和)时,需要在前端加静态非线性 ŝ = f(线性项),即所谓 LN 级联——这就把模型接到第 2 章 LIF 的非线性骨架上了。
图:解码流水线——从原始尖峰到刺激估计的四级处理
贝叶斯解码:把不确定度一并算出
线性解码给出点估计,贝叶斯解码给出整个后验分布 p(刺激 | 尖峰)。做法两步:先用码本建似然 p(尖峰 | 刺激)——群体 Poisson 假设下就是各细胞调谐曲线的乘积;再乘先验 p(刺激) 归一。后验的峰是估计值,峰的宽度是不确定度——解码器同时告诉你"我猜是 210 度"和"我有多确定"。大脑自身被广泛假设在做类似的概率计算(感知决策的贝叶斯脑假说),因此贝叶斯解码器还有一层对照意义:它的误差结构可与被试行为误差直接比较。
群体 Poisson 假设带来的维数灾难(细胞一多,联合似然无法枚举)有标准处理:假设各细胞条件独立,或对尖峰先做低维降维(因子分析、高斯过程隐变量)再解码。这些降维技术同时是第 7 章数据分析的主角——解码与数据预处理在方法上是同一套工具箱。
概念代码:贝叶斯方向解码
import numpy as np pref = np.arange(0, 360, 45) # 8 个细胞的偏好方向 f_max, f_base = 40.0, 5.0 # 峰值/基础发放率 Hz tbin = 0.2 # 200 ms 观察窗 def tuning(s): # 码本:余弦调谐 return f_base + f_max*np.cos(np.radians(pref - s))**2 spikes = tuning(210)*tbin # 真实方向 210 度下各细胞计数 candidates = np.arange(0, 360, 2) lam = np.stack([tuning(s)*tbin for s in candidates]) # 每个候选方向的期望计数 log_post = (spikes*np.log(lam)).sum(axis=1) - lam.sum(axis=1) # Poisson 对数似然 post = np.exp(log_post - log_post.max()); post /= post.sum() print("最优估计:", candidates[post.argmax()], "度") print("后验宽度(度):", round(np.sqrt((post*(candidates-candidates[post.argmax()])**2).sum()),1))
把尖峰计数改成第 4.1 节那种带噪声的版本重跑:估计值仍在真值附近,后验宽度随噪声增大——解码器"知道自己不知道"。这种自带不确定度的性质是它在临床解码(如意图识别)里被优先选用的原因。
⚠️ 常见坑:解码正确率高不等于找到了大脑的编码方案。解码器可以使用大脑不用的信息(如试验间相关噪声),也可能读不出大脑在用的信息(码本设错)。所以解释顺序必须反过来:先用解码确定"信息在不在",再用受控实验确定"大脑怎么用"。
💡 关键直觉:解码是编码假设的单元测试。每提出一种编码方案,配一个它专属的解码器;读得出来,假设晋级;读不出来,要么码本错,要么信息真的不在这个通道——两种结论都有价值。
本节要点回顾
- 要点一:光栅与 PSTH 是解码的第一步,核平滑优于硬分箱。
- 要点二:线性解码是高斯线性世界的最优解,加静态非线性即 LN 级联。
- 要点三:贝叶斯解码输出后验,估计与不确定度一并给出。
- 要点四:条件独立与低维隐变量是群体解码对抗维数灾难的两大手段。
- 要点五:解码成功是必要证据而非充分证据——先证"在不在",再证"怎么用"。
翻译器有了,但还缺一把标尺:这条通道到底装了多少比特?下一节请出信息论。
案例:从实验室解码到神经假体的一次完整对账
把 4.2 的流程走成一个工程案例。运动 BCI 的标准闭环:被试想象手腕移动,运动皮层约一百个电极通道的脉冲被实时读出;解码器先把这些脉冲投影到低维隐状态(对应 7.2 的降维),再用卡尔曼类滤波把隐状态映射为光标速度;光标运动的视觉反馈回到被试眼中,形成闭环。训练流程体现用户在环思想——解码器参数先用手肘追踪数据初始化,再让被试带着反馈操作数天,其间系统在线微调;被试的皮层也在"学解码器",两周后想象手臂的操作已接近真实手臂的直觉程度。这个案例里 4.2 的每件工具(光栅看信号质量、PSTH 定调谐、贝叶斯解码给不确定度)都在生产线上各就各位——解码理论的工程验收,就是这么完成的。
问题:解码器的"信息泄漏"问题是什么?
指解码器可能利用了与神经编码无关、却与刺激相关的伪线索。典型如试验间刺激顺序带来的慢漂移:解码器学会读漂移而非读神经表征,交叉验证分数虚高。排查法是把刺激呈现顺序随机化、加入洗牌对照、以及在新数据采集日重新验证。报告解码结果时的专业格式是:任务维度、数据量、校准与测试的分离方式三项缺一不可——这既是 4.2 的纪律,也是审稿视角下判断一个解码研究可信度的最快通道。