第 1 章 · 01 AirLLM 定位与"显存只需一层"原理
第 1 章 · 01 AirLLM 定位与"显存只需一层"原理
本节摘要:AirLLM(作者 Gavin Li,Apache 2.0 协议,当前 v3.2.0,PyPI 包名
airllm)解决一个极端问题——在没有足够显存的机器上推理超大 LLM:70B 模型跑 4GB 显卡、Llama 3.1 405B 跑 8GB、DeepSeek-V3 671B 跑约 12GB、Kimi K3 2.8T 跑 4GB 以内,而且不量化、不蒸馏、不剪枝。它的核心魔术只有一句话:层级权重流式(layer streaming)——每次只在 GPU 上保留一层,transformers 照常驱动 forward,AirLLM 用 PyTorch hook 管理每个模块权重"磁盘→CPU→GPU→meta"的完整生命周期。本节是全书"逐层之旅"的出发前俯瞰:把宣传数字翻译成一条可推导的数学式,把魔术拆成三个可读的机制。
内容来源:原项目源码
air_llm/airllm/airllm_base.py、README.md
⚠️ 注意:AirLLM 买到的是"能跑"与"极低显存",不是"快"——瓶颈在磁盘带宽,token 生成速度在 0.1-2 token/s 量级。它适合离线批处理、长文本生成、RAG 索引构建,不适合交互式对话。这个"诚实的代价"在 1.2 节正面展开,此处先立此存照。
学习目标
- 说清 AirLLM 的定位、作者、协议、版本与安装方式。
- 把宣传数字(70B@4GB/405B@8GB/671B@12GB/K3@4GB)还原成"显存需求 = 单层大小"的推导。
- 用一句话讲清层级权重流式:transformers 正常 forward,AirLLM 挂 hook 管权重生命周期。
- 理解"不量化、不蒸馏、不剪枝"的克制,以及它与其他低显存方案的边界。
- 梳理 2023/11 至 2026/08 的版本脉络,知道每个里程碑对应源码中的哪个机制。
- 记住算法源头:Kaggle 比赛中 SimJeg 的层流式加载工作。
旅程坐标

本节位于旅程出发前的俯瞰点:尚未启程,先把整条"磁盘→CPU→GPU→meta"流水线看成一个整体——后续每一章都是这条线上某一段的放大镜。
一、AirLLM 是什么:为"显存不足"而生的推理 wrapper
先感受它解决的问题有多极端。想在 fp16 下常规推理一个 70B 模型,需要约 137GB 显存——两张 A100 80G 勉强;405B 需要约 810GB——一台八卡机满载;671B fp8 也要约 700GB。而消费级显卡是 4GB-24GB 的世界,工作站也不过 48GB。数量级的三重落差(模型权重 vs 显卡容量,推理需求 vs 训练残骸,开源模型的膨胀速度 vs 硬件迭代速度)把"在自己机器上跑超大模型"变成了一句空话。云上租卡当然是出路,但调试、离线处理、隐私敏感数据、教学场景都指向同一个诉求:本地、低配、要能跑。
README 开篇一句话给出定位(README.md:9):让 70B 大模型跑在单张 4GB 显卡上——without quantization, distillation, or pruning(不量化、不蒸馏、不剪枝)。更进一步:405B 跑 8GB,DeepSeek-V3(671B)跑约 12GB,已开源的最大模型 Kimi K3(2.8T)跑 4GB 以内——因为稀疏 MoE 模型每次只流式加载一个专家,而不是一整层。
它的身份信息:
- 作者:Gavin Li(lyogavin),Anima 中文大模型项目的作者;
- 协议:Apache 2.0,可自由商用与修改;
- 版本:本教程对照 v3.2.0(2026/08 快照),PyPI 包名
airllm,pip install airllm即装; - 形态:不是一个新的推理引擎,而是 transformers 之上的一个薄 wrapper——
AirLLMBaseModel(airllm_base.py:57)包住 HF 的*ForCausalLM模型,模型本身的 forward/generate 逻辑一行不改。
这个"薄 wrapper"定位是理解全书的钥匙。类文档字符串(airllm_base.py:58-70)写得很直白:checkpoint 在磁盘上按层切成分片;真正的 transformers 模型在 meta 设备上实例化(零显存占用),并拥有完整的 forward/generation 逻辑;AirLLM 只给每个大模块(embedding、每个 decoder 层、最终 norm、lm_head)挂 forward hook,在该模块运行前把权重从磁盘流上 GPU、运行后立即释放;再用一个 worker 线程预取下一个模块。因为 forward 由 transformers 驱动,AirLLM 不需要追踪每种架构的 attention/rotary/cache 细节——transformers 支持的新架构,AirLLM 开箱即用。
二、宣传数字的原理:显存需求 = 单层大小
README 的模型对照表(README.md:284-292)值得逐行读:
| 模型 | 规模 | GPU 显存 |
|---|---|---|
| Qwen3 / Mistral / Phi(约 8B) | 8B | 约 1-2 GB |
| Qwen3-30B / Mixtral(MoE) | 30-47B | 约 1-3 GB |
| Qwen3.8-27B(dense VL) | 27B | 3.33 GB |
| Qwen3-235B(MoE) | 235B | 约 3 GB |
| Llama 3.x 70B(全精度) | 70B | 约 4 GB |
| Llama 3.1 405B | 405B | 约 8 GB |
| DeepSeek-V3 | 671B | 约 12 GB |
表格上方那句话是全部秘密(README.md:282):AirLLM 任意时刻只在 GPU 上保留一层,所以你需要的显存取决于模型单层的大小,而非模型总大小。推导只需三步:
- 常规推理要把全部权重驻留显存:70B 模型 fp16 约 140GB,一张消费级卡想都别想;
- decoder-only 模型的 forward 是严格的串行链:
embed → layer 0 → layer 1 → … → layer N-1 → norm → lm_head,第 k 层算完,它的权重在后续整个前向里再也不会被用到; - 于是"驻留"可以降级为"到站即上、离站即下":显存峰值 ≈ 单层权重 + 激活值 + KV cache,而单层只占总权重的约 1/(层数+3)。70B 有 80 层,单层 fp16 约 1.6GB——4GB 卡正好装下;405B 有 126 层,单层约 6.4GB——8GB 可容;671B(fp8 存储)单层更大,需要约 12GB。
把这条式子写成一行:
显存需求(常规) = W(总权重) 70B → 约 137GB 显存需求(AirLLM) = W / (层数 + 3) + 激活 + KV cache 70B → 约 1.6GB + 零头
分母里的"+3"是 embed、norm、lm_head 三个序列外模块(它们也被流式)。注意这是量级的坍缩而非线性的节省:层数越多坍缩越狠——这解释了为什么模型越大,AirLLM 的宣传数字反而越"离谱"。
MoE 模型还有第二级杠杆:Kimi K3 每层 896 个专家,每个 token 只路由到 16 个(airllm_kimi_k3.py:13-15)——展开的专家层约 55GB,而一个 token 真正触碰的只有约 1GB。按专家流式让 2.8T 模型压进 4GB,这是第 5 章的主题。
三、核心魔术一句话:hook 管理的权重生命周期
把上面的原理压缩成一句可操作的话:transformers 正常 forward,AirLLM 挂 hook 做磁盘→GPU→meta 的权重生命周期管理。展开成四个时刻:
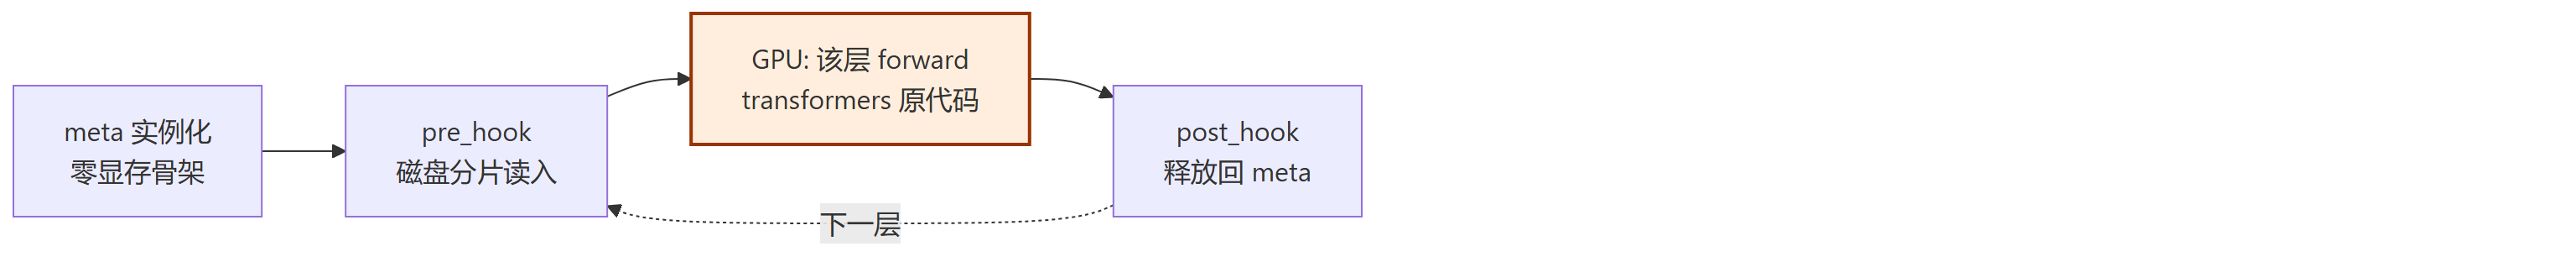
- t0(实例化):用
accelerate.init_empty_weights在 meta 设备上建出结构完整但零字节数据的模型(第 3.1 节); - t1(pre_hook,某层执行前):从磁盘的按层 safetensors 分片读出该层权重,搬上 GPU(第 3.2 节);
- t2(该层 forward):GPU 上正常计算,transformers 的模型代码毫不察觉;
- t3(post_hook,该层执行后):立刻把该层权重释放回 meta 设备,显存归还,给下一层腾位置(第 3.2 节)。
这个循环对每层重复,直到 lm_head 输出 logits。配合 worker 线程预取,第 N+1 层的磁盘读取与第 N 层的 GPU 计算重叠(第 4 章)。全书的主线图——"磁盘→CPU→GPU→meta"——就是这条时间轴。
三个角色分工清楚得像一场默剧:transformers 是司机(决定何时执行哪个模块、怎么生成 token),磁盘分片是仓库(第 2 章把 HF checkpoint 重组成一层一文件),AirLLM 的 hook 是搬运工(只在模块进出场的两个时刻出现)。司机和仓库互不知道搬运工的存在——这份"互不知情"正是 AirLLM 能用 2700 行核心代码撬动 2.8T 模型的原因,也是第 3 章要反复咀嚼的"零侵入"美学。
四、不做量化/蒸馏/剪枝的克制
低显存跑大模型的传统路径无外乎三招:AQLM/GPTQ 之类量化、教师-学生蒸馏、结构化剪枝。它们都在改变权重本身,精度与工程成本随规模上升。AirLLM 的选择是把问题完整搬运到 IO 域:权重一个比特都不动,只是不再一次性装进显存。对比:
| 方案 | 改变权重? | 显存下限 | 精度损失 | 主要代价 |
|---|---|---|---|---|
| 量化(int4/fp8) | 是 | 权重量化后总大小 | 有(可控) | 需量化工具链与校准 |
| 蒸馏/剪枝 | 是(重训练) | 小模型大小 | 有(任务相关) | 训练成本巨大 |
| ZeRO/Offload 类 | 否 | 单层+状态 | 无 | 换入换出策略复杂 |
| AirLLM 层级流式 | 否 | 单层(+KV cache) | 无(同 dtype) | 磁盘带宽成为瓶颈,速度慢 |
"不改权重"带来一个容易被低估的副产品:输出与全精度常驻推理理论上逐位一致(同 dtype、同 kernel 前提下)——它不是近似的低配版,而是同一台机器换了个取权重的方式。调试、验证、复现超大模型行为时,这个性质比省下的显存更珍贵。
克制还体现在一处容易忽略的细节:AirLLM 后来也加了 compression='4bit'/'8bit' 选项,但定位很清楚(README.md:161-165)——常规量化要同时量化权重与激活才能加速计算,精度难保;而 AirLLM 的瓶颈在磁盘加载,所以只量化权重、只为缩小读放量,精度几乎无损,速度提升最多 3 倍。这是"为 IO 而量化",与"为计算而量化"是两件事,第 6 章专门辨析。
五、历史脉络:从 Kaggle 比赛 到 v3.2.0
README 的 Updates 区(README.md:33-62)几乎是一份低显存推理的编年史,整理成表:
| 时间 | 版本/事件 | 机制关键词 | 对应本教程 |
|---|---|---|---|
| 2023/11/20 | 初版 | meta + hook 层流式,仅 Llama2 | 第 3 章全部 |
| 2023/12/01 | v2.0 | 4bit/8bit 压缩,3 倍提速 | 第 6 章 |
| 2023/12/02 | — | safetensors 支持,开源榜前十模型全通吃 | 第 2 章 |
| 2023/12/18 | v2.5 | 预取:IO 与计算重叠,提速 10% | 第 4.1 节 |
| 2023/12/20 | v2.6 | AutoModel 自动识别模型类型 |
第 1.2 节/第 7 章 |
| 2023/12/25 | v2.8.2 | macOS 跑 70B(MLX 后端) | 第 7 章 |
| 2024/07-08 | — | Llama3.1 405B;CPU 推理;非分片模型 | 第 2 章 |
| 2026/06 | v3.0 | FP8 支持;DeepSeek-V3 671B@12GB;统一 AutoModel | 第 6 章 |
| 2026/07 | — | Kimi K3(2.8T)按专家流式,3.72GB 实测 | 第 5 章 |
| 2026/08 | — | Qwen3.8-27B(原生视觉,3.33GB) | 第 7 章 |
脉络的走向很清晰:机制越来越通用,架构特殊代码越来越少——从只支持 Llama2,到"transformers 支持即支持"。每一次机制升级(v2 压缩、v2.5 预取、v3 FP8)都不改变第 3 章的流式主干,只在其上叠加;这正是"主干极简 + 增量正交"架构方针的回报。
另外必须记录源头(README.md:296-302):大量代码基于 SimJeg 在 Kaggle LLM Science Exam 比赛中的出色工作——用层流式在有限显存里跑 Platypus2-70B 做 RAG 问答。AirLLM 把比赛里的生存技巧,锤炼成了通用开源库;这份"从竞赛代码到基础设施"的演化路径,本身就是一个开源工程的样本。
💡 旅程要点:本节建立了全书的两个心智坐标。第一,数学坐标:显存需求从"模型总大小"降到"单层大小",70B→4GB、405B→8GB、671B→12GB、K3→4GB 全是这一条式的推论;第二,机制坐标:transformers 驱动 forward 不动分毫,AirLLM 只在 meta 实例化 + pre/post hook 两个时刻介入权重生命周期。后续所有章节——切分、hook、预取、专家流式——都是这两个坐标的展开与加速。
本节要点回顾
- AirLLM:Gavin Li 作,Apache 2.0,v3.2.0,
pip install airllm;transformers 之上的薄 wrapper,非独立引擎。 - 宣传数字的统一解释:任意时刻 GPU 只留一层,显存 ≈ 单层权重 + 激活 + KV cache;70B 单层约 1.6GB 所以 4GB 可跑。
- 核心魔术一句话:transformers 正常 forward,AirLLM 挂 hook 做"磁盘→CPU→GPU→meta"的权重生命周期管理。
- 不量化、不蒸馏、不剪枝:权重零改动,代价完整转移到磁盘带宽;后来的 compression 是"为 IO 而量化",只为缩小读放量。
- 版本脉络:2023/11 初版→v2 压缩→v2.5 预取→v2.6 AutoModel→2026 v3.0 FP8→K3 按专家流式;趋势是架构特殊代码趋零。
- 算法源头:Kaggle LLM Science Exam 中 SimJeg 的层流式加载工作。
下一节:
02 monorepo 结构与速度的诚实代价——走进仓库本身:air_llm 核心包约 2695 行的文件地图、Anima 训练侧的版图,以及那个必须诚实面对的问题:它到底有多慢,慢在哪,适合谁。