第 1 章 · 02 monorepo 结构与速度的诚实代价
第 1 章 · 02 monorepo 结构与速度的诚实代价
本节摘要:这个仓库是一个 monorepo:一边是 air_llm 核心包(约 2695 行)——836 行的
airllm_base.py心脏、556 行的utils.py切分流水线、436 行的 macOS MLX 后端、62 行的auto_model.py调度器,加上十余个总共只有几十行的模型薄壳;另一边是作者更早的 Anima 训练项目(约 3900 行,training/rlhf/anima_100k/data/eval 五个目录),QLoRA 训练 33B 中文大模型加 DPO 对齐。本节画出完整的代码版图,然后正面回答那个绕不开的问题:AirLLM 到底有多慢——瓶颈在磁盘带宽,约 0.1-2 token/s 量级,它适合离线批处理、长文本生成、RAG 索引构建,不适合交互对话。最后用 Quickstart 的五行代码收束:上手成本几乎为零。
内容来源:原项目源码
air_llm/airllm/(全目录)、README.md
⚠️ 注意:首次运行会先离线切分模型(按层重写 safetensors 分片),非常吃磁盘——需要约等于模型大小的额外空间;README 的 FAQ 第一条(MetadataIncompleteBuffer 报错)最常见的成因就是磁盘爆了。磁盘预算的细节在第 2 章展开。
学习目标
- 画出 monorepo 顶层版图:air_llm 核心包 + Anima 训练侧五目录。
- 背下核心包文件地图:
airllm_base.py/utils.py/airllm_llama_mlx.py/auto_model.py/薄壳们各管什么。 - 理解"薄壳子类"模式:新模型支持常常只是一个改写
layer_names_dict的十几行类。 - 说清速度代价的物理根源:每生成一个 token 都要读完整套权重,瓶颈是磁盘带宽。
- 判断 AirLLM 的适用场景与不适用场景。
- 用五行 Quickstart 代码跑起一个 70B 模型。
一、monorepo 顶层:推理核心与训练遗产同居
仓库根目录一分为二。推理侧是 air_llm/,其中 air_llm/airllm/ 是核心包,air_llm/examples/ 放着三个 notebook(跑 405B、macOS、全模型类型演示)。训练侧是 Anima 项目的遗存:
training/qlora.py(847 行):QLoRA 微调 33B 模型的完整训练脚本;rlhf/qlora_dpo.py(923 行):DPO 对齐训练;anima_100k/:100K 长上下文相关,含modeling_flash_llama.py(Flash Attention 改写的 Llama 建模);data/与eval/:数据构建与评测脚本。
训练侧合计约 3900 行,与 AirLLM 推理核心没有代码依赖——它们是同一作者的连续工作:先用 QLoRA 训出 Anima(33B 中文大模型),再回头解决"训得起也未必推得起"的问题。两边的张力本身就构成一组时代注脚:训练侧在攻"怎么训得起"(QLoRA 把 33B 微调塞进单卡),推理侧在攻"怎么推得起"(层级流式把 70B 推理塞进 4GB)——合起来是一份完整的"低资源大模型实践"拼图。Anima 的 README 本身是中文写的,第 7 章作为番外详读。
值得一提的是根目录的 README_ja.md(日文版 README)与 funding.json——这个项目的国际社区活跃度,从侧面解释了它为何能以 2700 行核心跟上 2023 到 2026 每一波模型发布。
二、核心包文件地图:约 2695 行各就各位
先给一个自上而下的调用全景,再逐文件过一遍(行数为实测):
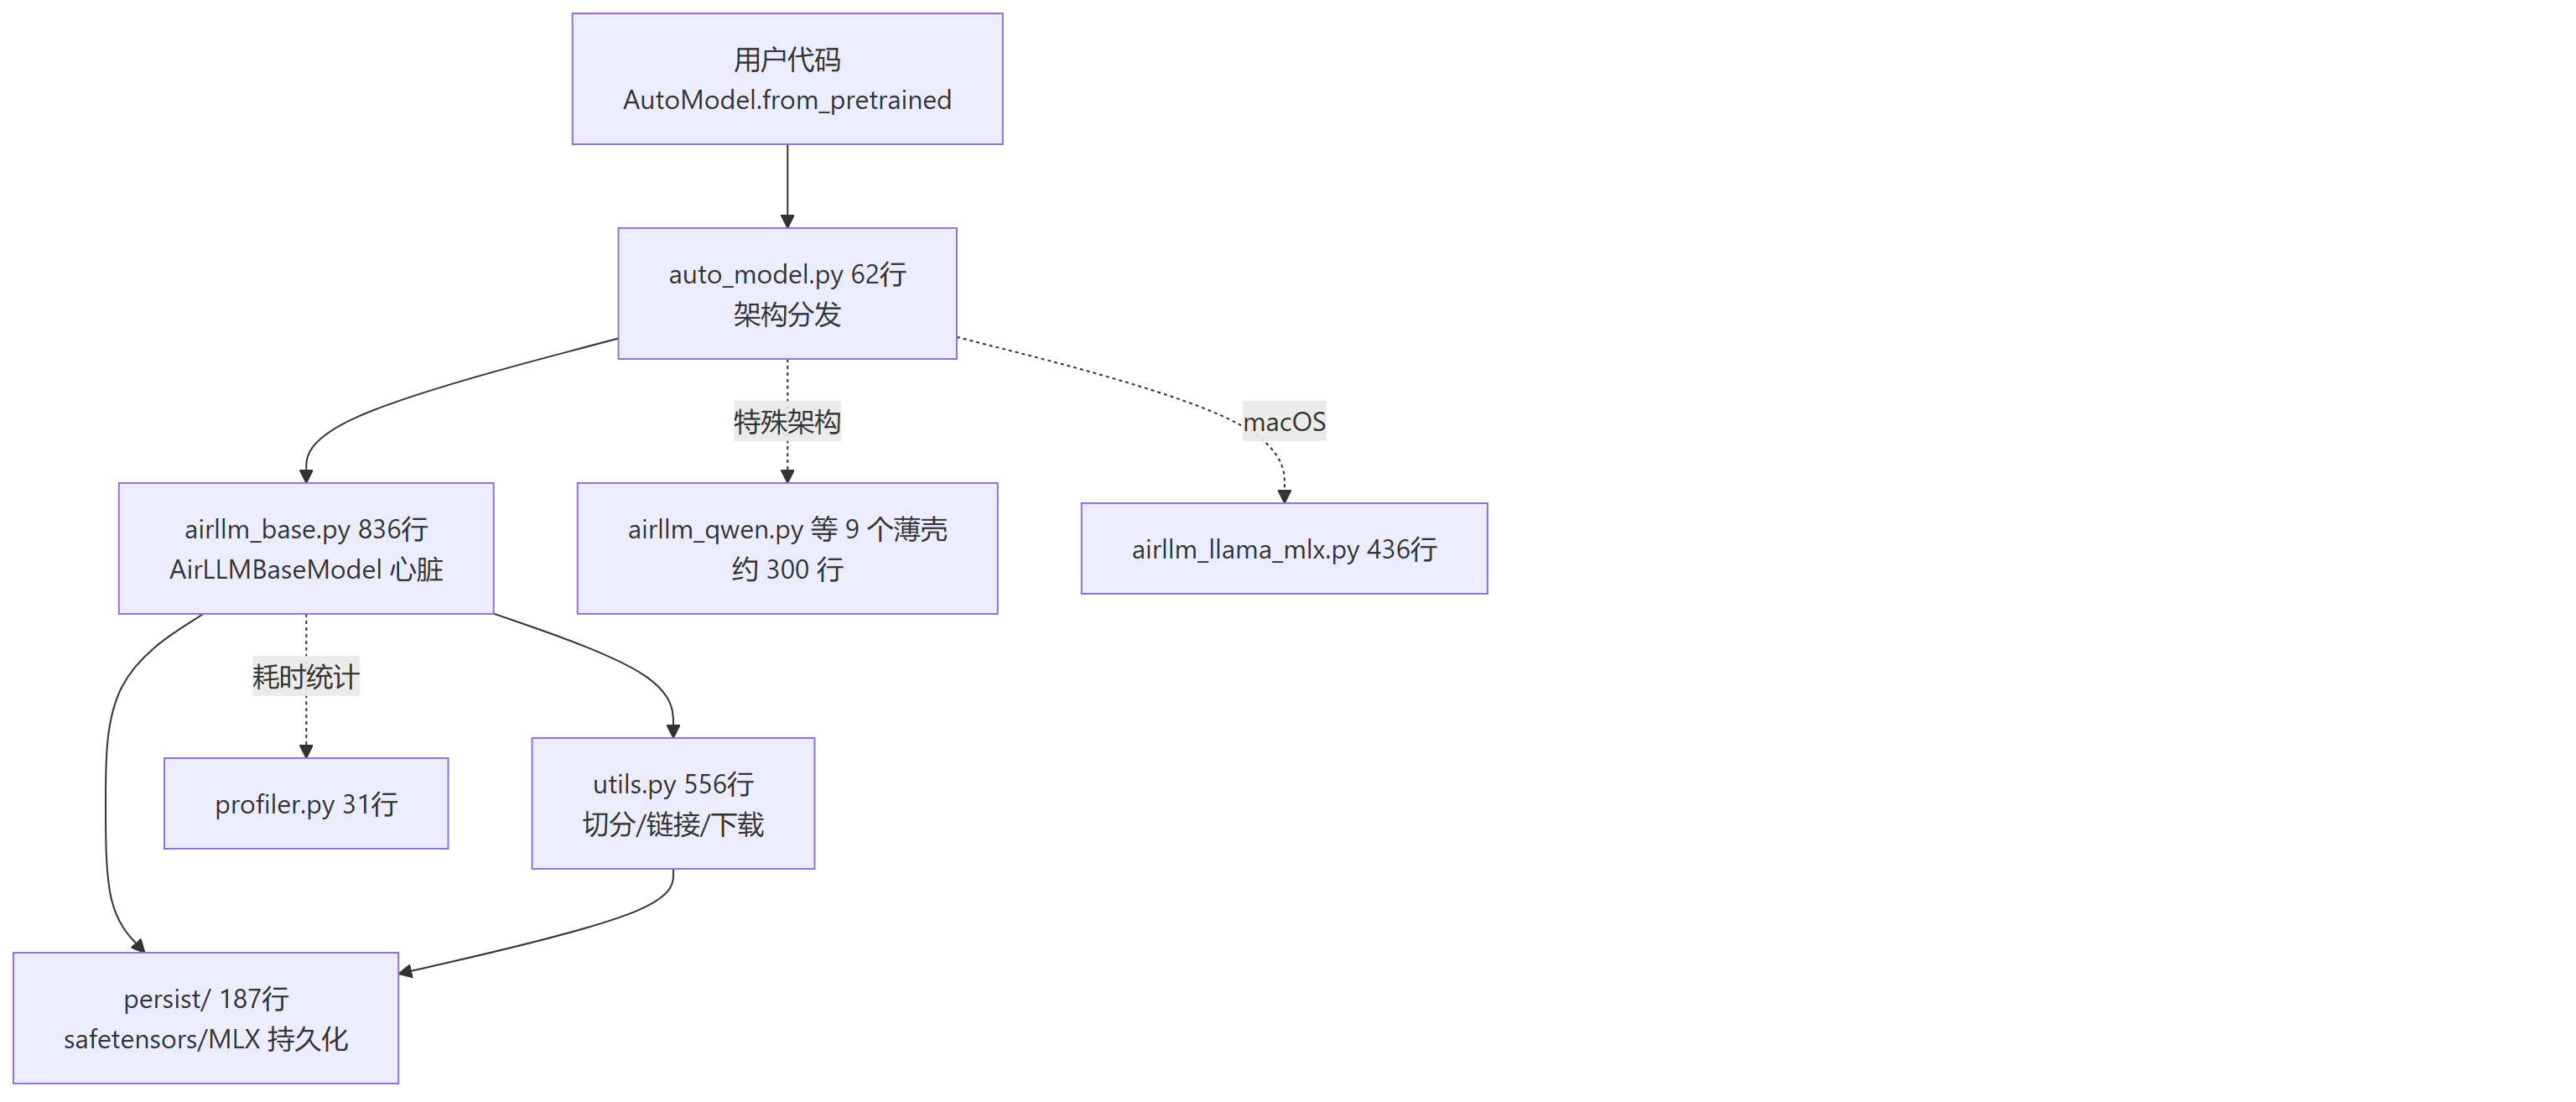
| 文件 | 行数 | 职责 |
|---|---|---|
airllm_base.py |
836 | 全库心脏:AirLLMBaseModel——meta 实例化、流式 hooks、预取、量化兼容 |
utils.py |
556 | 离线切分流水线 split_and_save_layers、硬链接、空间检查、量化压缩 |
airllm_llama_mlx.py |
436 | macOS MLX 后端(Apple silicon 统一内存) |
tokenization_baichuan.py |
251 | Baichuan 分词器适配 |
airllm_chatglm.py 等 9 个薄壳 |
20-56 | 特殊架构的模块名覆写 |
auto_model.py |
62 | AutoModel 架构分发 |
profiler.py |
31 | LayeredProfiler 分层耗时统计 |
airllm.py |
10 | AirLLMLlama2,最薄的壳 |
persist/(3 个文件) |
187 | safetensors/MLX 两种持久化器 |
三个关键观察:
第一,心脏极小。836 行的 airllm_base.py 承担了 1.1 节那句"核心魔术"的全部运行时:meta 实例化(第 3.1 节)、_install_streaming_hooks/_pre_hook/_post_hook(第 3.2 节)、预取(第 4 章)、FP8/MXFP4 解包(第 6 章)。对照动辄数万行的推理框架,这是"最小侵入式挂载"的极端示范。
第二,薄壳模式。看最薄的 airllm.py(全文 10 行):
from .airllm_base import AirLLMBaseModel class AirLLMLlama2(AirLLMBaseModel): def __init__(self, *args, **kwargs): super(AirLLMLlama2, self).__init__(*args, **kwargs)
Llama2 与基类零差异——因为基类默认的模块名(model.embed_tokens/model.layers/model.norm/lm_head)就是 Llama 家族的布局。需要薄壳的是模块名不标准的架构,如 QWen 老版本用 transformer.wte/transformer.h(airllm_qwen.py:27-31),只需覆写 set_layer_names_dict。最"厚"的 Kimi K3 薄壳也只有 32 行(airllm_kimi_k3.py:18-32):换模块路径、声明 expert_prefix、列出常驻的视觉塔——其余全部继承。
第三,调度入口。auto_model.py 的 ARCH_OVERRIDES 字典(auto_model.py:17-26)只列六个特殊架构(ChatGLM/QWen/Baichuan/InternLM/KimiK3/Qwen3.5),其余架构一律落到通用 AirLLMBaseModel——"transformers 支持即 AirLLM 支持"在第 7 章的 AutoModel 精读里展开。
还有一个不显眼但关键的子模块:persist/(三种持久化器,共约 187 行)。ModelPersister 定义"存一层/读一层/检查存在"的接口,SafetensorModelPersister 用 safetensors 实现(第 2 章的主角),MLXModelPersister 为 macOS 后端写 .mlx.npz。切分与加载都通过 ModelPersister.get_model_persister() 拿当前实现——格式差异被这层薄抽象隔离在核心逻辑之外。把文件地图连成一张调用关系图:
AutoModel.from_pretrained(repo_id) └─> AirLLMBaseModel.__init__ (airllm_base.py) ├─> find_or_create_local_splitted_path (utils.py) │ └─> split_and_save_layers (utils.py, 经 persist/ 落盘) ├─> init_model → _instantiate_on_meta (accelerate.init_empty_weights) ├─> set_layers_from_layer_names ├─> _load_resident_modules └─> _install_streaming_hooks ├─> _pre_hook ─> load_layer_to_cpu (utils.load_layer, 经 persist/ 读盘) └─> _post_hook ─> module.to('meta') + clean_memory
三、速度的诚实代价:瓶颈在磁盘带宽
现在直面代价。生成每个 token 都要执行一次完整 forward,也就意味着每生成一个 token,整套权重都要从磁盘流过一遍。算一笔账:70B 模型 fp16 约 140GB,普通 SATA SSD 顺序读约 500MB/s,读完一遍需约 280 秒;即便 NVMe(约 3-7GB/s)也要 20-45 秒。换算成 token 速度,就是 0.1-2 token/s 的量级——比常规显存内推理慢两到三个数量级。这不是实现不够好的问题,而是"显存换磁盘"这笔交易的物理价格。
所以 README 与本教程对适用场景的口径一致:
- 适合:离线批处理( overnight 跑一批长文档摘要)、长文本生成(单次生成摊薄加载成本)、RAG 索引构建(为海量语料批量做 embedding)、以及"没有大卡但想验证/调试/复现超大模型行为"的场景;
- 不适合:交互式对话、高并发在线服务——用户不会接受一个每秒吐 0.5 个字的聊天框。
一个帮助判断的经验法则:把你的任务换算成"要生成多少 token"。生成 1000 个 token,70B 模型在 NVMe 上大约要 10-30 分钟;如果这 1000 个 token 是一份夜间批处理报告的一部分,完全可以接受;如果是一个聊天回复,灾难。吞吐可以等,延迟不能等——AirLLM 属于吞吐可以等的那个世界。
速度并非毫无还手之力:4bit/8bit 压缩把读放量降为 1/4 到 1/2(README 实测最高 3 倍提速,第 6 章);预取流水线让 IO 与计算重叠(v2.5,约 10% 提升,第 4 章);FP8/MXFP4 打包传输再省 4 倍 PCIe 流量。但所有加速都改变不了"每 token 全量过盘"的本质——这就是为什么本教程反复强调:AirLLM 的产品定位是**"能跑"与"极低显存",不是"快"**。
顺带一提首次运行的总成本,给读者一个心理预期:以 70B 为例,首次初始化 = 下载约 137GB(视网络)+ 切分读写约 137GB(视磁盘,十几分钟到一小时);此后每次启动只需秒级的分片检查。这是"一次性门票",换来的是后续任意次的低显存推理。
四、Quickstart:五行代码跑 70B
README 的快速上手(README.md:100-137)浓缩到核心就是五行:
from airllm import AutoModel model = AutoModel.from_pretrained("Qwen/Qwen3-32B") input_tokens = model.tokenizer(['What is the capital of United States?'], return_tensors="pt", return_attention_mask=False, truncation=True, max_length=128) generation_output = model.generate(input_tokens['input_ids'].cuda(), max_new_tokens=20, use_cache=True, return_dict_in_generate=True) print(model.tokenizer.decode(generation_output.sequences[0]))
五行里藏着三段旅程:第一行经过 AutoModel.get_module_class 的架构分发(auto_model.py:37-51);第二行触发完整的初始化链——下载(或复用)checkpoint、离线切分、meta 实例化、挂 hooks(第 2、3 章的全部内容);第三五行则是普通 transformers 用法,generate 委托给内部的真模型(airllm_base.py:829-830),token 一个个生成的过程中,权重一层层循环"上卡-计算-下卡"。
两个新手常见坑也写在 FAQ 里(README.md:305-351):一是 ValueError: max() arg is an empty sequence——多半是把 QWen/ChatGLM 硬塞给了 AirLLMLlama2 类,模块名对不上;解法就是本例的 from airllm import AutoModel,让分发器选对薄壳。二是部分 tokenizer 没有 padding token——按例中 padding=False 关掉即可。这些报错的病根都会在第 3 章(模块名归一)与第 7 章(AutoModel 分发)里得到机制层面的解释。
常用配置项(README.md:167-176)一览:compression(4bit/8bit)、profiling_mode(输出分层耗时)、layer_shards_saving_path(切分输出另存他处)、hf_token(gated 模型)、prefetching(默认开)、delete_original(切完删原 checkpoint,省一半磁盘)。这六个旋钮贯穿后续各章。
💡 旅程要点:版图与价格是本节的两件行李。版图上,记住"836 行心脏 + 556 行切分 + 十几行薄壳"的同心圆结构——所有深水区都在
airllm_base.py与utils.py两个文件里,这本教程的九个主线小节几乎都在逐段读它们;价格上,记住"每 token 全量过盘"这七个字,它解释了 0.1-2 token/s 的量级、解释了为什么后续所有优化(压缩/预取/FP8)都在攻击读放量与重叠度,也解释了为什么 AirLLM 的正确用法是离线批量而非在线交互。
本节要点回顾
- monorepo:air_llm 核心包约 2695 行 + Anima 训练侧约 3900 行(training/rlhf/anima_100k/data/eval),后者与推理无代码依赖,第 7 章番外。
- 核心文件地图:
airllm_base.py836 行心脏、utils.py556 行切分、airllm_llama_mlx.py436 行 macOS、auto_model.py62 行调度、profiler.py31 行剖析、persist/持久化抽象。 - 薄壳模式:新架构支持通常只是覆写
set_layer_names_dict的十几行子类;AIRLLMLlama2是零差异空壳,Kimi K3 的 32 行是最厚的壳。 - 速度代价:每生成一个 token 全套权重过一遍磁盘,70B@fp16 约 140GB,SATA/NVMe 下 0.1-2 token/s;压缩、预取、FP8 都在缓解但无法消除。
- 适用:离线批处理、长文本生成、RAG 索引、超大模型验证;不适用:交互对话、在线高并发。
- Quickstart 五行:import AutoModel→from_pretrained(触发下载/切分/meta 实例化/挂 hooks)→tokenizer→generate(委托内部真模型)→decode。
- 六个配置旋钮:compression/profiling_mode/layer_shards_saving_path/hf_token/prefetching/delete_original。
下一节:进入第 2 章
01 HF checkpoint 分片格式与切分流水线——一层权重的"出生"仪式:HuggingFace checkpoint 的 index.json 长什么样,split_and_save_layers如何把它重组成一层一个 safetensors 文件。