- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:这是一部把网络数据采集当成"调度工程"来讲的 Crawl4AI 实战教程——你在调度室里接任务单、排班、派车、对抗封禁、守纪律、验货入库,最终为 AI 应用稳定供料。
这个教程解决什么问题
一次中等规模的模型微调,动辄需要几万条干净样本;一个上线的企业知识问答产品,背后是数千个站点的持续采集。真正卡住项目的,往往不是"能不能发出 HTTP 请求",而是:任务怎么定义、URL 队列怎么排、频控怎么设、反爬怎么应对、robots 协议怎么看、数据怎么清洗入库。这些问题散落在工程实践的各个角落,初学者常常是撞了墙才知道还有这道坎。
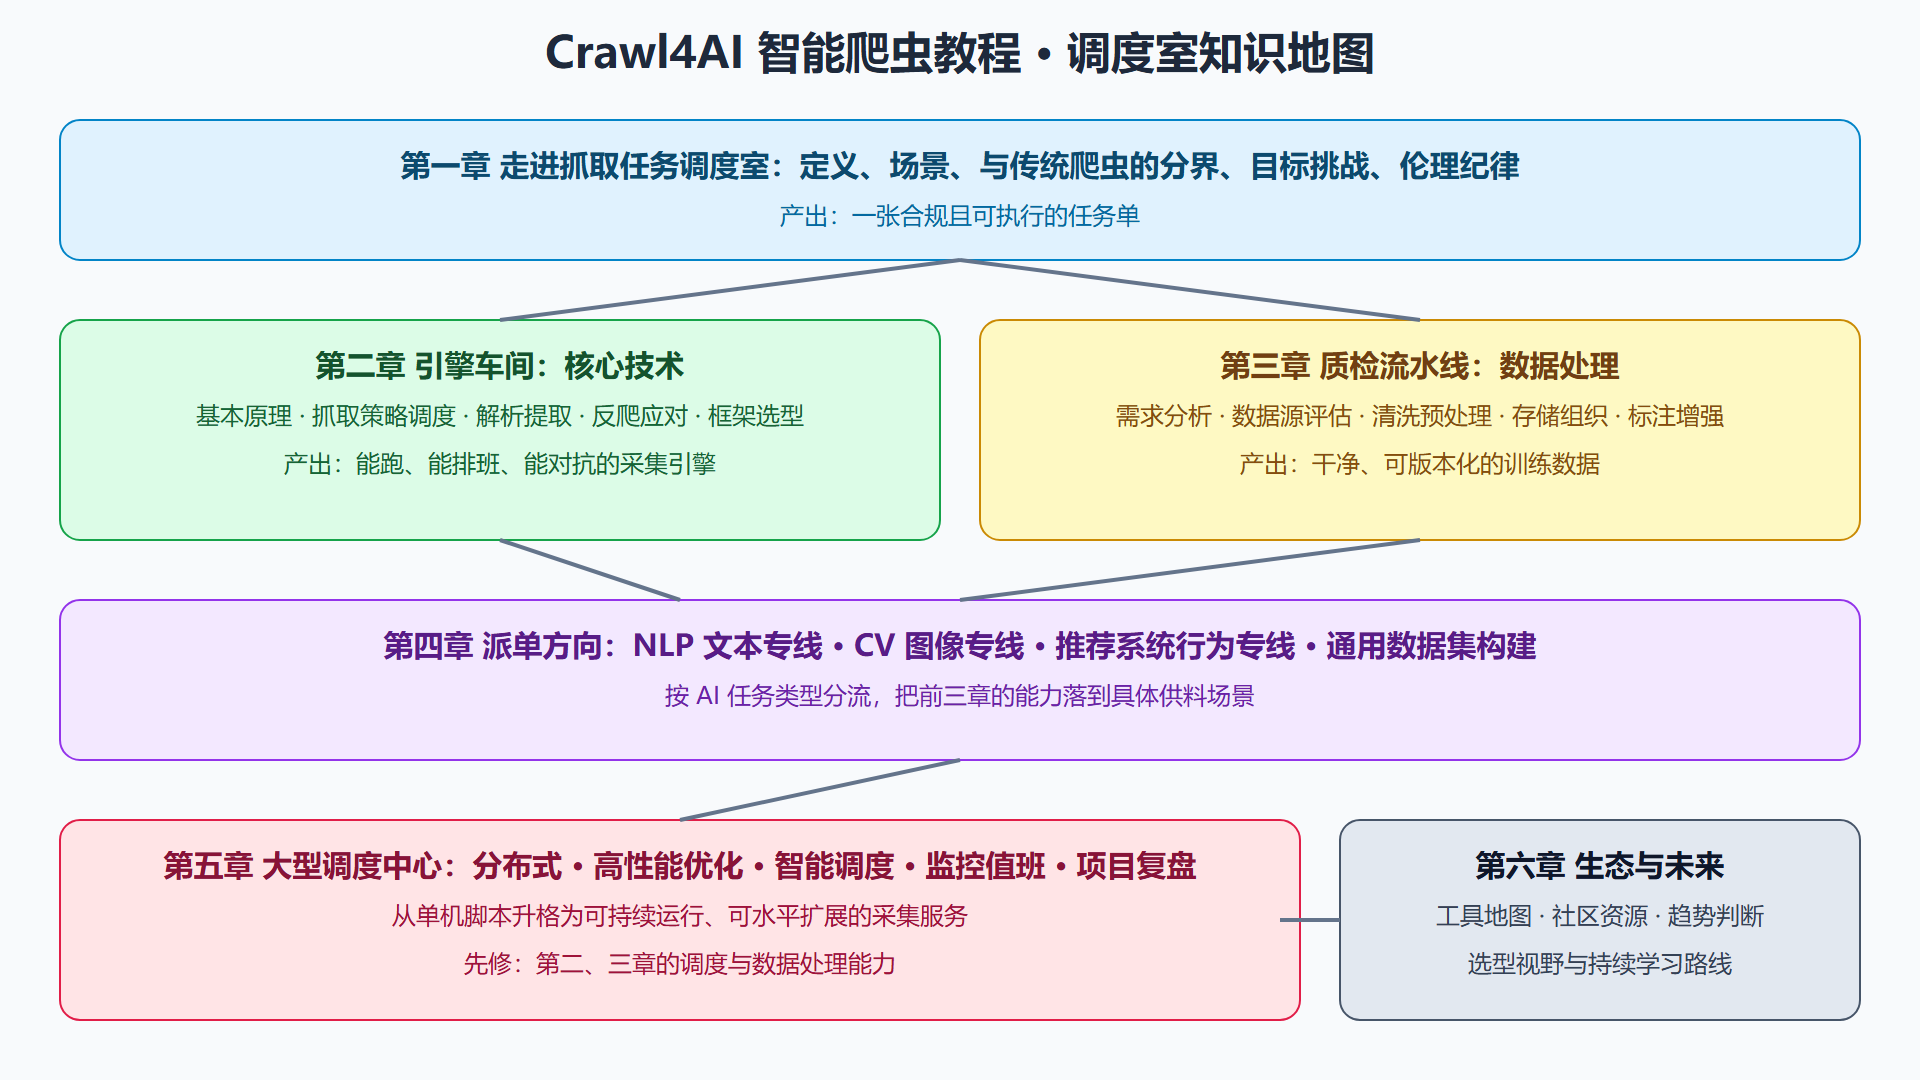
Crawl4AI 是一个为 AI 应用而生的开源爬取框架:内置真实浏览器内核、输出对大模型友好的 Markdown、支持结构化抽取与深度爬取策略。但工具只是调度室里的装备,能不能把活干好,取决于操纵装备的人懂不懂调度。所以本教程用了贯穿全册的组织方式——把每一章都安排在"抓取任务调度室"的一个具体岗位上:第一章领任务单,第二章进引擎车间,第三章管质检流水线,第四章看派单方向,第五章升格为大型调度中心,第六章走出调度室看生态。知识点不再是孤立的 API 清单,而是调度链条上环环相扣的工序。
我们对内容的取舍有一个明确偏好:宁可少讲一个花哨参数,也要把"为什么这样调度"讲透。每节都配了可以直接运行的 Python 示例(含注释与预期输出),并给出工程上的取舍判断——什么场景该用、什么场景别碰、代价是什么。
适合谁读
- 准备用 Crawl4AI 或同类框架做数据采集的 Python 开发者
- 需要为 NLP、CV、推荐系统等 AI 任务构建训练数据集的算法工程师
- 接手了爬取项目、要排查封禁与数据质量问题的维护者
- 对合规边界(robots 协议、服务条款、个人信息保护)有顾虑的技术负责人
学完你能做什么
- 把一个模糊的"我想要数据"翻译成可执行的抓取任务单:目标站点、字段 schema、量级、频率、合规约束
- 用 Crawl4AI 完成从单页抽取到深度爬取的全流程,输出结构化 JSON 与模型友好 Markdown
- 设计调度策略:URL 优先级、广度深度控制、频控节流、失败重试与会话管理
- 识别常见反爬手段并做出得体的应对,同时守住 robots 协议与法律的边界
- 搭起带监控、可水平扩展的采集服务,并把数据管线接到标注、增强与训练环节
全册知识地图
六章之间的依赖关系不是线性的背诵顺序,而是一条调度流水线:第一章给 vocabulary(任务单、字段、合规),第二章是发动机(下载与解析),第三章是质检与仓储,第四章按应用方向分流,第五章解决规模化,第六章回到选型与趋势。前三章是主干,第四章可按需跳读,第五章适合已有一定实践经验的读者。
图 0-1 抓取任务调度室全景:六章知识地图
怎么用这个教程
建议的路线分三档。入门档:顺序读第一、二章,跟着每节代码做一遍,大约两个周末;应用档:加上第三章与你需要的第四章专线,重点做 3.1 的需求分析练习;工程档:直接进第五章,但先确认你对第二、三章的调度参数与数据管线已经熟悉。全书代码基于 Crawl4AI 0.6 至 0.7 系列的公开接口写成,框架迭代较快,具体参数以你安装版本的官方文档为准——教程里刻意把"哪些是稳定概念、哪些是易变参数"区分开讲,概念不会过时,参数查表即可。
环境准备只需要一台能装 Python 3.10 以上版本的机器。Crawl4AI 的安装与浏览器内核初始化在第二章 2.5 节有完整命令行演示,初学时不必提前配置。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...