- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:跟着梯度下降远征队走完一次训练
凌晨,你盯着屏幕上跳动的 loss,它在零点三附近已经趴了二十多个 epoch 不动了。你改过学习率,换过优化器,甚至怀疑过数据。但如果你能顺着整场训练往回走——输入张量是怎么进网络的前向被算成 logits 的,交叉熵是怎么给这批错误定价的,梯度又是怎么沿着计算图一层层传回每个参数的——你就知道该拧哪个旋钮。这本教程要做的,就是给你这样一副"透视眼镜"。
本册主调:把整场训练当成一场远征。我们跟着同一个任务——识别 8×8 手写数字——从数据装车走到模型移交,把 PyTorch 的每个组件放回它在这场远征里的位置上讲透。
大多数 PyTorch 教程按 API 分类:一章讲张量,一章讲模型,一章讲训练。分类没问题,问题是学完你还是不知道这些东西在一次训练里如何咬合。所以本册换了条路:我们只跟一个任务(8×8 像素的手写数字识别,数据量小到 CPU 几分钟就能跑通),从第一行数据装载代码走到 ONNX 导出,每个组件出场时都带着它的"岗位职责"。装备再精良,不知道行军路线也到不了目的地。
全册知识地图
先看路线。六章对应一次训练的六个阶段,依赖关系是单向的:不懂张量就组装不了模型,不懂前向与损失就看不懂反向,不懂反向就理解不了优化器在更新什么。
图 0-1:全册知识地图——一次训练的六个阶段
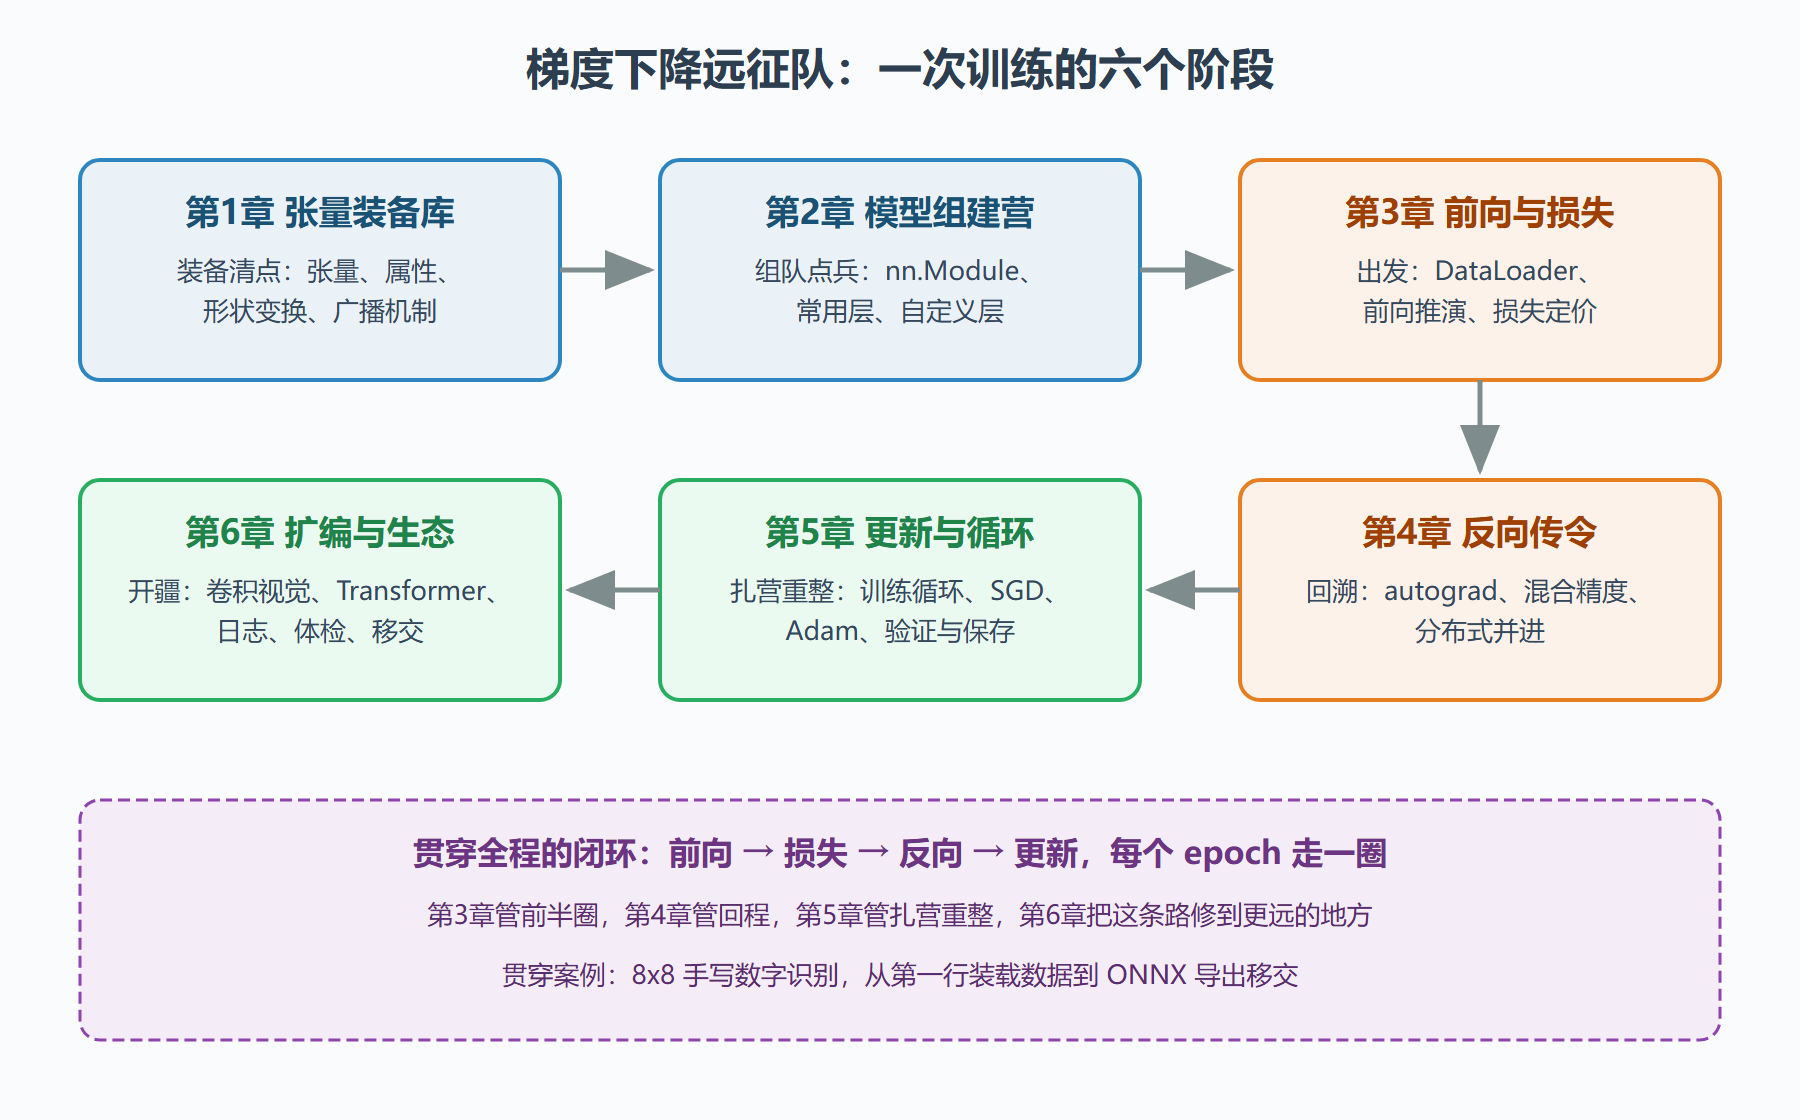
这张图值得贴在显示器边上。你之后每学到一处细节卡壳,回到图上找它所在的阶段,往往就想起来"现在走到哪一步、下一步会发生什么"。
读完这本册子你能做到什么
不是"了解 PyTorch"这种空话,而是这几件可检验的事:
- 给你一个 CSV 或图像文件夹,你能在十分钟内写出
Dataset和DataLoader,把数据装进训练流水线; - 给你一篇论文里的网络结构图,你能用
nn.Module把它组装出来,包括论文里那些要自己动手写的层; - 你能对着一行
loss.backward()讲清楚接下来 200 微秒里机器做了什么,也能解释为什么忘了zero_grad()损失会越跑越大; - 面对 loss 不降、梯度爆炸、显存溢出这三类最常见的故障,你有一套按顺序排查的手法,而不是瞎猜;
- 训练完成的模型,你知道怎么存、怎么加载、怎么转成 ONNX 交给别的运行时。
怎么读这本册子
从头顺着读最好,因为后面章节大量复用前面搭好的代码。第 3 章开始,每一章的开头都会复述"远征队现在走到了哪",你随时能对上位置。每节末尾的代码都能独立运行(CPU 即可,不需要显卡),建议边读边跑——深度学习是个手艺活,光看不练的话, backward 那一下的直觉你永远建立不起来。
如果你已经会用 PyTorch 写训练脚本,只是"知其然不知其所以然",那第 4 章和第 5 章是你的主菜:autograd 的传令机制和优化器的更新策略,是大多数人跳过、却决定调试能力上限的部分。
关于贯穿案例
8×8 手写数字识别是个刻意选小的任务:数据不到两千条,网络只有两层,CPU 秒级出结果。它小到不干扰你观察机制,又大到足以暴露所有典型问题——过拟合、学习率敏感、类别不均衡都会遇到。第 6 章扩编到卷积和 Transformer 时,这个任务会升级成它的"加强版",远征路线不变,装备升级而已。
准备好了就从第 1 章出发。远征队的规矩很简单:每一步都要知道自己在哪、要去哪、为什么这么走。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...