第2章 · GPT 原理与实现
第 2 章 · GPT 核心原理与 NanoGPT 实现
章节摘要:本章是全书的核心——把 GPT 的原理与 NanoGPT 的代码对照着讲。先讲 Transformer 架构基础(注意力、多头、层归一化),再看这些原理如何在 model.py 中落地,最后理清核心算法与数据结构。读完本章,你就能读懂 model.py 的每一行。
本节导航
阅读完本章,你应当能够:
- 说出 Transformer 的核心组件
- 理解 GPT 是"解码器堆叠"
- 读懂 model.py 的模型结构
- 理解训练与推理的数据流
- 建立"原理-代码"对照能力
核心概念速览
一句话记住本章:GPT = 一堆 Transformer 解码器叠起来,做一个超强的"猜下一个词"机器——原理简单,落地全靠代码组织。
GPT 原理与代码对照图
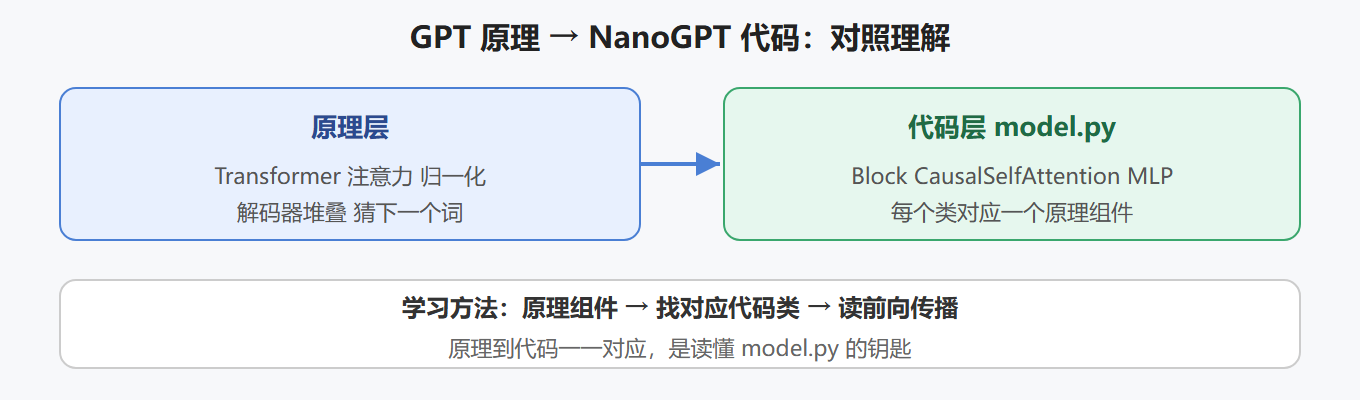
本章的读法建议
很多学习者在这一章放弃,原因不是内容难,而是"原理"和"代码"两张皮:先看十页公式再翻代码,两边都对不上。本章刻意采用"一段原理配一段代码"的写法。读到注意力机制时,旁边就是 CausalSelfAttention 的实现;读到层归一化时,旁边就是 LayerNorm 的调用位置。
建议的阅读节奏:
| 小节 | 原理主线 | 代码主线 | 合起来掌握什么 |
|---|---|---|---|
| 2.1 Transformer 架构基础 | 四个组件的作用 | 组件的类名 | 每个组件解决什么问题 |
| 2.2 GPT 结构在 NanoGPT 中的体现 | 解码器堆叠公式 | GPT 类的组装顺序 | 结构如何决定能力 |
| 2.3 model.py 走读 | 前向传播的骨架 | 逐类读代码 | 能独立讲清每个类 |
| 2.4 核心算法与数据结构 | 训练循环与形状 | 张量流转与损失 | 数据怎么流过模型 |
读代码时建议开着仓库的 model.py 对照,先在纸上画出"输入形状到输出形状"的链路,再回来看本章的解释。
子章节导航
2.1 Transformer 架构基础
注意力机制、多头注意力、归一化与残差——四大组件逐个讲清。
2.2 GPT 结构在 NanoGPT 中的体现
GPT 与 Transformer 的关系,解码器堆叠如何组成 GPT。
2.3 关键组件:model.py
逐段读 model.py:配置类、模块类、前向传播。
2.4 核心算法与数据结构
训练数据流、张量形状、损失计算——数据如何流过模型。
子章节之间的逻辑关系
原理(2.1) → GPT化(2.2) → 代码化(2.3) → 数据流(2.4) 组件 组合 落地 运转
四节从"原理组件"走到"数据流过代码",层层落地。
前置知识与后续延伸
- 前置:Python 与 PyTorch 基础;第 1 章的定位认知
- 为后续铺垫:本章的模型理解是第 3 章训练、第 4 章优化的基础
本章检验清单
读完本章后,你应该能独立完成三件事:
- 不看代码,画出 GPT 从 token 到概率输出的数据流(含张量形状)
- 说出 CausalSelfAttention 里 Q、K、V 三份张量分别是什么
- 解释"为什么位置嵌入不能省"
这三件事都做到,就可以放心进入第 3 章的实践了。
评论区
(0)
U