2.2 GPT 结构在 NanoGPT 中的体现
2.2 GPT 模型结构在 NanoGPT 中的体现
本节摘要:GPT 不是全新发明,而是"只取 Transformer 的解码器部分,堆叠 n 层"。本节讲清 GPT 的结构公式(嵌入 → n 个 Block → 归一化 → 输出头)、每一步在 NanoGPT 里的对应,以及为什么"预测下一个词"就能产生语言能力。
本节地图
阅读完本节,你应当能够:
- 说出 GPT 的结构公式
- 理解"解码器堆叠"的含义
- 在 NanoGPT 里找到每层对应
- 理解"猜下一个词"的机制
- 画出 GPT 的数据流
一、问题与直觉
GPT 的全称是 Generative Pre-trained Transformer——生成式、预训练、Transformer。它的结构一句话:Transformer 的解码器部分,叠 n 层,加上词嵌入与输出头。Transformer 原论文有编码器(读)和解码器(写),GPT 只留了解码器——因为"生成"只需要"写"。
为什么解码器就够了?因为 GPT 的任务是"给定前文,生成下文",不需要像翻译那样先完整读一遍输入再输出。解码器里的因果注意力天然适合这种自回归生成:每一步只能看到自己及之前的 token。
二、核心原理
2.1 GPT 结构公式
GPT 的骨架可以画成一条流水线:
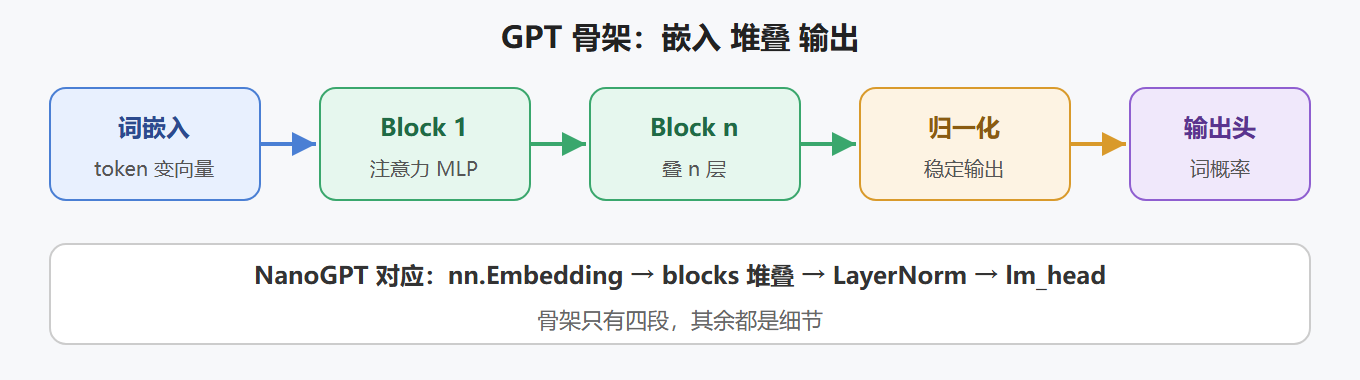
嵌入 → n 个 Block → 归一化 → 输出头,这就是 GPT 的全部骨架。
2.2 每层的对应
| 结构层 | NanoGPT 对应 |
|---|---|
| 词嵌入 | nn.Embedding |
| Block 堆叠 | GPT 类中 blocks |
| 层归一化 | LayerNorm |
| 输出头 | lm_head(Linear) |
其中"嵌入"实际有两张表:token 嵌入(把词 id 映射成向量)和位置嵌入(把位置编号映射成向量),两者相加得到每个 token 的最终输入向量。NanoGPT 的 GPT 类里这两张表是独立的 nn.Embedding。
2.3 "猜下一个词"如何产生能力
模型训练时反复做一件事:给一串词,预测下一个词。训练数据是海量文本,模型被迫学会语言的规律(语法、语义、逻辑)——"猜词"是表面的训练目标,"理解语言"是副产品。猜得准,说明规律学得好。
从计算角度看,每个训练样本同时产生 T 个预测(序列里每个位置都预测下一个词),一次前向传播就能算 T 份损失。这种"一鱼多吃"让数据利用率很高——这也是为什么一小段文本能切出大量训练样本。
💡 关键直觉:GPT 的全部魔法,藏在"预测下一个词"这个简单目标里。不用精心设计任务,海量文本 + 猜词,就逼出了语言能力——这就是"预训练"的本质。
三、工程实践要点
3.1 训练时的数据形态
输入文本:[今天, 天气, 很, 好] 预测目标:下一个词("好"之后的词) 实际做法:每个位置都预测"下一个",一次性学整句
3.2 一个 Block 的内部
Block = 注意力 + 残差 + 归一化 + MLP + 残差 + 归一化 [找关系] [加工信息]
NanoGPT 的 Block 顺序是"先归一化再注意力"(Pre-Norm),与 Transformer 原论文"先注意力再归一化"(Post-Norm)不同。Pre-Norm 在深层网络上训练更稳,是后来各种大模型的通用做法。注意这个差异,读代码时就不会困惑"怎么和论文不一样"。
3.3 用代码看结构落地
import torch from model import GPT, GPTConfig # 用莎士比亚的小配置实例化 cfg = GPTConfig(vocab_size=65, block_size=256, n_layer=6, n_head=6, n_embd=384) model = GPT(cfg) x = torch.randint(0, 65, (4, 256)) # [batch, seq] logits, loss = model(x) print(logits.shape) # [4, 256, 65]:每个位置对 65 个字符的得分
logits 的形状 [4, 256, 65] 就是结构公式的最终输出:批次 4、序列 256、词表 65。对这个形状做 softmax 再加 argmax,就是"每个位置预测的下一个字符"。
3.4 读代码时的注意点
- 找 blocks 循环:
nn.Sequential(*blocks)就是堆叠 - 找 embedding 层:token 与位置两类嵌入
- 找 lm_head:与 embedding 共享权重(weight tying)
3.5 用生成验证结构
# 从随机初始化模型生成文本(还没训练,输出是乱码) # 这一步的价值是确认"结构能跑通" idx = torch.zeros((1, 1), dtype=torch.long) out = model.generate(idx, max_new_tokens=20) print(out) # 能看到 20 个字符 id 被逐个生成出来
⚠️ 常见误区:以为位置嵌入可有可无。没有位置信息,模型分不清"我打你"和"你打我"——token 嵌入提供"是什么词",位置嵌入提供"词在哪",两个都要。
3.6 为什么 GPT 只有解码器
Transformer 原论文的编码器负责"读完整输入",解码器负责"逐词生成输出"。GPT 选择只留解码器,是因为它的任务形态不同:没有"要翻译的原文",只有"已生成的上下文"。因果注意力天然适配这种形态——每个位置只依赖历史,生成时可以增量计算。
这也解释了一个常见困惑:为什么 GPT 生成新词后要把整段文本重新喂一遍?因为自回归要求"看到自己刚生成的词"。工程上可以缓存历史状态加速(如 KV Cache),但 NanoGPT 为教学清晰起见没有做缓存,每次前向都从完整序列算起。
3.7 预训练与微调的结构视角
同一套结构可以服务两个阶段:
| 阶段 | 数据 | 目标 | 产物 |
|---|---|---|---|
| 预训练 | 海量通用文本 | 预测下一个词 | 通用语言能力 |
| 微调 | 领域小数据 | 继续预测 / 对齐 | 领域能力 |
NanoGPT 主要演示预训练;微调只需换数据继续训练,结构完全不变。理解了"结构固定、数据与目标可变",你就掌握了 GPT 生态的底层逻辑。
要点串联
- 要点一:GPT = 嵌入 + n 个 Block + 归一化 + 输出头
- 要点二:GPT 只留 Transformer 解码器,因为生成只需要"写"
- 要点三:每个结构层在 NanoGPT 都有对应代码
- 要点四:"猜下一个词"是目标,"理解语言"是副产品
- 要点五:每个位置同时预测下一个词,一次性学整句
- 要点六:Block = 注意力 + MLP + 残差 + 归一化
结构骨架清楚了,下一节逐行读 model.py——关键组件详解。