2.1 Transformer 架构基础
2.1 Transformer 架构基础
本节摘要:GPT 的底层是 Transformer,而 Transformer 的核心是注意力机制。本节讲清四个基础组件:注意力(词与词找关联)、多头注意力(多角度找关联)、层归一化(稳定训练)、残差连接(防退化),每个组件都指向 model.py 里对应的代码。
核心问题
阅读完本节,你应当能够:
- 解释注意力机制的作用
- 理解多头注意力的"多角度"
- 说清层归一化与残差连接的作用
- 把每个组件对应到代码
- 建立 Transformer 的心智模型
一、问题与直觉
Transformer 是"注意力机制"的产物:处理每个词时,知道该重点关注句子里的哪些词。读"苹果"时,"公司"让它想到科技、"水果"让它想到食物。注意力就是给每个词算一张"关系权重表"——哪个词对理解当前词最重要。
这个直觉可以直接翻译成计算:把每个词表示成向量,用"查询"和"键"计算两两相似度,相似度越高,对应的"值"对输出贡献越大。整个过程是纯矩阵运算,正好是 GPU 的强项——这是 Transformer 能并行训练的根本原因。
二、核心原理
Transformer 的四个组件各司其职:
2.1 注意力机制
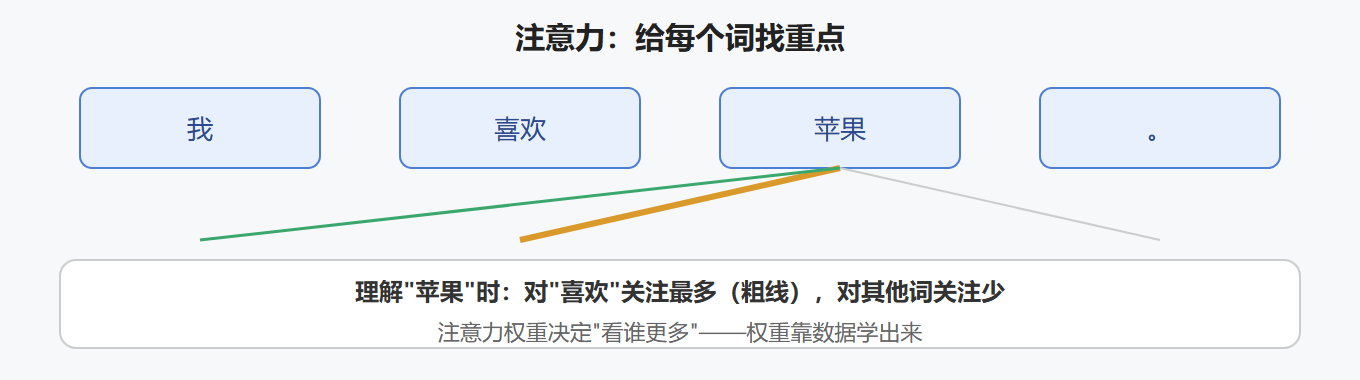
注意力的计算分五步:每个 token 生成 Q、K、V 三份向量;用 Q 与所有 K 点积得到分数;除以维度平方根做缩放;softmax 归一化成权重;按权重加权求和 V。下面用 PyTorch 实现单头注意力,代码不过二十行:
import torch import torch.nn.functional as F def scaled_dot_product_attention(q, k, v, mask=None): # q/k/v: [B, T, head_dim] B, T, head_dim = q.shape # 1. 查询与键点积,得到 [B, T, T] 的分数矩阵 scores = (q @ k.transpose(-2, -1)) / (head_dim ** 0.5) # 2. 因果掩码:把未来位置设为负无穷 if mask is not None: scores = scores.masked_fill(mask == 0, float("-inf")) # 3. softmax 归一化成权重 weights = F.softmax(scores, dim=-1) # 4. 按权重加权求和 out = weights @ v return out
缩放那一行(除以 head_dim 的平方根)最容易被忽略,却是训练稳定的关键:向量维度大时点积数值会很大,softmax 会退化成近似 one-hot,梯度几乎消失。NanoGPT 的 CausalSelfAttention 里同样保留了这步。
2.2 多头注意力
单头注意力从一个角度看关系,多头从多个角度同时看(如"句法关系"一个头、"语义关联"一个头),最后合并——就像多个专家同时分析,综合意见更全面。
实现上,多头并不需要循环:把维度切成 n_head 份,一次矩阵乘法同时算所有头。NanoGPT 的做法是把 n_embd(如 768)分成 n_head(如 12)个 head_dim(64)的子空间,每个头独立计算再拼接。这也是为什么 768 除以 12 必须整除——配置不合理会直接报错。
2.3 归一化与残差
| 组件 | 作用 | 类比 |
|---|---|---|
| 层归一化 | 稳定数值范围 | 统一度量衡 |
| 残差连接 | 防止深层退化 | 搭梯子,信息直达 |
层归一化对每个 token 的特征做标准化:减去均值、除以方差,再乘可学习参数。它让深层网络的激活值保持合理范围,是训练 12 层以上模型能稳定收敛的重要保障。残差连接则是把输入直接加到输出上:x 加 attention 的结果。有了它,梯度可以绕过深层直接回传,深层网络才"堆得动"。
💡 关键直觉:四个组件各司其职,缺一不可——注意力负责"找关系",多头负责"多角度",归一化负责"稳",残差负责"通"。model.py 里每个都有对应类。
三、工程实践要点
3.1 组件-代码对照表
| 原理组件 | model.py 对应 |
|---|---|
| 注意力 | CausalSelfAttention |
| 多头 | head_size × n_head |
| 归一化 | LayerNorm |
| 残差 | block 内的 + 操作 |
3.2 阅读代码的顺序
先读 Block(块的拼装) 再读 CausalSelfAttention(注意力实现) 再看 LayerNorm 与 MLP 最后看 GPT 如何堆叠 Block
3.3 理解"因果掩码"
GPT 的注意力是"因果"的——只看过去的词,不看未来的词(否则"猜下一个词"就泄题了)。CausalSelfAttention 里的"causal"就是这个意思。
实现上通常用一个上三角矩阵:把未来位置的分数设为负无穷,softmax 之后权重自然为 0。上面的代码示例里 mask 参数干的就是这件事。
3.4 用一个小实验验证理解
# 用随机向量跑一次注意力,观察输出形状与数值范围 torch.manual_seed(42) q = torch.randn(2, 8, 64) # 2 个样本,8 个 token,64 维 k = torch.randn(2, 8, 64) v = torch.randn(2, 8, 64) out = scaled_dot_product_attention(q, k, v) print(out.shape) # torch.Size([2, 8, 64]),形状不变 print(out.mean().item()) # 数值应接近 0,而不是发散
形状不变、数值稳定,说明注意力实现正确——这也是第 3 章里验证代码时常用的手法。
⚠️ 常见坑:注意力分数忘记缩放。注意力计算要除以维度平方根(scaled attention)——忘了这步,分数过大,softmax 后权重会塌成 one-hot,训练极不稳定。代码里那行 scale 不是可有可无。
本章回顾
- 要点一:注意力 = 给每个词算关系权重
- 要点二:多头 = 多角度同时找关系
- 要点三:归一化稳数值,残差防退化
- 要点四:每个原理组件都有对应代码类
- 要点五:阅读顺序——Block、注意力、归一化、堆叠
- 要点六:因果掩码保证"只看过去"
原理组件清楚了,下一节看它们怎么组成 GPT——GPT 结构在 NanoGPT 中的体现。