2.3 关键组件:model.py
2.3 关键组件:模型定义(model.py)
本节摘要:model.py 是 NanoGPT 的心脏——约 300 行代码定义完整 GPT。本节逐段走读它的三个核心类:配置类(参数设置)、CausalSelfAttention(因果注意力)、Block 与 GPT(组装与调用),并给出一份"读懂 model.py"的路线图。
上手前先明确
阅读完本节,你应当能够:
- 说出 model.py 的三个核心类
- 读懂配置类与模块类
- 理解前向传播的数据流
- 掌握"分模块读"的方法
- 独立读完整份 model.py
一、问题与直觉
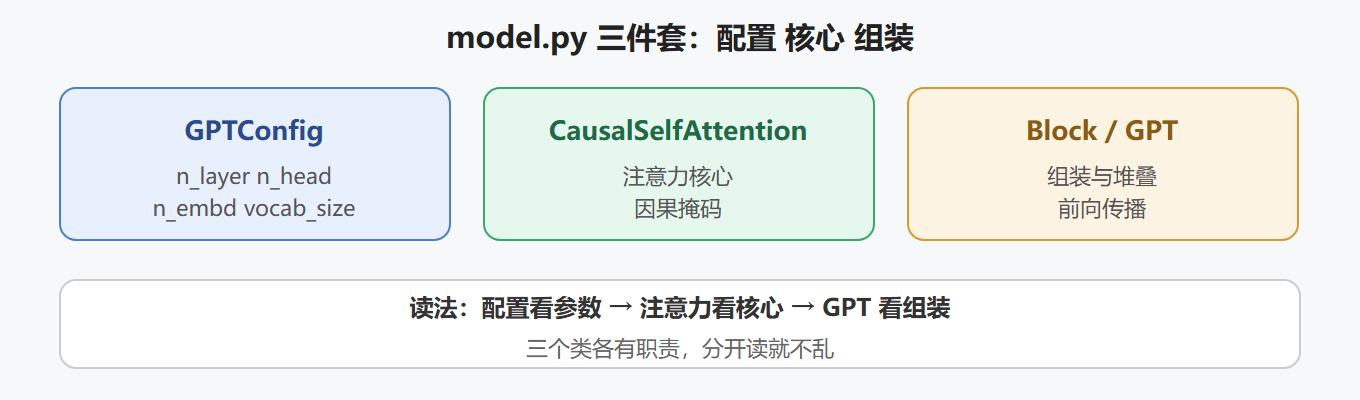
第一次打开 model.py,300 行代码可能让人头大。但拆开看就清楚:三个类,各自管一件事——配置类定参数、注意力类实现核心、Block/GPT 负责组装。读代码的正确姿势不是"从头背到尾",而是"分模块、跟数据流"。
建议把 model.py 当一张地图:先看类名和继承关系,再顺着 forward 方法追踪数据从进到出的每一步。本节就走这条路线。
二、核心原理
model.py 的类结构与数据流:
2.1 三个核心类
2.2 前向传播的骨架
输入 token → 词嵌入 + 位置嵌入 → n 层 Block → LayerNorm → 输出头 → 词概率
每一层 Block 内:注意力(找关系)→ 残差 → 归一化 → MLP(加工)→ 残差 → 归一化。
三、工程实践要点
3.1 类职责速查
| 类 | 职责 | 关键成员 |
|---|---|---|
| GPTConfig | 参数规格 | n_layer n_head n_embd |
| CausalSelfAttention | 注意力核心 | qkv proj attn dropout |
| Block | 单层组装 | attn mlp norm |
| GPT | 整体模型 | token_emb pos_emb blocks |
3.2 读懂 model.py 的路线图
第一步 读 GPTConfig:参数有哪些,默认值多少 第二步 读 CausalSelfAttention:attention 怎么算 第三步 读 Block:一个块怎么拼 第四步 读 GPT:forward 怎么跑
3.3 配置类与初始化逻辑
class GPTConfig: block_size = 256 # 上下文长度 vocab_size = 50304 # 词表大小 n_layer = 12 # 层数 n_head = 12 # 头数 n_embd = 768 # 嵌入维度 # GPT 初始化里的关键逻辑:按标准差缩放各层权重 def _init_weights(self, module): std = 0.02 if isinstance(module, nn.Linear): torch.nn.init.normal_(module.weight, mean=0.0, std=std) if module.bias is not None: torch.nn.init.zeros_(module.bias) elif isinstance(module, nn.Embedding): torch.nn.init.normal_(module.weight, mean=0.0, std=std)
初始化看似细节,实际影响很大:残差层特意把标准差再除以层数的平方根(std 缩小),保证深层网络相加时不至于数值爆炸。这是 GPT-2 论文里明确描述的做法,NanoGPT 原样实现了。
💡 关键直觉:配置类就是"模型规格说明书"——改参数就改模型大小。124M 模型就是由这些数字(12 层、768 维)决定的。
3.4 注意力实现要点
class CausalSelfAttention(nn.Module): def forward(self, x): B, T, C = x.size() # 一次投影生成 Q、K、V(比三个独立 Linear 更高效) q, k, v = self.c_attn(x).split(self.n_embd, dim=2) # 按头数重塑:[B, T, C] -> [B, nh, T, hs] k = k.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) q = q.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) v = v.view(B, T, self.n_head, C // self.n_head).transpose(1, 2) # 缩放点积注意力:q @ k^T / sqrt(head_size) att = (q @ k.transpose(-2, -1)) * (1.0 / math.sqrt(k.size(-1))) # 因果掩码:只保留下三角 att = att.masked_fill(self.bias[:, :, :T, :T] == 0, float("-inf")) att = F.softmax(att, dim=-1) y = att @ v # 合并多头并投影回 C 维 y = y.transpose(1, 2).contiguous().view(B, T, C) return self.c_proj(y)
这段是 model.py 里最核心的 20 行。注意三点:一是"一次投影切三份"的写法,比分别定义三个 Linear 参数更省;二是多头用 view 和 transpose 完成,没有循环;三是掩码用的 bias 是一个常驻的因果下三角矩阵,随 block_size 预先建好。
3.5 Block 与 MLP
class Block(nn.Module): def forward(self, x): # Pre-Norm 顺序:先归一化,再注意力,再加残差 x = x + self.attn(self.ln_1(x)) x = x + self.mlp(self.ln_2(x)) return x class MLP(nn.Module): def __init__(self, config): super().__init__() self.c_fc = nn.Linear(config.n_embd, 4 * config.n_embd) self.gelu = nn.GELU() self.c_proj = nn.Linear(4 * config.n_embd, config.n_embd)
MLP 先升维 4 倍再降回来,中间的 GELU 提供非线性。这个"升-激活-降"结构是 Transformer 的标准配方,参数量占模型的约三分之二——比注意力还多。
3.6 验证读懂的方法
读完后做一个小测试:改 n_layer 从 12 到 4,模型参数量会怎么变?能答出"变少"并说清为什么,说明你真读懂了。
更直接的验证是用代码数参数:
# 124M 配置的参数量应该约 124M(不含位置嵌入的微小差异) cfg = GPTConfig(vocab_size=50257, block_size=1024, n_layer=12, n_head=12, n_embd=768) model = GPT(cfg) print(model.get_num_params()) # 输出约 123568896
get_num_params 只统计需要梯度的参数,并扣除了绑定权重的那份,所以数字会略小于 124M。数参数是快速判断"配置理解对不对"的好工具。
⚠️ 常见坑:分不清 QKV 的角色。记住一句话:查询"问",键"被问",值"被取"——查询和键算关联度,关联度加权值。这个三角关系是注意力的全部。
3.7 forward 的双模式设计
GPT 类的 forward 是 NanoGPT 里少见的"一个函数两种用法":
def forward(self, idx, targets=None): # 推理模式:只给 idx,返回 logits # 训练模式:同时给 targets,额外返回 loss ... if targets is not None: loss = F.cross_entropy(logits.view(-1, logits.size(-1)), targets.view(-1)) return logits, loss
理解这个设计对使用很重要:训练时调用 model(x, y) 拿 loss;生成时调用 model(x) 只拿 logits。忘了传 targets 就调用训练逻辑,是常见的低级错误。
3.8 可选的 Flash Attention 分支
NanoGPT 在 CausalSelfAttention 里提供了一个提速开关:当环境支持时用 Flash Attention 替代手写注意力。它的收益主要有两点:显存占用大幅下降(不再显式保存完整的注意力矩阵),计算速度提升。教学版代码把两种路径都保留,方便对比。
if self.flash: y = torch.nn.functional.scaled_dot_product_attention( q, k, v, attn_mask=None, dropout_p=self.attn_dropout.p if self.training else 0.0, is_causal=True, ) else: # 手写版:缩放、掩码、softmax、加权求和 ...
学习时建议先读手写版(逻辑直白),理解后再看 Flash 版(性能更优)。两个版本输出等价,这也是"功能与教学兼顾"的典型写法。
3.9 从预训练权重加载
model.py 里还有一个实用方法:from_pretrained,从官方 GPT-2 检查点加载权重。它做的事是把 OpenAI 的权重文件按 NanoGPT 的键名重新组装:
model = GPT.from_pretrained("gpt2") # 加载 124M 官方权重 model.eval() # 加载后可直接生成或继续微调
这个方法让"用 NanoGPT 玩官方 GPT-2"成为可能,也展示了权重格式转换的通用套路:键名映射 + 逐键拷贝。
温故知新
- 要点一:三件套——配置、注意力、组装
- 要点二:配置类是规格说明书,改参数改模型大小
- 要点三:前向传播——嵌入、堆叠、归一化、输出
- 要点四:QKV 三角——查询问、键被问、值被取
- 要点五:读法——配置、注意力、Block、forward
- 要点六:改参数看参数量变化,验证读懂
model.py 会读了,下一节看数据怎么流过它——核心算法与数据结构。