2.4 核心算法与数据结构
2.4 核心算法与数据结构
本节摘要:理解了模型结构,还要理解数据怎么流过它。本节讲清训练的核心算法(前向传播 → 损失 → 反向传播 → 参数更新)、张量形状的变化(数据长什么样)、以及损失计算与权重共享等实现细节——读完你就能"看数据走一遍"。
本节导读
阅读完本节,你应当能够:
- 复述训练的核心循环
- 说出张量形状的流转
- 理解损失如何计算
- 理解权重共享的含义
- 用"数据视角"理解整个模型
一、问题与直觉
模型是"静态的结构",训练是"数据的流动"。理解 GPT 的最后一环:一批文本进去,变成什么形状、经过哪些变换、算出什么损失、如何更新参数。看懂这条数据流,训练就不再是黑盒。
训练的本质是优化一个目标函数:交叉熵损失。每一轮迭代,模型读一批数据、算损失、反传梯度、更新参数,循环成千上万次。下面把这个循环拆开看。
二、核心原理
2.1 训练核心循环
四个步骤循环往复,直到损失收敛。
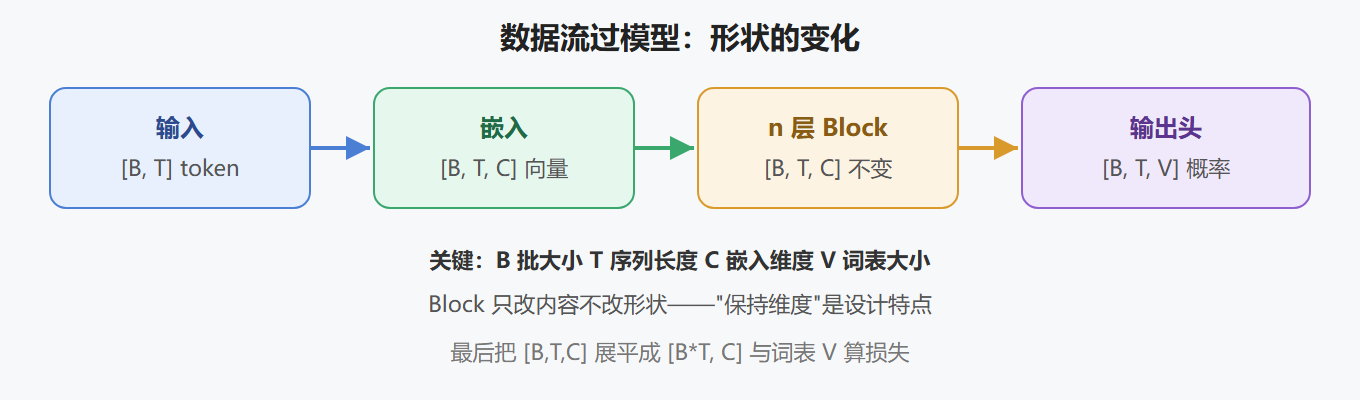
2.2 张量形状流转
2.3 用代码走一遍形状
import torch from model import GPT, GPTConfig cfg = GPTConfig(vocab_size=65, block_size=256, n_layer=6, n_head=6, n_embd=384) model = GPT(cfg) x = torch.randint(0, 65, (4, 256)) # 输入:[B, T] = [4, 256] tok_emb = model.transformer.wte(x) # [4, 256, 384] 词嵌入 pos_emb = model.transformer.wpe(torch.arange(256)) # [256, 384] h = tok_emb + pos_emb # [4, 256, 384] 相加广播 for block in model.transformer.h: h = block(h) # 每层保持 [4, 256, 384] h = model.transformer.ln_f(h) # 最后归一化 logits = model.lm_head(h) # [4, 256, 65] 输出头 print(logits.shape)
形状变化的规律一句话:进入模型后一直是 [B, T, C],直到最后一步才变成 [B, T, V]。Block 内部只改数值不改形状——记住这一点,看任何 GPT 实现都不会迷路。
2.4 损失计算
# train.py 里损失的计算方式 # logits: [B, T, V],targets: [B, T] # 展平后做交叉熵:每个位置、每个样本都算一份损失 loss = F.cross_entropy( logits.view(-1, logits.size(-1)), # [B*T, V] targets.view(-1), # [B*T] )
交叉熵对比"预测分布"与"真实下一个词",惩罚预测错误。对莎士比亚字符级模型,初始损失约 ln(65) = 4.17(均匀猜 65 个字符的熵),训练后能降到 2 以下——损失数字从哪来、意味着什么,第 4 章会展开讲。
三、工程实践要点
3.1 批次与序列的直觉
| 符号 | 含义 | 直觉 |
|---|---|---|
| B | 批大小 | 一次看几段文本 |
| T | 序列长度 | 每段多长(上下文) |
| C | 嵌入维度 | 每个词用多长的向量表示 |
| V | 词表大小 | 一共多少个不同的词 |
3.2 权重共享
NanoGPT 里输出头与词嵌入共享权重:lm_head.weight = token_embedding.weight。效果是参数更少、效果相当——这是 GPT-2 论文里的实践。
实现上很简单,就在 GPT 初始化末尾一行:
# 权重绑定:输出头复用词嵌入矩阵 self.lm_head.weight = self.transformer.wte.weight
为什么合理?因为"词长什么样"的信息在输入输出两侧是同一个概念,共享权重等于告诉模型"输入和输出用同一套表示"。参数量因此省下约 5000 万(124M 模型里词表占大头)。
3.3 优化器与参数分组
# configure_optimizers 的核心逻辑: # 2 维参数(权重矩阵)加权重衰减,1 维参数(偏置、归一化)不加 decay_params = [p for n, p in model.named_parameters() if p.dim() >= 2] nodecay_params = [p for n, p in model.named_parameters() if p.dim() < 2] optim_groups = [ {"params": decay_params, "weight_decay": weight_decay}, {"params": nodecay_params, "weight_decay": 0.0}, ]
这是 NanoGPT 训练技巧的一个细节:权重衰减只作用于矩阵权重,不作用于偏置和归一化参数。这样既享受正则化好处,又不会拖慢必要的偏差项。
3.4 反向传播与梯度累积
# 单步训练的标准写法 logits, loss = model(X, Y) optimizer.zero_grad(set_to_none=True) loss.backward() # 反向传播,算梯度 torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0) # 梯度裁剪 optimizer.step() # 更新参数
梯度裁剪把梯度的整体范数限制在 1.0 以内,防止梯度爆炸——这是大模型训练的标准安全阀。NanoGPT 的 train.py 还支持梯度累积:显存不够时,把一个大批次拆成多个微批次,梯度累加后再更新,等效于大批次训练。
3.5 验证理解的小实验
打印输入与输出的形状 改批次大小观察形状变化 算一次参数量(.numel())
💡 关键直觉:数据流 = [B,T] → [B,T,C] → [B,T,V]——从头到尾,维度只加了一个 C 又换成 V。盯着形状看,模型不再神秘。
⚠️ 常见坑:批次与序列维度搞反。输入是 [B, T](批次在前、序列在后)——改数据时弄反维度,模型训练直接报错或形状错乱。写代码先打印形状,一眼看清。
3.6 数据迭代器与随机性
train.py 的数据加载有一个细节值得留意:每个 epoch 里样本不是顺序遍历,而是随机起点切块。这种"随机窗口"策略让同一个语料在不同迭代看到不同上下文,等效于隐式的数据增强,也能减少过拟合。实现要点:
# 每次迭代随机选 batch_size 个起点 ix = torch.randint(len(data) - block_size, (batch_size,))
理解这个随机性,你就明白为什么训练日志里损失会有波动——不是 bug,是采样噪声。评估验证损失时,NanoGPT 会固定多取几批求平均,就是为了摊平这种波动。
3.7 训练中的内存管理
模型训练时显存里有四份东西:权重、梯度、优化器状态、激活值。前向传播保留的中间激活是训练特有的开销,反向传播用完即释放。理解这一点,就能解释两个常见现象:
推理显存小:只要权重 + 激活 训练显存大:权重 + 梯度 + 优化器 + 激活 batch 越大激活越多:所以 OOM 时先降 batch
这也是"训练比推理贵得多"的根源——第 4 章硬件估算会再次用到这张账本。
要点速记
- 要点一:训练循环——前向、损失、反向、更新
- 要点二:形状流转 [B,T] → [B,T,C] → [B,T,V]
- 要点三:Block 保持维度,只改内容
- 要点四:损失 = 预测 vs 真实的交叉熵
- 要点五:输出头与词嵌入共享权重
- 要点六:盯着形状看,模型不再神秘
原理与实现全通了,第 3 章开始动手——环境、数据、训练、生成。