第3章 · 实践与操作
第 3 章 · NanoGPT 的实践与操作
章节摘要:原理读懂了,本章亲手跑起来。从环境搭建开始,到数据准备与预处理、模型训练与微调、文本生成与采样、配置文件与参数调整——五步走完,你就能在自己的机器上训练出一个能写文本的小模型。
先说结论
阅读完本章,你应当能够:
- 搭建 NanoGPT 的运行环境
- 准备并预处理训练数据
- 跑通模型训练流程
- 用训练好的模型生成文本
- 通过配置调整模型行为
核心概念速览
一句话记住本章:训练一个文本模型的流程是"数据 → 训练 → 生成"三段式——每段都有对应脚本,跑通就是学会。
实践流程全景
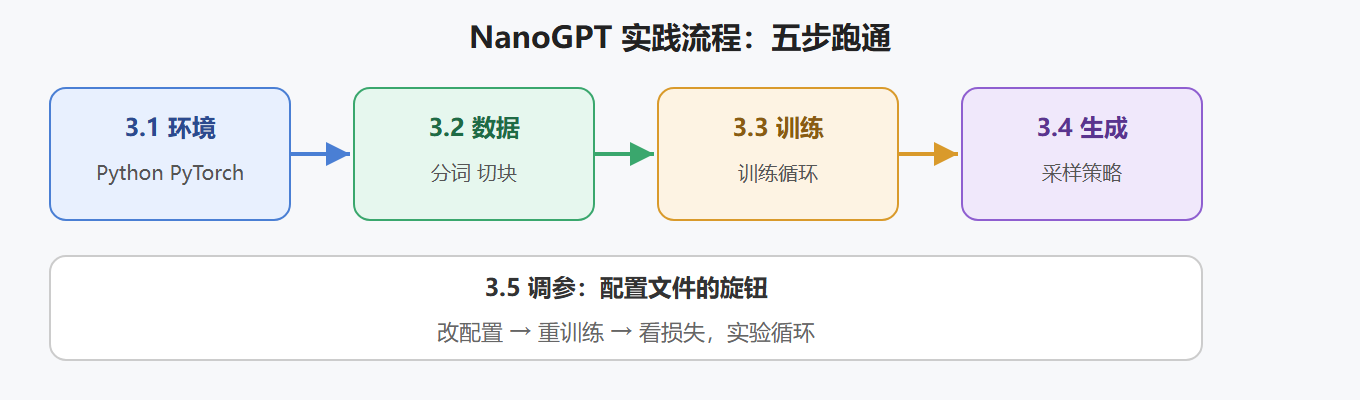
本章的实操路线
整章围绕一个可复现的最小案例展开:用莎士比亚戏剧文本(约 1MB)训练一个字符级小模型。这条路线刻意选小数据、小模型,让每一步都能在几分钟内看到结果,却覆盖了全部真实环节。
| 步骤 | 对应脚本 | 产物 | 验证点 |
|---|---|---|---|
| 搭环境 | 无 | 可用的 Python + PyTorch | import torch 成功 |
| 备数据 | prepare.py | train.bin / val.bin | 文件生成且大小合理 |
| 训练 | train.py | ckpt.pt 与损失日志 | 损失持续下降 |
| 生成 | sample.py | 输出文本 | 文本有莎剧味道 |
| 调参 | config 目录 | 实验记录 | 对比不同配置的损失 |
建议按表格顺序逐个完成,每完成一行就记录一行。遇到问题先查该节末尾的常见坑,再回到脚本本身排查。
子章节导航
3.1 环境搭建与依赖管理
Python 环境、PyTorch 安装、仓库克隆与依赖检查。
3.2 数据准备与预处理
文本数据集的选择、分词、切块与二进制化。
3.3 模型训练与微调流程
训练脚本、损失监控、微调与继续训练。
3.4 文本生成与采样
生成脚本、采样策略(top-k、温度)与效果控制。
3.5 配置文件与参数调整
配置参数的含义、调整方法与实验思路。
子章节之间的逻辑关系
环境(3.1) → 数据(3.2) → 训练(3.3) → 生成(3.4) → 调参(3.5) 地基 燃料 引擎 输出 升级
五节对应完整实践流程,每节有可运行的验证点。
前置知识与后续延伸
- 前置:第 2 章的模型理解;Python 与 PyTorch 基础
- 为后续铺垫:本章的训练实践是第 4 章复现与优化的基础
本章检验清单
跑完本章后,你应该手里握着三样东西:
- 一个能用的训练环境,以及装好依赖的仓库目录
- 一份莎士比亚数据的训练日志(损失从 4 左右降到 2 以下)
- 一个能生成文本的检查点,以及用它生成的一段样例输出
有这三样,第 4 章的复现与优化就有了直接可用的基础。
评论区
(0)
U