1.1 Supabase 的定位与愿景
1.1 Supabase 的定位与愿景
反问一句:当你要在两周内交付一个带登录、评论、文件上传的小产品,你是去租三台服务器自己装数据库、写鉴权中间件,还是找个把这些都打包好的服务?大多数团队会选后者。Supabase 想做的,就是那个"后者",只不过它不锁死你——底层是开源的 Postgres,随时能导出、能自托管。这一节我们讲清楚它的定位逻辑,以及它想往哪个方向走。
从一个真实痛点说起:为什么是 Postgres 即平台
传统后端搭建有个隐性成本:每加一个能力就要引入一个新组件,组件之间还要自己写胶水。登录用 Auth0,数据库用 RDS,文件用 S3,实时用 WebSocket 服务,搜索再接一个 ES。拼起来能跑,但运维面、账单、跨组件权限都成了你的负担。
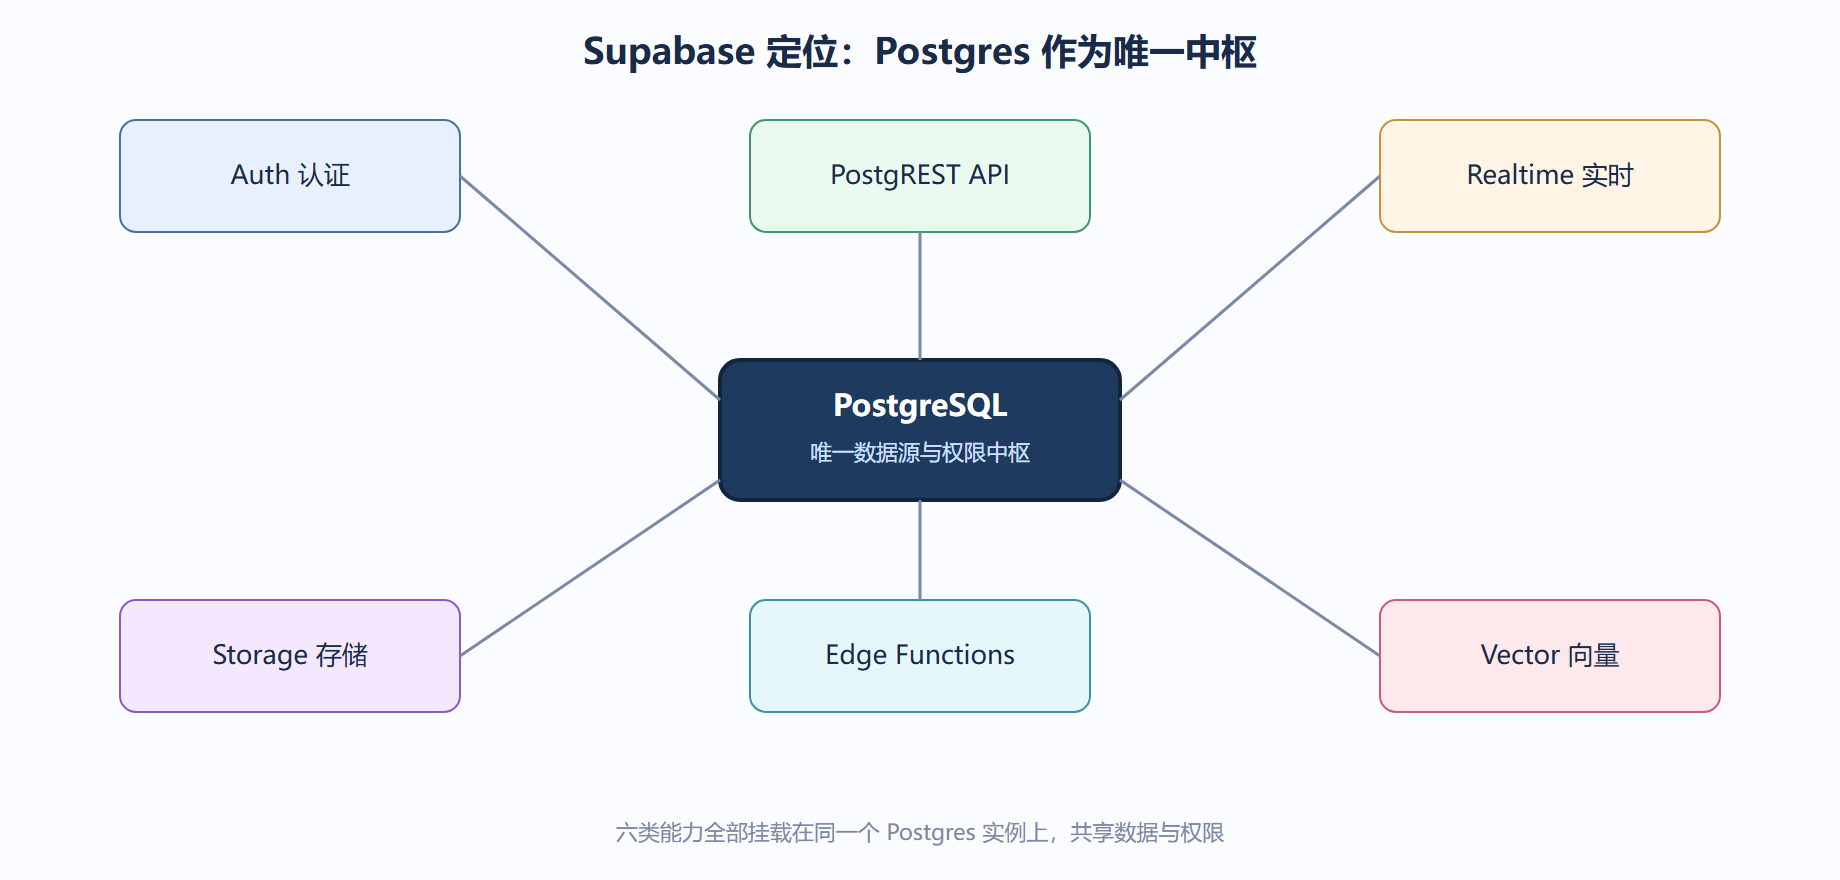
Supabase 的判断是:这些能力绝大部分 Postgres 本身就能承担,只是缺一层把数据库直接变成后端服务的封装。于是它的核心定位是 The Postgres Development Platform——以 Postgres 为唯一中枢,其他能力都围绕它构建:
- 认证:用户表落在 Postgres,权限用行级安全(RLS)表达。
- API:通过 PostgREST 把表直接暴露成 REST,不用手写 CRUD 路由。
- 实时:监听 Postgres 的 WAL(预写日志)变更,推给前端。
- 存储:对象和元数据存 S3 兼容层,权限仍由 RLS 管。
- 函数:边缘函数跑业务逻辑,能直接连同一套数据库。
下面的 SVG 画了这套"一个中枢、多个挂载点"的结构,注意所有能力都指向中间的 Postgres。
这种定位带来什么具体好处
讲因果,不说空话。把中枢收敛到 Postgres 之后,有三个可感知的回报:
数据模型统一。 关系表、JSONB 字段、数组类型、向量类型都在一个库里。你不用在"关系库管订单、文档库管日志"之间来回切换,迁移和联表查询都简单。代价是:你得真的会设计表,不能像文档库那样随意塞结构。
生态直接继承。 Postgres 有几十年积累:pg_dump 导出、逻辑复制、丰富的索引类型、成熟的监控工具。Supabase 没重新发明这些,而是把它们包装成平台能力。这意味着你团队里懂 PG 的人,立刻能在这个平台上干活。
控制权在自己手里。 因为是开源栈,你能在任何云上自托管,也能从 Supabase 云导出全部数据走人。这和闭源 BaaS 的根本区别是:供应商锁定风险可控。
我们用一段 SQL 验证"Postgres 即平台"不是口号。下面建一张带 RLS 的 profiles 表,认证用户只能看自己的资料——这条规则同时管住了 API 层和未来的函数调用:
-- 建用户资料表,id 直接复用 auth.users 的 uuid create table public.profiles ( id uuid primary key references auth.users(id) on delete cascade, username text unique not null, bio text, created_at timestamptz default now() ); -- 开启行级安全,默认拒绝一切访问 alter table public.profiles enable row level security; -- 登录用户只能读取自己的资料 create policy "自己看自己" on public.profiles for select using (auth.uid() = id); -- 登录用户只能更新自己的资料 create policy "自己改自己" on public.profiles for update using (auth.uid() = id);
跑完之后,通过 PostgREST 访问 GET /rest/v1/profiles 时,Supabase 会自动把 auth.uid() 注入成当前 JWT 里的用户,返回结果只包含本人行。你没写一行后端路由,权限却已经生效。这就是"Postgres 即平台"的落地形态。
Supabase 的愿景:让后端像前端一样快
官方反复强调的一句话是"Build in a weekend, scale to millions"(周末做出原型,轻松扩展到百万级)。这句话背后的工程判断是:小团队最缺的不是算力,而是把一堆基础设施拼起来的时间。Supabase 把时间成本压到最低,同时把扩展的主动权留给用户——需要更大实例、只读副本、连接池时,平台提供开关,而不是逼你重写架构。
愿景落地的三条主线:
- 开源优先:核心组件(PostgREST、GoTrue、Realtime、Storage)全部 MIT/Apache 许可,代码公开可审计。
- 可组合:你不必全用。只用数据库和认证、其余自己写,完全可行。平台是积木不是铁桶。
- 企业级底线:RLS、审计日志、私有网络、SLA 都给到,让它在创业玩具和生产系统之间都能站住。
一个展开案例:从零起一个博客后端
背景:两个人想做技术博客,要求有作者账号、文章表、评论、图片上传,两周上线。
操作:用 Supabase 建项目,跑上面那张 profiles 表,再加 articles 和 comments:
create table public.articles ( id bigint generated always as identity primary key, author_id uuid references auth.users(id) on delete cascade, title text not null, body text, published boolean default false, created_at timestamptz default now() ); create table public.comments ( id bigint generated always as identity primary key, article_id bigint references public.articles(id) on delete cascade, user_id uuid references auth.users(id) on delete cascade, content text not null, created_at timestamptz default now() ); alter table public.articles enable row level security; alter table public.comments enable row level security; -- 已发布文章任何人可读 create policy "公开读文章" on public.articles for select using (published = true); -- 作者本人可增改删自己的文章 create policy "作者管自己文章" on public.articles for all using (auth.uid() = author_id) with check (auth.uid() = author_id); -- 登录用户可评论 create policy "登录可评论" on public.comments for insert with check (auth.uid() is not null); -- 评论公开可读 create policy "评论公开读" on public.comments for select using (true);
结果:两人不用写任何后端服务,仅用 SQL 策略就拥有了"登录、发文章、审核后公开、评论"的完整权限模型。前端用 supabase-js 直接查 articles 表即可。
解读:这个案例说明 Supabase 的"快"来自把权限下沉到数据库。你省掉的是一整层 API 鉴权代码,代价是要花心思把 RLS 写对——策略写错,要么漏权要么误杀。
变式:如果后续要做全文搜索,不用另接 ES,直接建 tsvector 列加 GIN 索引,配合 websearch_to_tsquery 即可,依然不离开 Postgres。
把这一节收个尾
- Supabase 的核心定位是"Postgres 即平台",所有能力挂在同一个数据库上。
- 统一中枢带来数据模型统一、生态继承、可控三件实事。
- 愿景是缩短从原型到规模化的距离,底线是企业级能力。
提醒:别把 Supabase 当"不用学数据库"的捷径。RLS 写错比手写鉴权更隐蔽,因为错误发生在数据层。
建议:我们建议小团队先用托管云跑通 MVP,等数据量和权限复杂度上来后再评估自托管,不要一上来就自己运维一套。
下一节我们把 Supabase 和 Firebase 摆到一起,看开源这条路到底换来了什么、又放弃了什么。