1.2 对比 Firebase:开源与可扩展性
1.2 对比 Firebase:开源与可扩展性
一个数字先摆出来:Firebase 是 2011 年成立、2014 年被 Google 收购的产品;Supabase 是 2020 年才发布的项目。两者都解决"少写后端"的问题,但底层哲学完全相反——一个用闭源 NoSQL 和私有协议把体验做到极致顺滑,一个用开源 Postgres 把控制权和可移植性放在第一位。这一节我们用工程视角拆开对比,而不是喊口号。
数据模型的本质差异
Firebase 实时数据库和 Firestore 是文档型 NoSQL,数据以嵌套 JSON 树组织。优点是无 schema、写入快、天然适合层级结构;缺点是深层嵌套后查询困难,联表(或者说"联文档")基本靠冗余数据或客户端拉取,复杂关系建模很别扭。
Supabase 用 Postgres,关系、约束、事务、JOIN 都是一等公民。同样是"用户-订单-商品",在 Postgres 里是三张表加外键,在 Firestore 里往往要把订单嵌进用户文档或反过来,一旦要"按商品统计销量"就得扫全库。
-- Supabase 侧:一个带约束的关系模型,金额不能为负 create table public.orders ( id bigint generated always as identity primary key, user_id uuid references auth.users(id), product_id bigint references public.products(id), amount numeric(10,2) check (amount >= 0), created_at timestamptz default now() ); -- 想统计某商品销量,一条 SQL 解决 select product_id, count(*) from public.orders group by product_id;
Firestore 要做同样的聚合,要么预写累计字段、要么用聚合查询扫集合,扩展性和准确性都更难保证。这是"关系 vs 文档"的老话题,但在 BaaS 选型里被放大了:你的数据如果关系性强,选 Supabase 省心;如果是弱 schema 的海量设备上报,Firebase 上手更快。
供应商锁定与可移植性
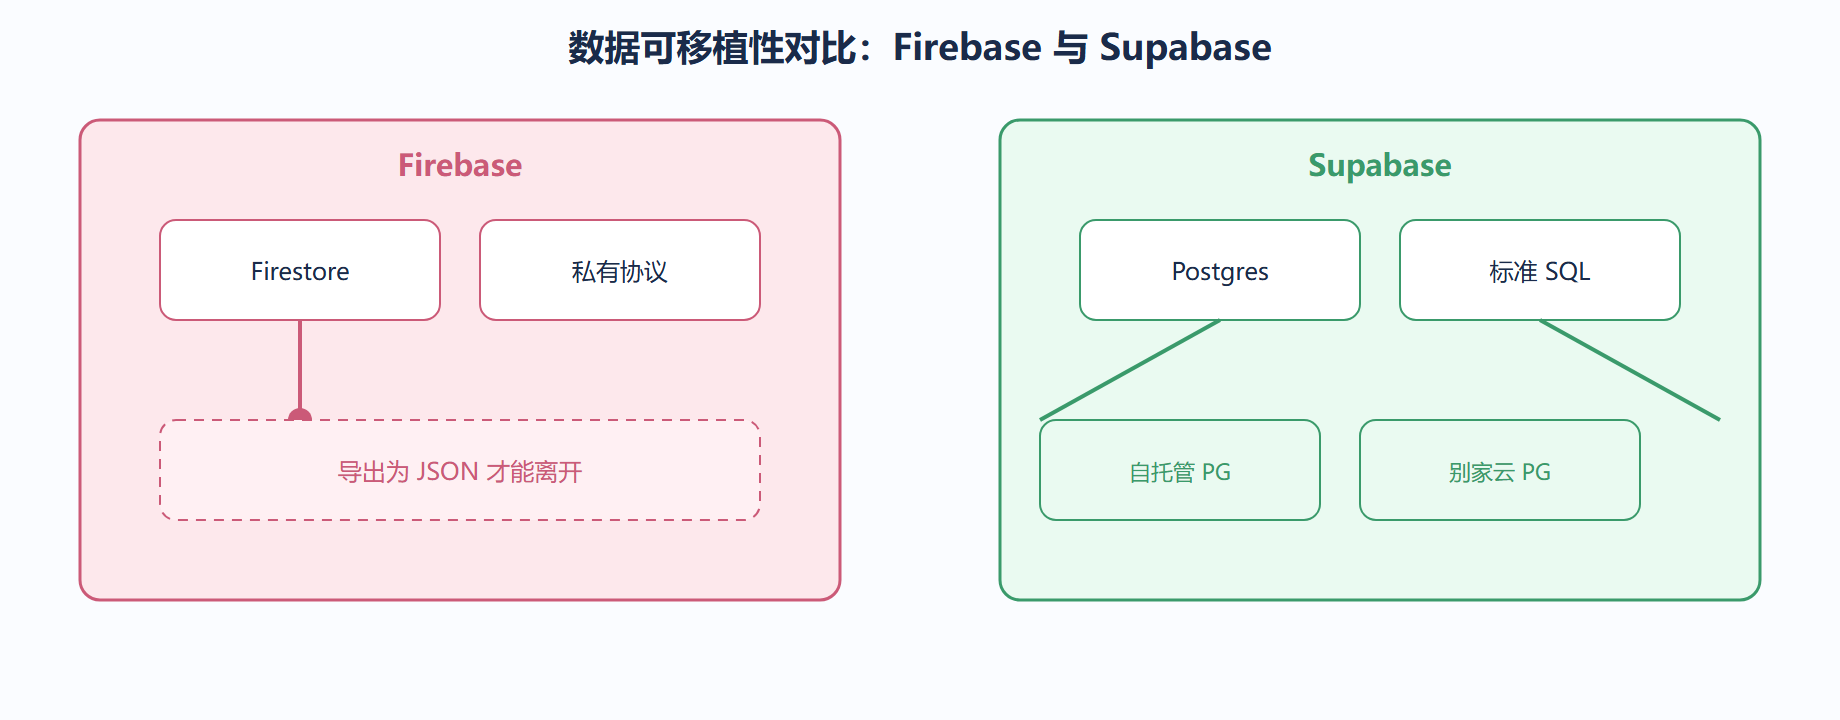
这是两者最硬的鸿沟。Firebase 闭源,数据导出是 JSON 文件,想迁移到自建系统要自己重写整层访问逻辑,实时监听、规则引擎都得重做。Supabase 的核心就是 Postgres,你随时能 pg_dump 把整个库导出成标准 SQL,连同 RLS 策略、函数一起走人,换到任何托管或自托管 PG 上都能跑。
下面这张 SVG 对比了"数据出口"的差异——左边 Firebase 的数据被困在私有格式里,右边 Supabase 的数据是标准 Postgres 可自由流向别处。
查询能力与扩展性
Firestore 的查询是为"单集合内按字段过滤+排序"设计的,跨集合 JOIN 不支持,深分页靠游标。Supabase 这边,PostgREST 把 SQL 的表达力几乎完整暴露成 HTTP 查询参数,还能写视图和函数封装复杂逻辑。
可扩展性上,Firebase 由 Google 全托管,自动扩容到很大规模,你基本不用操心;代价是账单随用量陡峭上升,且你无法调底层参数。Supabase 云也是托管,但底层是你可以调的 Postgres——加索引、改 work_mem、开只读副本、上连接池(PgBouncer)都由你决定。简单说:Firebase 把扩展做成黑盒自动化,Supabase 把扩展做成可调旋钮。
实时能力的实现路径
Firebase 实时数据库原生就是为实时推送设计的,监听一个节点就能收变更,延迟低、体验顺。Supabase 的 Realtime 走的是另一条路:读 Postgres 的 WAL,把变更通过 WebSocket 广播。早期版本只支持基于主键的监听,现在支持表级和行级过滤、广播(broadcast)和 Presence(在线状态)。
// Supabase 实时:监听 orders 表里某用户的插入 import { createClient } from '@supabase/supabase-js' const supabase = createClient(SUPABASE_URL, SUPABASE_ANON_KEY) const channel = supabase .channel('orders-feed') .on( 'postgres_changes', { event: 'INSERT', schema: 'public', table: 'orders', filter: 'user_id=eq.' + userId }, (payload) => { console.log('新订单:', payload.new) } ) .subscribe() // 控制台会打印类似:新订单 { id: 42, amount: 99.00, ... }
Firebase 的同功能代码更短,但 Supabase 这边你拿到的是真实数据库行,能直接 JOIN 出关联信息再推送,不用在客户端拼装。
展开案例:一个计价服务该选哪个
背景:某 SaaS 要做一个"按调用次数计费"的后台,需要精确事务(扣额度、记账单、发通知要么全成功要么全回滚),数据强一致。
操作与对比:
- Firebase 方案:Firestore 事务只能在单文档或有限跨文档内保证,跨"用户额度"和"账单"两个集合做原子扣减要写成分布式事务,且无法保证和通知系统的原子性,容易出"扣了钱没记账单"。
- Supabase 方案:在 Postgres 里一个函数内用事务包住扣额度和插账单:
create or replace function public.charge(user uuid, cents numeric) returns boolean language plpgsql as $$ declare bal numeric; begin select balance into bal from public.wallets where user_id = user for update; if bal < cents then return false; end if; update public.wallets set balance = balance - cents where user_id = user; insert into public.bills(user_id, cents) values (user, cents); return true; end; $$;
结果:Supabase 用一条 select public.charge(...) 就完成了强一致扣费;Firebase 则要绕开 NoSQL 的弱事务模型,引入额外对账任务。
解读:当业务有"钱/库存/配额"这类强一致需求时,Postgres 的事务模型是硬优势,Firebase 的文档模型要花很大代价补这块。
变式:如果是"高频设备心跳上报、偶尔丢几条无所谓"的场景,Firebase 的写入吞吐和零运维反而更香。选型别只看阵营,看数据特性。
本节要点回顾
- 数据模型:Firebase 文档型、Supabase 关系型,强关系场景选后者。
- 可移植性:Supabase 是标准 Postgres,迁移自由;Firebase 闭源,出口受限。
- 实时与扩展:Firebase 黑盒自动化,Supabase 可调旋钮、强一致。
⚠️ 不要因为"开源"就盲选 Supabase。如果你的数据本就是弱 schema、要全球极低延迟写入,Firebase 可能更省力。
💡 我们给的选法:关系性强、要事务、怕锁定 → Supabase;弱 schema、要极致顺滑实时、不在意锁定 → Firebase。两者都能用,关键是匹配数据形态。
下一节我们提炼 Supabase 自己的设计哲学——开放、可组合、企业级,看它怎么把"开源"变成工程原则。