4.3 部署与运维
4.3 部署与运维
直接定义:部署在这里指"把本地开发好的数据库结构、函数、配置,可靠地同步到云端生产环境",而不是把代码打包扔服务器。Supabase 的运维重心在迁移版本化、环境隔离、备份恢复。这一节我们把这套流程走通,并讲清多环境怎么管。
迁移是部署的核心
前面反复强调结构走迁移。部署本质就是 supabase db push 把本地 supabase/migrations/ 里的 SQL 按时间顺序应用到云端。好处是可回滚、可评审、可重复。
# 关联云端项目(只需一次) supabase link --project-ref <ref> # 把本地迁移推上去 supabase db push # Applying migration 20240102_profiles.sql ... ok
⚠️ db push 是"应用尚未应用的迁移",不会覆盖云端手动改动的结构——如果你曾在 Dashboard 手动加过列又没进迁移,push 后两者可能冲突或并存,务必保持单一真相源。
多环境:本地 / 预发 / 生产
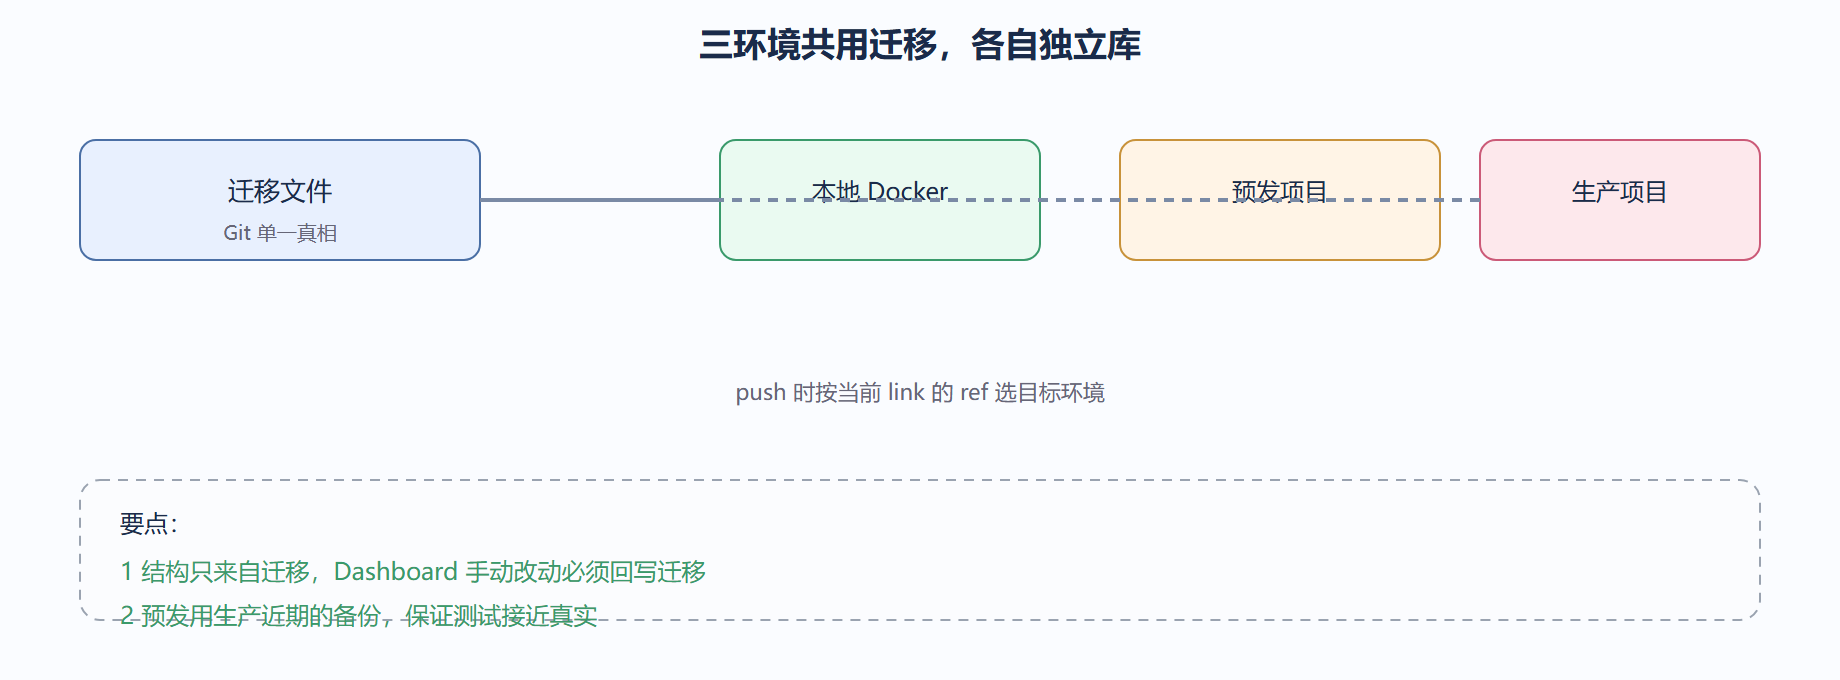
推荐三环境隔离,靠不同 project ref 区分。本地用 Docker,预发和生产各一个云端项目。CI 里根据分支决定推哪个:
# CI 脚本伪逻辑(按分支选 ref) if [ "$BRANCH" = "main" ]; then supabase link --project-ref $PROD_REF else supabase link --project-ref $STAGING_REF fi supabase db push supabase functions deploy --project-ref $ref
下面 SVG 画了三环境如何共用一套迁移文件、各自独立库:
函数与配置的部署
函数单独 deploy,配置(如 Auth 的提供商、存储桶)在 Dashboard 或项目设置里配,建议也文档化。
# 部署全部函数 supabase functions deploy # 部署单个 supabase functions deploy pay-webhook
备份与恢复
云端付费层提供自动备份(时间点恢复 PITR)。自建或免费层要自己 pg_dump:
# 导出整个库(结构+数据)到文件 pg_dump "$DATABASE_URL" > backup_$(date +%F).sql # 恢复 psql "$DATABASE_URL" < backup_2024-01-01.sql
注意:pg_dump 导的是数据 + DDL,但 Supabase 的 Auth 用户存在 auth schema,默认 pg_dump 也能带出,恢复时注意不要和现有 auth 冲突。
展开案例:一次误删表的回滚
背景:运维在 Dashboard 误点删了 profiles 表,生产报错。
操作过程:
- 确认有昨天的自动备份(付费层 PITR 保留 7 天)。
- 通过 Studio 的 Database → Backups 选"恢复到时间点",指定删除前 5 分钟。
- 系统克隆出一个恢复后的库,验证
profiles回来了、数据完整。 - 把恢复库提升为新主库,旧主库下线。
若没有自动备份,则用本地/历史 pg_dump 文件 psql 导入,缺失删除后到备份点之间的增量数据(需从业务日志补)。
结果:服务在半小时内恢复,RPO(恢复点目标)约为删除前最近一次备份。
解读:这起事故再次证明"结构走迁移 + 数据有备份"是两条命。Dashboard 误操作的代价靠备份兜住,但增量数据仍可能丢——所以关键写操作前先确认备份新鲜度。
变式:异地容灾可把备份定期 pg_dump 到另一云的对象存储,避免单云故障。Supabase 云本身有跨区冗余,但自建合规场景常要求独立副本。
本节要点回顾
- 部署核心是迁移
db push,多环境靠不同 ref 隔离。 - 函数单独 deploy,配置要文档化。
- 备份用 PITR 或 pg_dump,恢复前确认新鲜度。
⚠️ db push 不会主动覆盖云端手动结构改动。若你一边在 Dashboard 改、一边推迁移,结构会出现"双真相"冲突。团队必须约定单一真相源 = 迁移文件。
💡 我们建议给生产项目开 PITR(若预算允许),并把 pg_dump 作为额外离线副本。备份这事,等出事再想要么贵要么来不及。
迁移出错时的回退手法
db push 是把迁移按序应用,但偶尔某条迁移写错(如忘了 if exists),会导致 push 中途失败、状态半应用。下面是标准的"止血—回退—修正"流程:
# 1. 看当前已应用哪些迁移(本地/云端都看) supabase migration list # 2. 若需要整体回退到某版本(云端用 supabase db reset --version 仅本地) supabase db reset --version 20240102_profiles
对于已经应用到云端、又想撤销的单条错误迁移,正确做法是写一条"反向迁移"而不是手动在 Dashboard 删——这样回退本身也可版本化:
-- 20240104_rollback_bad.sql:抵消 20240103 的影响 alter table public.profiles drop column if exists wrong_col;
💡 关键直觉:迁移只能向前叠加,不能直接"撤销历史"。所谓回退,是再写一条新迁移把改动抵消掉。这保证了任何环境只要顺序应用全部迁移,最终结构都一致——这是迁移体系能跨多人、跨环境同步的底层逻辑。
再展开一个案例:CI 里迁移冲突的排查
背景:两位同事各自加了迁移,本地都跑通,但合并后 CI 的 db push 报"relation already exists"。
操作过程:
- 看
migration list,发现两人都生成了create table logs,但版本号(时间戳)不同,导致都尝试建同名表。 - 约定重命名冲突迁移,统一由后合并者负责合并顺序:
# 后合并者把冲突迁移改名、顺延时间戳 supabase migration new add_logs_v2 # 把内容写进新文件,并删掉旧的重复迁移
- 本地
db reset清空重跑全部迁移,确认无冲突。 - 把修复后的迁移集推上预发,CI 通过。
结果:结构在预发和生产恢复一致,CI 绿灯。
解读:迁移的时间戳就是它的"全局序号",两个人同一秒生成的迁移会撞序。团队约定"合并前先 rebase、冲突时后合并者负责顺延",能从流程上消除这类冲突。
⚠️ 常见坑:有人为解冲突直接手动在 Dashboard 把云端表改了,以为"云端对了就行"。但下一次任何人 db push,本地迁移和云端现状不一致会触发更复杂的冲突。记住:云端结构必须以迁移为准,手动改只是临时止血,必须尽快补回迁移。
下一节讲故障排除与调试:常见错误怎么定位、日志怎么看、RLS 怎么测。