4.4 故障排除与调试
4.4 故障排除与调试
场景代入:前端报 400 Bad Request,但控制台只有一句 "Could not find the table"。你第一反应去查前端代码,其实根因可能是 RLS 把表"藏"了——匿名用户因策略看不到表,PostgREST 就返回找不到。这一节我们整理最常见的几类故障、定位路径、和调试手法,让你少走弯路。
从一个真实报错说起
Studio 的 Logs 面板分 API、Auth、Database、Functions、Realtime。排错第一原则:先去对应日志看原始错误,再回头看代码。下面用 SQL 直接查数据库日志里的近期错误(等价于看 Database 日志但更可控):
-- 查看近期数据库错误(需 pg_stat_activity / 日志表权限) select datname, pid, state, query, wait_event_type from pg_stat_activity where state <> 'idle' order by query_start desc limit 20; -- 输出能暴露卡住的查询、等待锁的会话
RLS 导致的"表不存在"假象
最经典的坑:客户端用 anon key 查一张未开 RLS 策略的表,PostgREST 因权限不足而报 Could not find the table。这不是表没了,是权限层把表对匿名用户屏蔽了。
调试手法:用 service_role(绕过 RLS)在 SQL Editor 跑同一条查询,若能返回,说明表在、是 RLS 挡的。
-- 在 SQL Editor 用管理员上下文测试(注意这里不演示密钥) -- 若管理员能查、匿名不能,问题在策略 select count(*) from public.some_table;
修复:给该表补合适的策略,或确认是否真的要匿名可读。
实时收不到推送
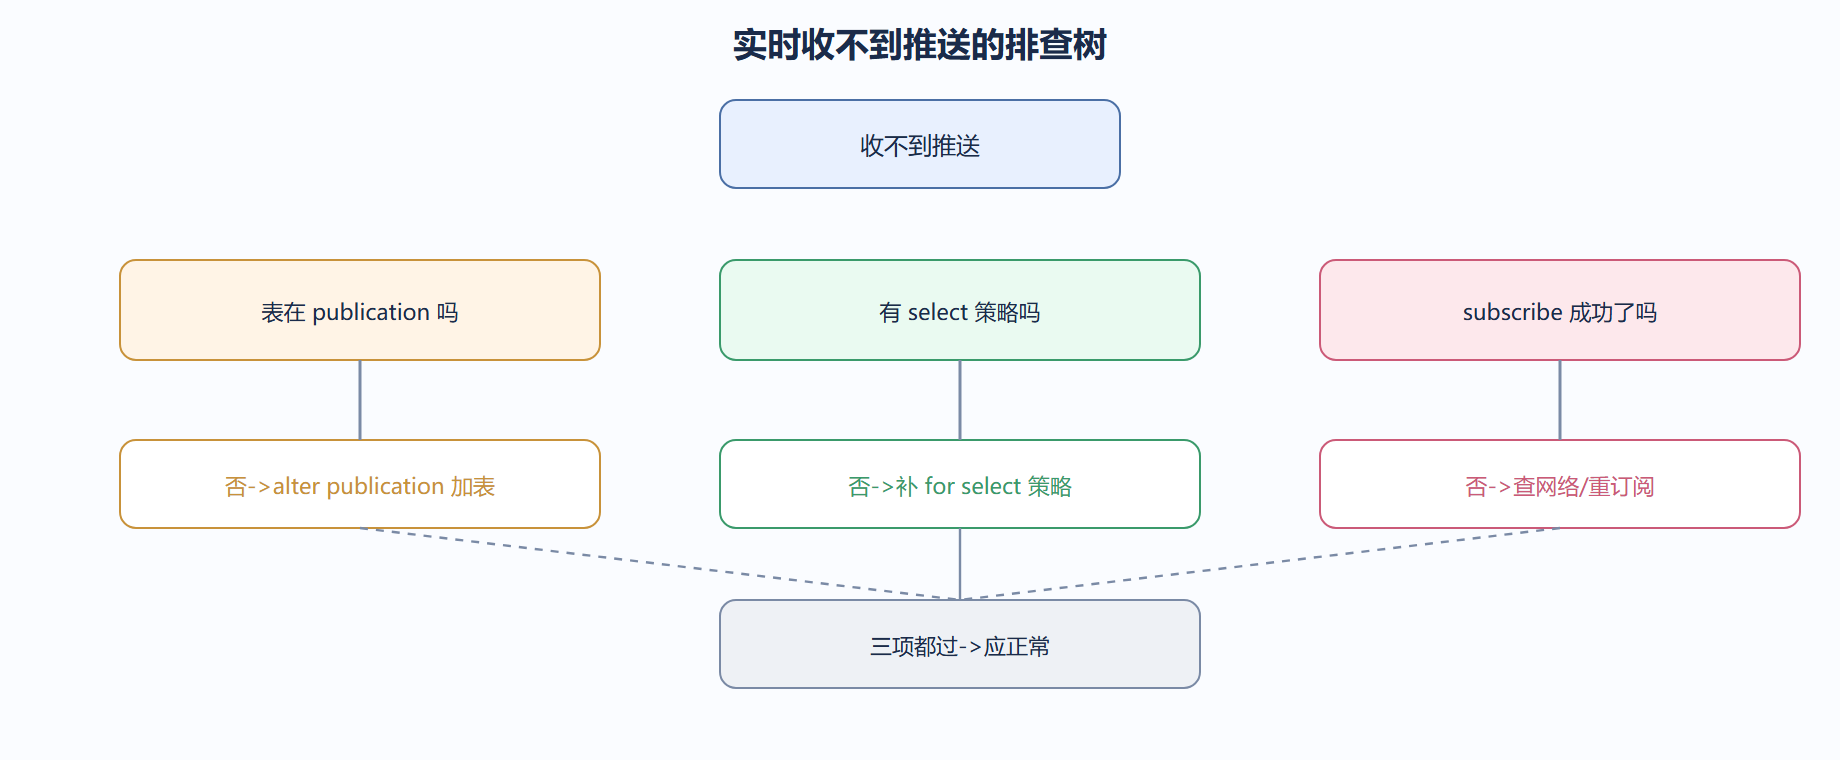
常见原因清单:
- 表没加进
supabase_realtimepublication。 - 客户端没开对应 select 策略,RLS 把变更过滤掉了。
- 频道
subscribe后没等SUBSCRIBED状态就发消息。
const channel = supabase.channel('r').on('postgres_changes', { event: '*', schema: 'public', table: 't' }, () => {}) channel.subscribe((status) => { if (status === 'SUBSCRIBED') console.log('已订阅,可以收推送了') })
下面 SVG 把"实时收不到"的排查路径画成决策树,按图走能快速定位:
函数部署后 500 错误
Edge Function 返回 500,多半是代码抛异常或环境变量缺失。调试方法:
# 本地用 CLI 跑函数,直接看堆栈 supabase functions serve hello # 另开终端发请求,观察终端报错 curl -X POST http://127.0.0.1:54321/functions/v1/hello \ -H "Authorization: Bearer <anon>" -d '{}' # 终端打印 Deno 运行时错误堆栈
常见坑:没在 Dashboard 的 Function 设置里填 SUPABASE_SERVICE_ROLE_KEY 等环境变量,函数里 Deno.env.get 拿到 undefined 导致后续连接失败。
展开案例:一次 N+1 式的慢查询定位
背景:某页面加载要 8 秒,前端怀疑是 Supabase 慢。
操作过程:
- 开 Database 日志,发现同一秒内对
comments发了 200 条独立查询(前端循环里逐个select)。 - 确认是前端"先查文章列表,再对每篇循环查评论"导致的 N+1。
- 改法一:用 Postgres 的
json_agg在一条 SQL 里聚合评论:
select a.id, a.title, (select json_agg(c order by c.created_at) from public.comments c where c.article_id = a.id) as comments from public.articles a limit 20;
- 改法二:前端用 supabase-js 的嵌套 select:
.select('id, title, comments(*)'。 - 重测:8 秒降到 120 毫秒。
结果:瓶颈不在 Supabase,而在前端查询模式。一次聚合查询替代两百次往返。
解读:很多"Supabase 慢"的投诉,根因是客户端触发了大量小查询。把能下推的聚合放进一条 SQL,既快又省连接。
变式:若评论量极大,聚合会变重,应分页加载评论(前端滚动再按需查某篇的评论),而非一次全拉。
三句话带走本节
- 排错先看 Logs 对应分类,再回代码。
- "表找不到"可能是 RLS 屏蔽,用管理员上下文验证。
- 实时收不到按 publication/策略/订阅三处查;慢查询常是 N+1。
提醒:不要在 RLS 策略出错时改用 service_role 绕过它来"让功能跑通"——这等于关掉安全来修 bug。正确做法是修策略,不是撤防御。
建议:我们建议把"用管理员上下文验证表是否真在"作为排 RLS 问题的第一步,能立刻区分是表问题还是权限问题,省一半时间。
排错清单:按症状对号入座
把前面零散的坑收成一张"症状 → 第一怀疑点 → 验证手段"的速查表,临场不用翻全文:
| 症状 | 第一怀疑 | 快速验证 |
|---|---|---|
Could not find the table |
RLS 屏蔽匿名 | 用 service_role 查,能查到就是 RLS |
| 实时收不到推送 | 没加 publication | 查 select * from pg_publication_tables |
| 函数 500 | 环境变量缺失 / 抛异常 | functions serve 看堆栈 |
| 查询慢 | 缺索引 / N+1 | explain analyze + 看 DB 日志 |
| 写入偶发失败 | RLS with check 不满足 | 用对应用户上下文重跑该写 |
| 连接数爆 | 前端直连未池化 | 改连 6543 池化端口 |
💡 关键直觉:Supabase 的故障九成集中在"权限(RLS)"和"查询模式(N+1/缺索引)"两类。拿到报错先归类到这两类,比盲目搜错误文案快得多。日志面板就是为这两类准备的——API 日志看权限拒绝,Database 日志看慢查询。
再展开一个案例:JWT 过期导致的间歇失败
背景:一个已上线的应用,用户每隔一小时左右就出现"突然读不到自己数据",刷新页面又好了。
操作过程:
- 看 API 日志,失败请求都带
401: invalid JWT或JWT expired。 - 怀疑客户端没处理 token 刷新——supabase-js 默认会在 token 快过期时静默刷新,但若前端在 SSR(服务端渲染)里缓存了旧 token,刷新逻辑没触发。
- 在客户端显式监听 auth 状态、确保用浏览器侧的客户端做请求:
// 确保请求走带刷新能力的浏览器客户端 supabase.auth.onAuthStateChange((event, session) => { if (event === 'TOKEN_REFRESHED') console.log('token 已续期') })
- 服务端脚本若要用长期凭证,改用
service_role而非用户 JWT,避免过期问题:
const admin = createClient(URL, Deno.env.get('SUPABASE_SERVICE_ROLE_KEY')!)
结果:间歇失败消失,用户不再被踢。
解读:这类"过段时间就挂"的故障,特征就是跟时间相关(token 有效期、缓存 TTL、连接空闲超时)。排错时先看"是不是周期性",能立刻把范围缩到会话/连接类问题。
⚠️ 常见坑:有人为绕过 token 过期,直接在前端用 service_role 调接口——这等于撤掉全部 RLS,把数据库裸给全网。token 会过期是安全设计,正确做法是修刷新逻辑,绝不是换密钥绕过。
下一节我们站在更高处看架构演进与未来趋势:业务长大了,Supabase 这套怎么跟着长。