4.5 架构演进与未来趋势
4.5 架构演进与未来趋势
一句行话:Supabase 适合"从周末原型长到百万用户",但它不是银弹——业务长到一定规模,你会遇到它当前能力的边界,那时要么绕、要么补、要么迁出部分。这一节我们讲架构怎么随业务演进,以及 Supabase 自己的方向(向量、分支、边缘)意味着什么。
演进路线:单体库 → 读写分离 → 模块化拆分
大多数 Supabase 项目的成长路径:
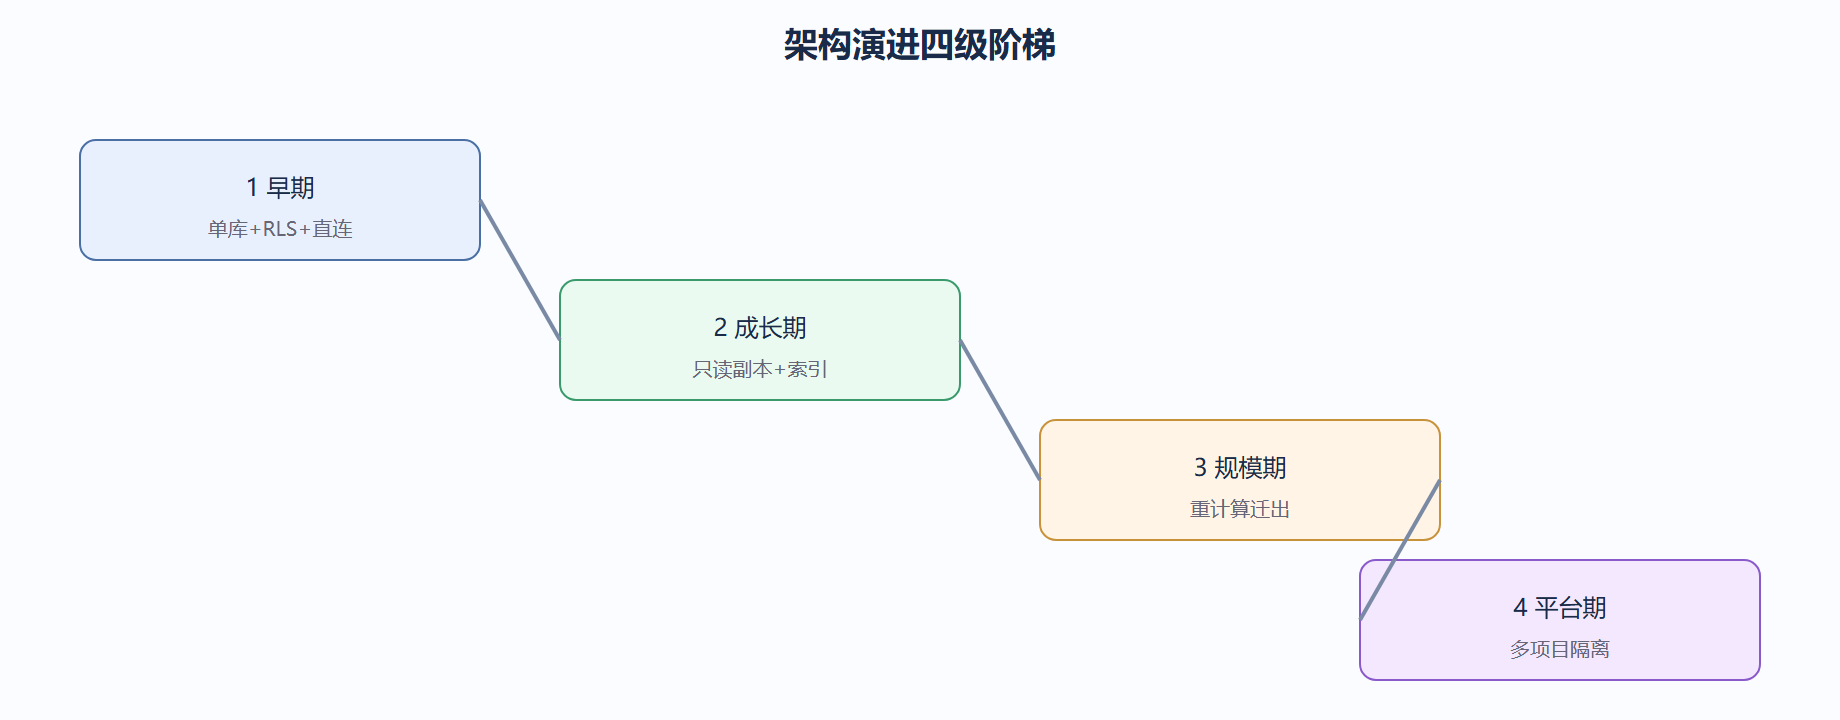
- 早期:一个 Postgres 实例装下所有表,RLS 管权限,前端直连。简单、快。
- 成长期:读多写少,加只读副本分流;热点表加索引、做分区。
- 规模期:某些能力(如重型分析、文件转码)迁出到独立服务,Supabase 退居"核心事务 + 认证 + 实时"中枢。
- 平台期:多团队共用,靠 schema 隔离或独立项目拆分,配合数据库分支做环境。
下面 SVG 把这条演进画成四级阶梯,每级标注典型动作:
什么时候该补、该绕、该迁
- 补:加索引、开副本、用 pgvector 做相似检索——仍在 Supabase 内解决。
- 绕:重型批处理、视频转码、复杂 ETL,用外部 worker 或消息队列,Supabase 只做触发器和结果落库。
- 迁:若某模块和 Postgres 关系弱、又要极致吞吐(如海量设备遥测),可迁到专用时序库或流处理,Supabase 留作用户/权限/业务交易。
我们的判断:Supabase 的最佳位置是"业务系统的可信中枢",而不是"所有数据的终点"。把不适合关系模型的数据请出去,反而让它更稳。
Supabase 自身的方向
从近年的发布看,三个明确方向:
- 向量与 AI 工具:pgvector 集成 + 嵌入生成函数,让"语义搜索/推荐"直接发生在数据库内。适合做 RAG 类应用的知识库。
- 数据库分支(Branching):像代码分支一样复制数据库,让测试环境有真实数据副本而不碰生产。
- 边缘化:Edge Functions 已跑在边缘,未来认证、代理也可能更靠近用户,降延迟。
-- 向量检索示例:找和某段文字最相似的文档 create extension if not exists vector; select id, title from public.docs order by embedding <=> openai_embedding('查询文本') -- 余弦距离 limit 5; -- 返回最相近的 5 篇
这把"搜索"从外部 ES 拉回 Postgres,进一步收敛技术栈。
展开案例:分析报表从 Supabase 迁出的取舍
背景:某 SaaS 在 Supabase 里直接跑每日聚合报表,数据量到亿级后,聚合查询严重拖慢主库,影响线上写入。
操作过程:
- 评估:报表是只读分析,和核心交易耦合只会互相拖累。
- 方案:用逻辑复制把关键表同步到独立的分析库(或数据仓库),报表查询走分析库。
- Supabase 侧只保留核心交易与实时,分析流量隔离。
-- 在源库配置发布,供逻辑复制使用(示意) alter publication supabase_realtime add table public.orders; -- 分析侧订阅该发布,拉取增量做列式存储
- 结果:主库写入延迟恢复,报表在独立库跑不相互影响。
解读:这是"该迁"的典型。分析型负载和交易型负载对数据库的要求相反(前者要大扫描、后者要低延迟写入),硬塞一起两败俱伤。Supabase 支持逻辑复制,迁出成本不高。
变式:若分析量还没到大到独立仓库,可先在 Supgres 内用物化视图预聚合,定时 refresh,避免每次实时算——这是"补"而非"迁"的折中。
本节要点回顾
- 架构随业务从单库走到读写分离、模块拆分、多项目隔离。
- 适合关系模型留 Supabase,重分析/遥测可逻辑复制迁出。
- Supabase 方向:向量 AI、数据库分支、边缘化,进一步收敛技术栈。
⚠️ 别把 Supabase 当万能数据仓库。亿级数据的聚合报表放在主库跑,会拖垮线上交易。分析负载该隔离就隔离,逻辑复制让它迁出不难。
💡 我们建议以"关系+事务+权限"为取舍标尺:落在这三件事上的数据留在 Supabase,超出它的交给专用系统,用复制或事件桥接。这样它始终是中枢而非瓶颈。
演进期的典型技术债与还债点
架构长大过程中,有些债是必经的,关键是在哪个规模还。下面按用户量级给个粗略的"还债时刻表",帮你在对的时点做对的动作,而不是过早优化或迟迟不动:
| 规模信号 | 该还的债 | 动作 |
|---|---|---|
| 单表超百万行且查询变慢 | 缺索引 / 未分区 | 补复合索引,热点表按时间分区 |
| 读流量压倒写 | 没用只读副本 | 开副本,列表查询走副本连接串 |
| 分析报表拖慢主库 | 分析交易混库 | 逻辑复制到独立分析库 |
| 多团队抢同一库 | schema 无隔离 | 按团队拆 schema 或独立项目 |
| 测试库污染生产 | 无数据库分支 | 用 Branching 复制真实副本 |
💡 关键直觉:演进不是"一步到位上最复杂的架构",而是"让架构始终比业务重一点、但不过度"。过早分库分表会拖慢开发,过晚则线上事故。上表的信号就是你的触发器——出现信号才动,没出现就忍住。
再展开一个案例:热点表分区救活写入
背景:某 IoT 场景的 sensor_readings 表半年涨到 8 亿行,插入开始变慢、主键索引膨胀。
操作过程:
- 确认写入按时间分布,适合按月份范围分区:
-- 建分区主表 create table public.sensor_readings ( id bigint generated always as identity, sensor_id uuid, payload jsonb, created_at timestamptz default now() ) partition by range (created_at); -- 建当月分区 create table public.sensor_readings_2026_01 partition of public.sensor_readings for values from ('2026-01-01') to ('2026-02-01');
- 按
(created_at desc)建分区内索引,老分区可归档 detached。 - 旧分区超过保留期后
detach partition转去冷存储,主表只留近期热数据。 - 插入恢复毫秒级,索引体积大降。
结果:写入瓶颈解除,存储成本因冷热分离下降。
解读:单表无限膨胀是关系库的通病,分区是把"无限"切成"有限窗口"的标准解法。它不改变你的查询写法(应用层几乎无感),却让索引和写入重新轻快。
⚠️ 常见坑:分区键必须出现在所有唯一约束里(含主键),否则建不了分区表。很多人直接把原表改分区会发现主键冲突——正确做法是新建分区主表、迁移数据、再切应用指向。这一步建议在低峰期做,并提前备份。
第四章把生产级能力讲完。第五章我们看生态系统与社区:官方 SDK、社区资源、合作伙伴集成,帮你站在巨人肩膀上少造轮子。