1.1 数据同步挑战与DataX的诞生
1.1 数据同步挑战与DataX的诞生
企业里同时跑着 MySQL、Oracle、Hive、HBase 是常态。当业务要求把 MySQL 的订单表搬到 Hive 做分析,或者把 HBase 的画像同步进 ES 做检索,数据就得在不同存储间流动。这种流动的需求越密,痛点越明显。
点对点同步的复杂度陷阱
最朴素的办法是给每一对「源到目标」写一个搬运脚本。假设有 N 种数据源、M 种目标,最坏情况下要维护 N×M 条链路。每接入一个新存储,就得和其余所有存储各写一条对接。这种网状直连会随着系统增多而爆炸式增长,任何一个源端表结构变更,都可能连锁打挂多条链路。我们把它称为复杂度灾难,因为它不是线性增长,而是乘积增长。
{ "comment": "点对点模式:每对源目标各写一套脚本,维护成本随 N乘M 增长", "mysql_to_hive": "独立脚本 A", "mysql_to_hbase": "独立脚本 B", "oracle_to_hive": "独立脚本 C", "oracle_to_hbase": "独立脚本 D" }
星型拓扑如何降本
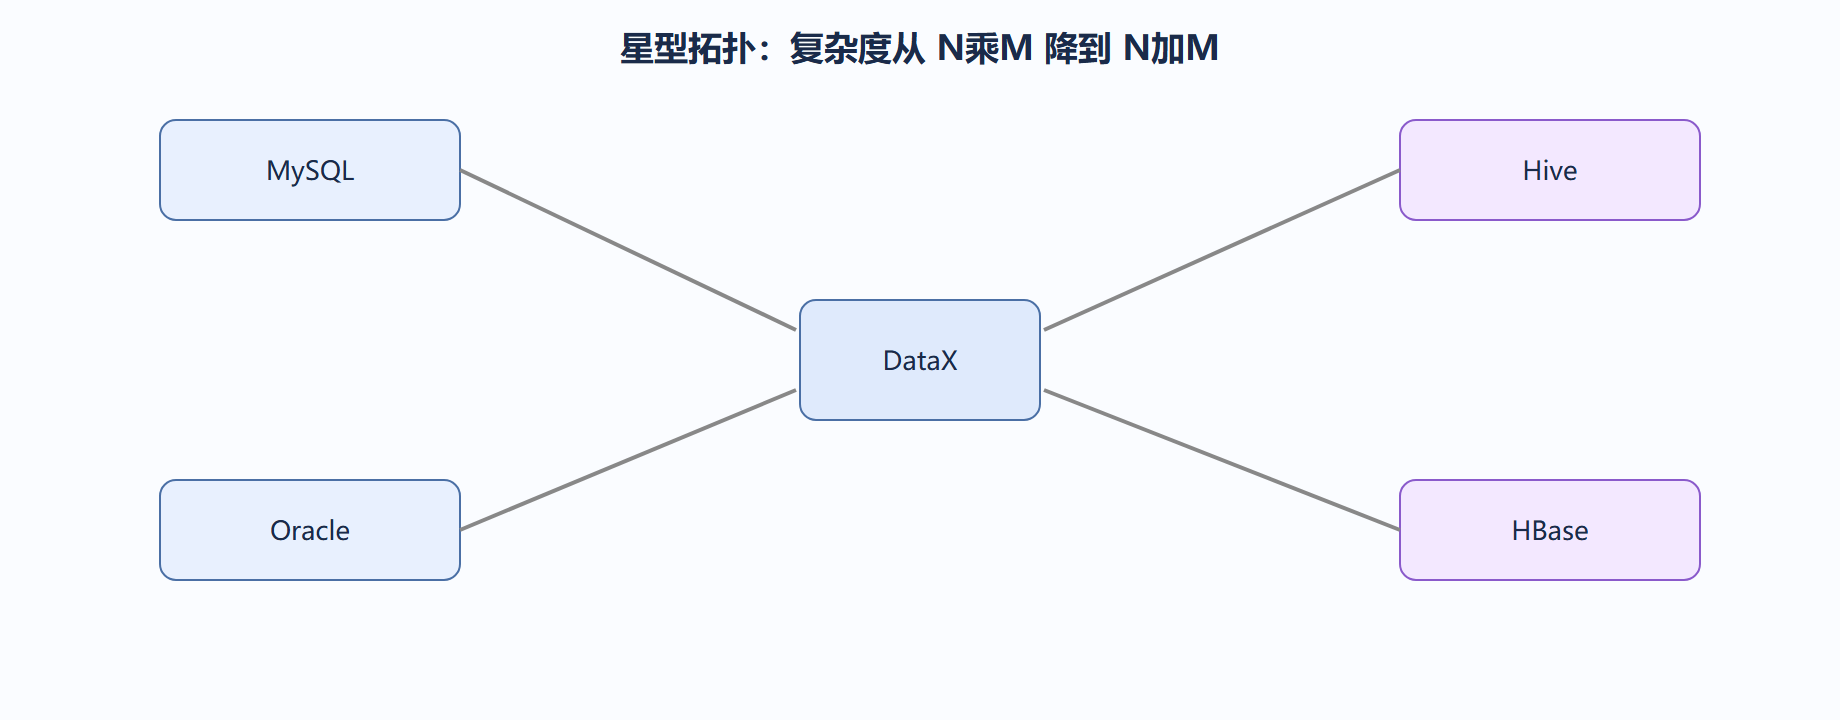
DataX 的思路是把所有源和目标都只对接一个中心。源端只需实现「怎么被读」,目标端只需实现「怎么被写」,中间的调度、并发、缓冲由中心统一负责。链路数从 N×M 降到 N+M:N 个 Reader 加 M 个 Writer,任意组合都能拼。这不是简单的代码复用,而是把对接复杂度从乘积降为求和。
DataX 的来历与定位
DataX 源于阿里内部对离线数据同步的沉淀,后来开源。它专注「离线、批量、异构」三件事,不抢实时流处理的活。理解这个边界很重要:它适合 T+1 报表、存量入湖、跨库备份这类场景,而不是秒级变更捕获。把合适的工具用在合适的场景,比追求一个万能工具更省心。
我们的判断
我们当时接入 DataX,正是被 N×M 的维护成本逼的。接了三个源、四个目标之后,点对点脚本已经难以招架表结构变更。换成 DataX 后,新增一种存储只是写一个插件,而不是写 N 条对接。这种边际成本的下降,是它最实在的价值。
工程上的真实代价
复杂度从乘积降到求和,听起来是数学游戏,落到团队身上是人力账。我们早期维护过五套点对点脚本,每次源端加字段,五个目标端脚本全要改,漏一个就是数据不一致。迁移到 DataX 后,加字段只在 Reader 的 column 里加一列,Writer 对应补一列,一条链路一次改完。这种「改动集中」带来的稳定性,比理论上的复杂度下降更值钱。
| 维度 | 点对点脚本 | DataX |
|---|---|---|
| 新增数据源 | 写 N 条对接 | 写一个插件 |
| 改表结构 | 改 N 条脚本 | 改一处 column |
| 排错 | 各自看日志 | 统一任务视图 |
| 并发控制 | 脚本里手写 | 配置 channel |
我们建议在做技术选型时,把「未来半年要接几个源、几个目标」算进去。源目标少的时候,点对点未必亏;一旦超过三乘三,星型拓扑的边际优势就开始兑现。
延伸与提醒
querySql 与 column 二选一,混用会直接报错。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
preSql 里带 truncate 的任务,上线前必须二次确认目标表名。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
下面这段脚本能直观算出点对点模式下的链路数,对照星型拓扑感受复杂度差异。
# 点对点模式链路数 = 源数 × 目标数 sources = ['MySQL', 'Oracle', 'HBase'] targets = ['Hive', 'ES', 'HDFS'] print('点对点链路:', len(sources) * len(targets)) # 9 print('星型拓扑:', len(sources) + len(targets)) # 6
背景
某业务库每天凌晨要把订单表同步到分析库。早期的做法是用数据库自带的导出命令把数据 dump 成文件,再写一段脚本导入,遇到表结构变更就手工改脚本。这种方式像用人工搬运代替管道:每次都要人盯着,出错概率高,且无法并发。DataX 的出现就是要把「搬数据」这件事工程化、配置化。
操作:用最简配置验证环境
下面这份配置把 MySQL 的数据直接打印到控制台,用来确认 DataX 本身能启动、插件能加载、数据库连接可达,是排查任何同步问题的第一步。
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "username": "etl", "password": "secret", "connection": [ { "jdbcUrl": ["jdbc:mysql://127.0.0.1:3306/demo"], "table": ["t_user"], "column": ["id","name","age"] } ] } }, "writer": { "name": "streamwriter", "parameter": { "print": true } } } ], "setting": { "speed": { "channel": 1 } } } }
启动命令
# 进入 DataX 解压目录后执行,job 路径相对或绝对均可 python bin/datax.py job/demo_mysql_to_stream.json # 若需临时放大 JVM 内存(排查 OOM 前先确认是不是真不够) python bin/datax.py --jvm="-Xms2G -Xmx4G" job/demo_mysql_to_stream.json
结果解读
控制台能看到逐行打印的 id,name,age,日志末尾出现 任务启动时刻、任务结束时刻、总计耗时、读出记录总数、读写失败总数 五要素,且退出码为 0,说明抽取链路完整可用。一旦连接失败,日志会直接抛出 Communications link failure,此时问题在数据库网络而非 DataX 逻辑。
变式
把 writer 换成 hdfswriter,就完成了一次真实落盘同步;把 reader 换成 oraclereader,就覆盖了另一种关系型源。配置结构完全一致,只是插件名与连接参数不同——这正是 DataX 「框架 + 插件」设计的价值:学一套模型,接任意数据源。
同步工具演进对照
| 阶段 | 代表方式 | 痛点 |
|---|---|---|
| 手工脚本 | dump + 导入脚本 | 易错、无并发、难监控 |
| ETL 工具 | Kettle 图形作业 | 重客户端、调度弱、性能一般 |
| 专用同步 | Sqoop(Hadoop 生态) | 强依赖 Hadoop、源端受限 |
| 框架化同步 | DataX | 生态解耦、插件丰富、可独立运行 |
💡 关键直觉:DataX 解决的不是「能不能搬」,而是「能不能稳定、可控、可并发地搬」。理解这一点,才知道后续所有参数都是为了「控制」二字服务。
⚠️ 常见坑:不要一上来就追求「全量 + 高并发」跑生产表。先用 streamwriter 做冒烟,确认字段、类型、网络都正常,再逐步加 channel,否则报错信息会被并发放大,极难定位。