1.2 DataX核心概念与发展历程
1.2 DataX核心概念与发展历程
用 DataX 之前,先认清楚几个反复出现的名词。它们不是营销话术,而是直接对应到配置文件和运行线程的概念。
主线概念一览
Job 是一次同步任务的完整描述,写在 job.json 里。Task 是 Job 被切分后的最小执行单元。TaskGroup 是 Task 的并发容器,控制一组 Task 同时跑。Reader 负责从源端读,Writer 负责向目标写,Channel 在两者之间做内存缓冲。这些词在第二章会展开成架构,这里先建立印象。
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": {} }, "writer": { "name": "hdfswriter", "parameter": {} } } ] } }
发展历程的两条线
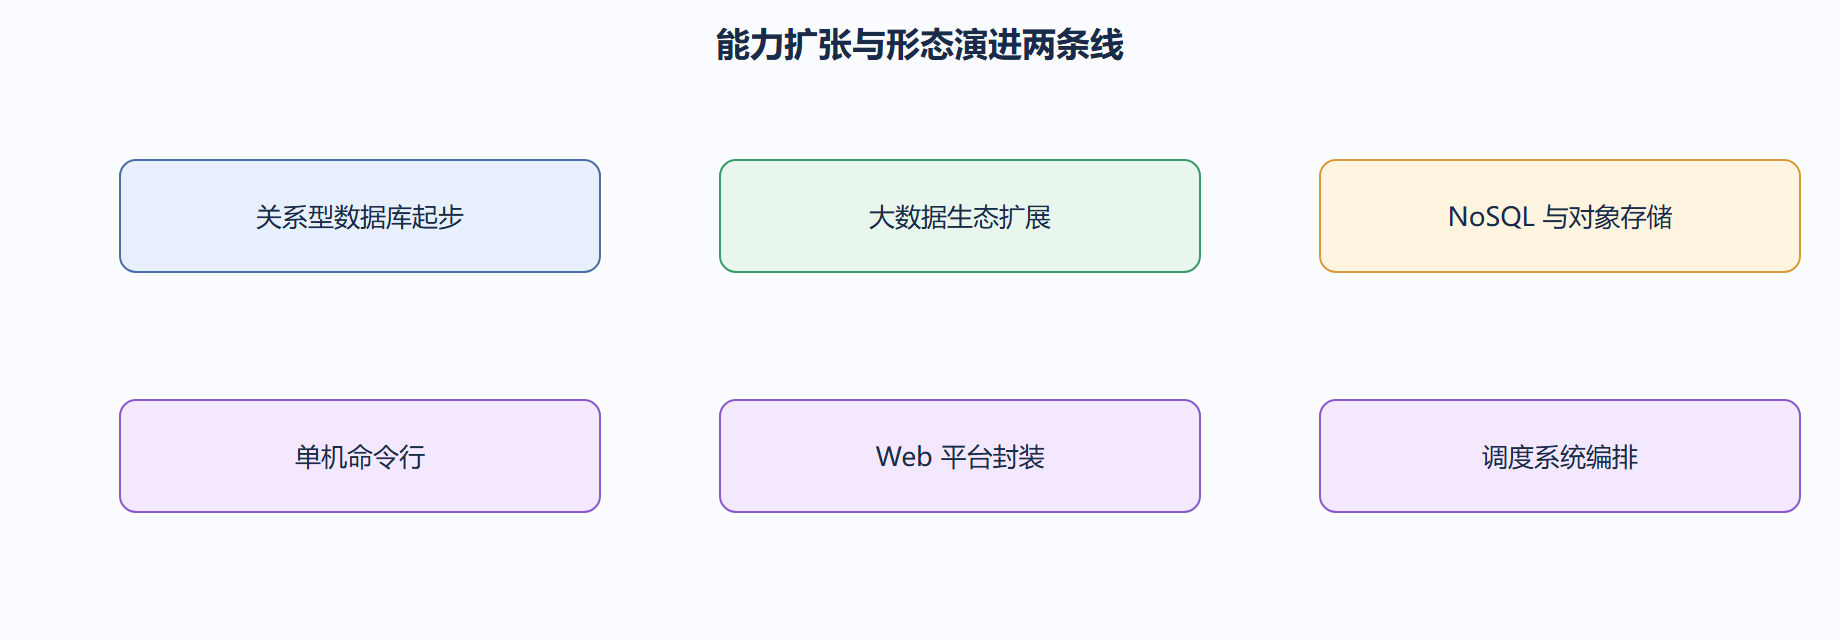
一条线是能力扩张:从最早支持几种关系型数据库,到如今覆盖大数据生态、NoSQL、文件系统甚至对象存储。扩张的动力来自社区按需实现插件,而不是核心重写。另一条线是形态演进:从单机命令行,到被 DataX-Web 这类平台封装成可视任务,再到被调度系统编排进数据中台。
概念如何影响配置
你写的每一个 JSON 字段,几乎都能回溯到一个概念。比如 speed.channel 直接对应 TaskGroup 的并发数;content 数组里的 reader/writer 就是一对 Task 的两端。先记住概念,后面看配置会像看地图而不是看天书。
一个易错点
新手常把 Job 和 Task 混为一谈,以为一个 job.json 只跑一个线程。实际上一个 Job 会被切成多个 Task 并发执行,channel 数决定同时跑几条。后面调优时这个认知会直接影响你对「为什么加了机器没变快」的判断。
名词如何对应到配置
很多初学者卡在「概念和标准会写不对」上。其实 job.json 的每个字段都能回溯到一个概念:setting.speed.channel 对应 TaskGroup 并发数,content 数组里的 reader/writer 对应一对 Task,plugin 目录对应可加载的插件实现。把这些对应关系记熟,看报错时就能快速定位是哪一层的问题。
| 概念 | 配置落点 | 出错时的现象 |
|---|---|---|
| Job | job.content | 结构错导致起不来 |
| Task | splitPk 分片 | 没分片则单线程 |
| Channel | speed.channel | 过大则内存涨 |
| Plugin | plugin 目录 | 找不到 name |
我们带新人时,会让他在纸上画出「一个 job 被切成几个 Task、几个 channel」,再去看日志里的 Task 数是否吻合。这个动作能迅速建立心智模型,比反复读文档有效。
延伸与提醒
Web 平台解决协作与可观测,不提升同步能力本身。
自定义插件最容易踩的坑是依赖冲突,provided 范围能治本。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
Channel 是有界缓冲,填满即触发反压保护内存。
生产环境的稳定性,常常取决于部署习惯而非某个高级特性。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
querySql 与 column 二选一,混用会直接报错。
想知道装了哪些插件,直接列出插件目录即可。
ls plugin/reader/ plugin/writer/ # 1.2 DataX核心概念与发展历程
背景
很多人在读文档时把 Job、Reader、Writer、Channel 当成孤立名词。我们用一份「MySQL 全量同步到 HDFS」的配置,把概念落到具体字段上,看它们如何彼此咬合。
操作:概念对应的真实配置
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/order"], "table": ["t_order"] } ], "column": ["id","user_id","amount","create_time"], "splitPk": "id", "where": "create_time >= '2024-01-01'" } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://nameservice", "path": "/user/hive/warehouse/order_db.db/t_order/dt=20240101", "fileType": "text", "fieldDelimiter": ",", "column": [ {"name":"id","type":"bigint"}, {"name":"user_id","type":"bigint"}, {"name":"amount","type":"double"}, {"name":"create_time","type":"string"} ] } } } ], "setting": { "speed": { "channel": 8 } } } }
启动命令
# 指定日志目录,便于事后回看每个 channel 的吞吐 python bin/datax.py -l job/mysql_to_hdfs.log job/mysql_to_hdfs.json
结果解读
这份配置里,reader.name 决定抽数逻辑、writer.name 决定落盘逻辑、content 把两者绑定成一个同步单元、setting.speed.channel 决定并发水管数。DataX 发展历程正是沿着「把更多数据源做成插件、把更多控制做成参数」这条路推进:从早期只支持少数数据库,到现在覆盖关系型、NoSQL、文件系统、大数据生态。
变式
若想按天分区增量同步,把 where 改成昨天的日期区间,并把 path 里的 dt 改成对应分区即可,无需改动框架层面的任何代码。这种「配置即任务」的演进,让数据同步从写代码变成了填表单。
概念与里程碑对照
| 概念 | 出现的动机 | 你现在怎么用 |
|---|---|---|
| Reader | 抽数逻辑各异 | 选对插件名 + 填连接参数 |
| Writer | 写数逻辑各异 | 选对插件名 + 填目标参数 |
| Channel | 控制并发与内存 | 在 setting.speed 里设 channel |
| Plugin | 解耦框架与数据源 | 把 jar 丢进 plugin 目录 |
💡 关键直觉:DataX 的核心概念不是靠记忆,而是靠「一份配置对应一份现实链路」来理解。每多写一份 job,这些名词就从抽象变成肌肉记忆。
⚠️ 常见坑:把 splitPk 设成字符串类型或非主键列,会直接导致无法切分并发,退化为单 channel 慢同步,且不会报错,只是「莫名其妙很慢」。