2.1 整体架构设计:Job、TaskGroup、Task
2.1 整体架构设计:Job、TaskGroup、Task
本章的架构,落到工程上就是三层切分:用户写一份 Job,框架把它切成 TaskGroup,再切成 Task 并发跑。理解了这层关系,调优参数才有落点。
Job 层:一份配置即一个作业
Job 是用户视角的单位,对应一份 job.json。它声明了要读什么、写到哪、用多少并发、容忍多少错。Job 本身不直接搬数据,它只描述意图,真正的执行由框架翻译成具体线程。
{ "job": { "content": [ { "reader": { "name": "mysqlreader" }, "writer": { "name": "hdfswriter" } } ], "setting": { "speed": { "channel": 5 } } } }
TaskGroup 与 Task:并发的载体
框架先按 channel 数算出需要多少个 TaskGroup,再把 Job 里的每个 reader-writer 对拆成若干 Task。一个 Task 就是「一个 Reader 线程 + 一个 Writer 线程 + 它们之间的 Channel」。TaskGroup 是一组 Task 的容器,负责把并发限制在某个量级上,避免一下子起太多线程把机器拖垮。
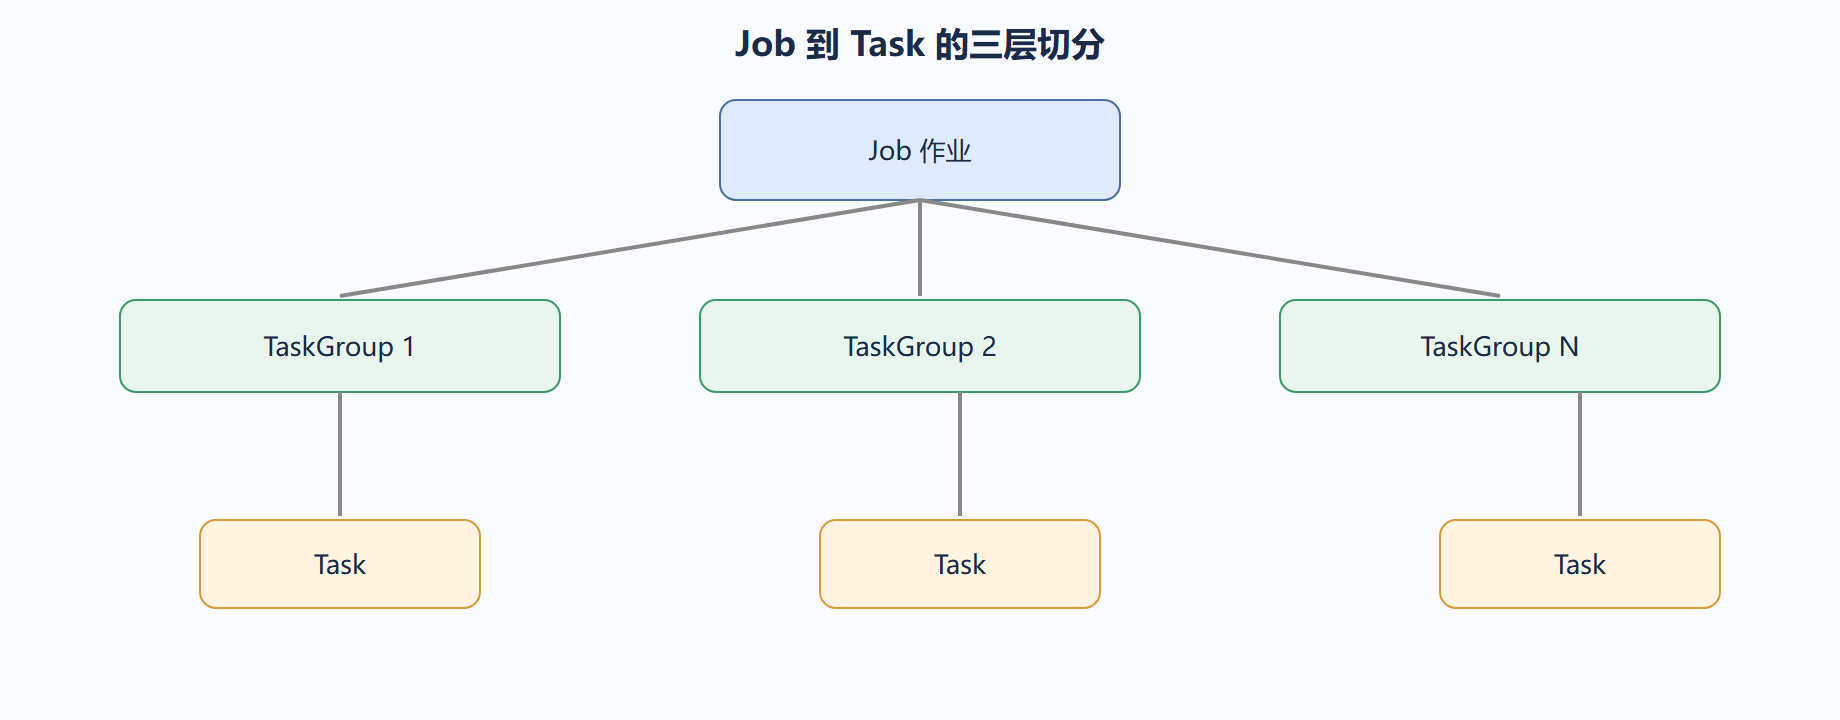
切分怎么影响吞吐
并发不是越多越好。Task 多了,线程上下文切换和 Channel 内存占用都上来了。我们一般先按「目标端写入能力」和「源端读压力」取一个保守值,再实测微调。后面第五章会专门讲这个平衡。
一个常见误解
有人以为 channel 等于数据库连接数。其实 channel 是 DataX 内部并发单位,关系型 Reader 在 channel 之上还会用连接池。把两者画等号,容易把源库连接打满。理解三层模型,才能正确预估源端压力。
切分与资源的关系
Job 切成 Task 后,每个 Task 占用一个 channel 的并发槽和一块内存缓冲。所以 channel 数直接决定同时跑多少 Task,也决定峰值内存。我们常被告诫「调大 channel 能提速」,但忘了每个 channel 都要吃内存,结果堆被吃满,GC 停顿反倒拖慢整体。
| channel | 并发 Task | 内存占用 | 备注 |
|---|---|---|---|
| 2 | 2 | 低 | 慢但稳 |
| 8 | 8 | 中 | 常见甜点 |
| 32 | 32 | 高 | 易 OOM |
经验上,channel 先按「机器核数的一半」与「源端能承受的连接数」取较小值,再实测微调。这一节建立的切分认知,是第五章调优的底层依据。
任务跑起来后,用 jstack 看线程能印证 Job 到 Task 的切分。
# 2.1 整体架构设计:Job、TaskGroup、Task jps | grep DataX jstack $(pgrep -f datax.py) | grep -c Task
背景
上一节建立了「Job → TaskGroup → Task」的三层认知,这一节把它量化:给定一个 channel 数与一个切分键,框架到底起了多少线程、占了多少内存。
操作:带切分键的配置
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/order"], "table": ["t_order"], "splitPk": "id" } ], "column": ["id","user_id","amount"] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/order", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"user_id","type":"bigint"}, {"name":"amount","type":"double"} ] } } } ], "setting": { "speed": { "channel": 8 } } } }
启动命令
# 跑起来后用 jstack 印证线程数,直观看到 Task 并发 jps | grep DataX jstack $(pgrep -f datax.py) | grep -c "Task"
结果解读
若 t_order 的 id 跨度能被 8 整除成若干段,框架会切出约 8 个 Task 并发读、各自起 Reader 与 Writer 线程。日志里 任务总计耗时 与 读出记录总数 能反推单 Task 吞吐。你会发现:把 channel 从 2 提到 8,耗时大致降到 1/4;但再提到 32,耗时下降不再明显,因为源端读能力或网络带宽成了新瓶颈。
变式
去掉 splitPk,框架无法按主键切分,会退化为单 Task 串行读——配置没报错,但速度天差地别。这正是「懂切分才懂调优」的活例证。
三层职责对照
| 层级 | 职责 | 受谁影响 |
|---|---|---|
| Job | 描述同步意图 | 你写的 json |
| TaskGroup | 容器化并发槽 | 框架按 channel 推算 |
| Task | 真正读写线程对 | splitPk + channel |
💡 关键直觉:channel 不是「连接数」而是「并发水管数」;splitPk 决定水管能不能真正分开流。两者配合,吞吐才上得去。
⚠️ 常见坑:以为 channel 越大越快,无脑设 50。每个 channel 都占内存缓冲,50 个并发可能直接把堆吃满触发 GC 停顿,整体反而更慢甚至 OOM。
切分粒度的一个经验公式
在生产里,TaskGroup 的数量由框架按 channel 推算,但你可以反推:若单 Task 平均吞吐约 1 万行/秒,目标需在 10 分钟内同步 6000 万行(约 10 万行/秒),则大约需要 10 个并发 Task,对应 channel 取 10 左右。这只是估算起点,最终以实测的「Speed (B/s)」是否打满源端带宽为准。
| 目标吞吐 | 估算 channel | 单 Task 假设 |
|---|---|---|
| 1 万行/s | 1 | 1 万行/s |
| 10 万行/s | 10 | 1 万行/s |
| 50 万行/s | 50 | 1 万行/s |
💡 关键直觉:channel 不是拍脑袋的数字,而是「目标吞吐 ÷ 单 Task 实测吞吐」的商,再被源端承载上限裁剪。先测单 Task 能力,再算总数,比盲目堆 channel 靠谱得多。
一个常被人忽略的点:切分与事务
关系型 Reader 在按 splitPk 切分后,每个 Task 各自开启一个读事务(或只读快照)。这意味着并发越高,源端同时在跑的查询越多,不仅会占用连接,还会延长源端 MVCC 版本的保留压力。所以「切得越细」并不总是友好,要结合源端连接池上限与快照回收能力来定 channel,而不是只盯着同步侧的速度。
💡 关键直觉:切分是双向的——它加速了同步,也同步放大了源端的查询负担。channel 的上限不应只看本机资源,更要看源端能不能同时伺候这么多并发查询。