2.2 数据传输模型:Reader、Writer、Channel(缓冲区)
2.2 数据传输模型:Reader、Writer、Channel(缓冲区)
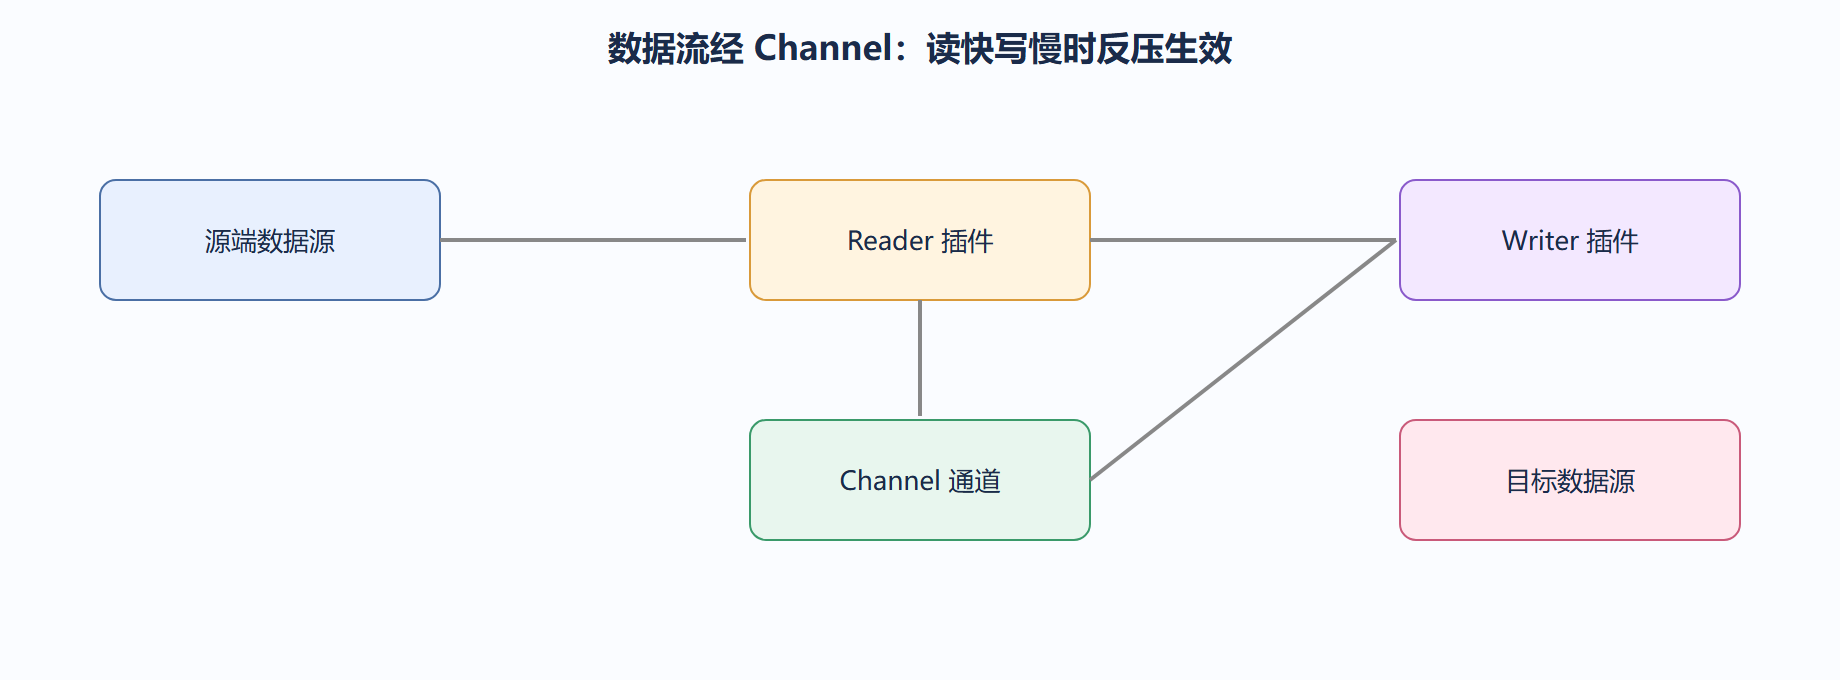
一条记录从源端到目标端,要经过 Reader、Channel、Writer 三段。Channel 不是简单队列,它承载了缓冲和反压,是保护内存的关键。
Reader:把异构数据转成统一 Record
Reader 插件从源端拉数据,并转换成 DataX 内部统一的 Record 结构。无论源是关系型表、HDFS 文件还是 ES 索引,出来的 Record 都是同一套类型系统。这一步屏蔽了数据源差异,让 Writer 无需关心自己对接的是谁。
{ "reader": { "name": "mysqlreader", "parameter": { "connection": [{ "jdbcUrl": ["jdbc:mysql://h:3306/d"], "table": ["t"] }], "column": ["id", "name", "ts"], "splitPk": "id" } } }
Channel:缓冲与反压
Reader 把 Record 推入 Channel,Writer 从 Channel 拉取。Channel 是个有界内存队列:当 Writer 写慢了,Channel 填满,Reader 的推送被阻塞,这就是反压。它防止了「读得快、写得慢」时内存无限堆积导致 OOM。可以把 Channel 想象成建筑工地的物料缓冲带:前方供料太快,缓冲带堆满,供料就被迫停下,而不是把料堆到天上。
Writer:把 Record 落进目标
Writer 从 Channel 拉 Record,按目标协议写出。它和 Reader 互不知晓对方存在,只认 Channel 里的 Record。这种解耦正是插件能独立扩展的原因:新增一种目标,只需写 Writer,不影响任何 Reader。
工程含义
Channel 的大小由 speed.byte 与 speed.record 间接影响,内存上限要在 JVM 堆里留足。我们踩过的坑是:把 channel 开得很大、又把 byte 限速调很高,结果堆外内存和 Channel 缓冲一起涨,任务中途 OOM。后面 JVM 调优会回到这里。
反压是保护不是 bug
新手看到任务「卡住不动」,常以为是 DataX 卡死了,实际上是 Channel 反压在起作用:Writer 写慢了,Channel 填满,Reader 被阻塞,整体速率被压到 Writer 能跟上的水平。这是一种保护,避免内存无限堆积导致 OOM。
| 现象 | 含义 | 应对 |
|---|---|---|
| 读速率远大于写 | 反压生效 | 优化 Writer |
| Channel 缓冲常满 | 下游瓶颈 | 提 Writer 批量 |
| 两端都慢 | 资源受限 | 加机器或降量 |
理解反压后,你会把「任务变慢」当成信号而非故障:它告诉你瓶颈在下游,该去优化 Writer 或目标端,而不是盲目加 channel。
延伸与提醒
把复杂 join 留在计算引擎,DataX 只做贴源搬运。
把 DataX 当搬运工而非加工车间,链路才简单可排查。
脏数据阈值设得太高,会掩盖源端的数据质量问题,反而埋雷。
测试样本先小后大,几分钟校验能省下几小时排错。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
源库索引评审应作为同步查询上线的前置环节。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
Channel 反压时,日志里会出现推送阻塞的提示,关注下面这类信息。
grep -i "channel" job.log | grep -i "block\|full" | head # 输出示例:channel is full, reader blocked
背景
Reader 与 Writer 之间不是直接传数据,而是经过 Channel 这个带缓冲的队列。理解缓冲,才能理解为什么「限速」既保护源端也不丢数据。
操作:用 byte 限速而非只限 channel
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/log"], "table": ["t_access"] } ], "column": ["id","url","ts"] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/access", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"url","type":"string"}, {"name":"ts","type":"string"} ] } } } ], "setting": { "speed": { "channel": 6, "byte": 1048576 } } } }
启动命令
# byte 单位为字节/秒/通道,这里约 1MB/s/通道、合计约 6MB/s python bin/datax.py job/mysql_to_hdfs_byte.json
结果解读
speed.byte 控制每个 channel 的流量上限,比单纯调 channel 更平滑:即使并发高,单通道速率也被压住,源端不会被瞬时洪峰冲垮。Channel 内部的缓冲队列(默认受 core.json 里的 channel 配置影响)在 Reader 快于 Writer 时暂存数据,慢于 Writer 时喂数据,起到削峰填谷作用。
变式
当 Writer 是慢目标(如远程数据库),适当调大 byte 上限并配合较多 channel,可让 Reader 不被 Writer 拖累;反之源端脆弱时,调小 byte 优先保源端稳定。
传输模型要素对照
| 要素 | 作用 | 配置位置 |
|---|---|---|
| Reader | 抽数 | content.reader |
| Writer | 写数 | content.writer |
| Channel | 并发 + 缓冲 | speed.channel |
| byte 限速 | 流量上限 | speed.byte |
💡 关键直觉:把 Channel 想成「有容量上限的水管」,byte 是「水阀开度」。调 channel 是加水管,调 byte 是拧水阀,两者一起决定总流量与对源端的压力。
⚠️ 常见坑:只设 channel 不设 byte,高并发下每个通道全速抽取,源库连接与 IO 瞬间打满;生产环境建议 byte 与 channel 配合设置,给源端留余量。