2.4 任务生命周期管理(初始化、运行、结束)
2.4 任务生命周期管理(初始化、运行、结束)
一个 DataX 任务从敲下命令到退出,经历明确的几个阶段。清楚每个阶段在干什么,出问题才知道去哪一段找原因。
初始化:解析与切分
引擎读入 job.json,校验配置,根据 reader 的分片能力(比如关系型库的 splitPk)把任务切成多个 Task,再按 channel 数组织成 TaskGroup。这一阶段出错,通常是配置写错:字段拼错、连接串不通、列名对不上。
# 启动任务,日志会先打印配置解析与切分信息 python bin/datax.py job/mysql2hive.json # 观察开头几行:JobContainer 初始化、切分出的 Task 数
运行:调度与搬运
各 TaskGroup 领取 Task,启动 Reader/Writer 线程,数据经 Channel 流动。运行阶段是耗时主体,也是性能瓶颈所在。引擎会周期性打印进度:读了多少行、写了多少行、速率多少。这些数字是第五章定位瓶颈的第一手材料。
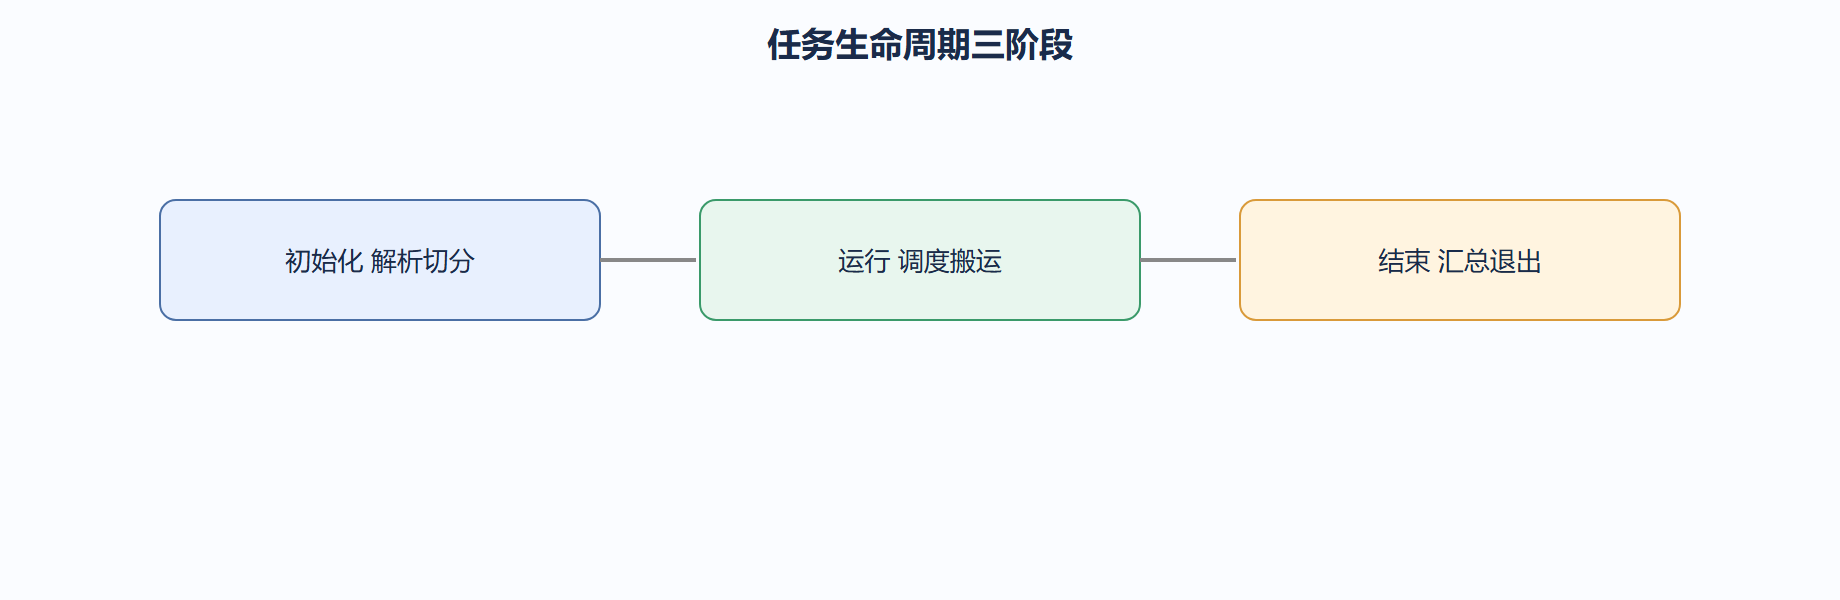
结束:汇总与退出码
所有 Task 完成后,引擎汇总统计:总行数、总字节数、脏数据数、是否触达错误上限。退出码 0 表示成功,非 0 表示失败或超限。我们常把退出码接进调度系统,非 0 就告警,这样无需人工盯日志也能发现失败。
关键判断点
如果任务「卡住不动」,多半在运行阶段的 Channel 反压或源端慢查询;如果「秒退」,多半在初始化阶段的配置或连接。先看日志开头还是中间,能立刻缩小排查范围。这也是我们把生命周期讲清楚的目的:让现象对号入座。
退出码要接进调度
DataX 任务结束会给出退出码:0 成功,非 0 失败或触达错误上限。我们把它接进调度系统,非 0 立即告警,无需人工盯日志。配合日志里周期打印的读写行数,能在任务中途就发现「读为 0」「写不动」这类异常。
| 退出码 | 含义 | 调度动作 |
|---|---|---|
| 0 | 成功 | 标记完成 |
| 非 0 | 失败/超限 | 告警并重试 |
我们建议任何生产任务都不要手动跑完就了事,而是让调度系统认退出码。这样半夜失败也能被及时发现,而不是等到第二天报表空了才有人问。
延伸与提醒
退出码接进调度系统,才能让失败在半夜被及时发现。
限速不是限制能力,而是给其他任务留出生存空间。
eswriter 的批量 bulk 写入,比逐条插入快一个数量级。
多租户隔离交给编排层,DataX 保持简单最稳妥。
任务可重跑幂等,是生产上线前的硬指标。
Reader 和 Writer 互不知晓,正是插件能独立扩展的原因。
Redis 同步重跑要防重复 key,靠固定模板才能幂等。
监控指标和 DataX 日志交叉看,能锁定九成瓶颈。
脏数据阈值设得太高,会掩盖源端的数据质量问题,反而埋雷。
配置进版本库、密码进环境变量,是跨环境复用的基础。
Channel 是有界缓冲,填满即触发反压保护内存。
orc 加 snappy 是 Hive 落地的常见稳妥组合,省空间且查询快。
把转换逻辑下推到源库,通常比在 DataX 内部处理更高效。
插件目录名必须和 job.json 的 name 完全一致,大小写都不能错。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
splitPk 的列若分布不均,分片会倾斜,部分 Task 拖慢整体。
把 DataX 当搬运工而非加工车间,链路才简单可排查。
测试样本先小后大,几分钟校验能省下几小时排错。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
一张参数与吞吐的经验曲线,比任何通用公式都贴近你的环境。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
反压机制保护内存,看到任务变慢应去优化下游而非加并发。
把复杂 join 留在计算引擎,DataX 只做贴源搬运。
星型拓扑把 N 乘 M 的对接降到 N 加 M,变更成本随之下降。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
生产环境的稳定性,常常取决于部署习惯而非某个高级特性。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
自定义插件最容易踩的坑是依赖冲突,provided 范围能治本。
源库索引评审应作为同步查询上线的前置环节。
preSql 里带 truncate 的任务,上线前必须二次确认目标表名。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
关系型 Writer 的批量提交大小,要在往返开销和回滚成本间权衡。
在调度脚本里认退出码,是生命周期收尾的关键。
python bin/datax.py job/x.json rc=$? if [ $rc -ne 0 ]; then echo "任务失败,退出码 $rc"; fi
背景
理解任务生命周期,才能知道「卡在哪一步」「为什么失败」「重跑安全吗」。我们用一份带错误容忍的配置走完整个周期。
操作:带 errorLimit 的配置
{ "job": { "content": [ { "reader": { "name": "mysqlreader", "parameter": { "connection": [ { "jdbcUrl": ["jdbc:mysql://db:3306/order"], "table": ["t_order"] } ], "column": ["id","amount"] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/order", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"amount","type":"double"} ] } } } ], "setting": { "errorLimit": { "record": 100, "percentage": 0.02 }, "speed": { "channel": 5 } } } }
启动命令
# 任务结束后看退出码:0 成功,非 0 失败;重跑前先确认目标可覆盖 python bin/datax.py job/order_to_hdfs.json; echo "exit=$?"
结果解读
生命周期为:解析配置 → 切分 Task → 初始化 Reader/Writer → 各 channel 并发读写 → 汇总统计 → 输出五要素日志 → 退出。其中 errorLimit 决定「脏数据容忍度」:单条转换失败记为脏数据,超过 record 或 percentage 阈值则整任务失败。这保证了「少量坏数据不阻断大盘,大量坏数据必须报警」。
变式
把 errorLimit.record 设为 0,则任何一条脏数据都立即失败——适合对数据质量零容忍的金融对账场景;设大则适合允许少量丢弃的日志同步。
生命周期阶段对照
| 阶段 | 关注点 | 失败典型原因 |
|---|---|---|
| 初始化 | 配置合法 | json 语法错 |
| 切分 | 并发合理 | splitPk 缺失 |
| 运行 | 读写稳定 | 网络/权限 |
| 结束 | 统计正确 | 脏数据超限 |
💡 关键直觉:任务生命周期里每一步都可能失败,但 DataX 把它们「显式化」了——你能在日志里看到卡在哪一步,而不是只得到一个模糊的退出码。
⚠️ 常见坑:把 errorLimit 设得过大(如 record 十万),结果脏数据悄悄丢弃、下游数据 silently 缺漏,等到对账才发现差了几万行。容忍度要与业务对账机制配套。