2.3 插件体系与扩展机制(Plugin Loader)
2.3 插件体系与扩展机制(Plugin Loader)
DataX 的「可插拔」不是口号,而是一套约定:每个插件是一个 jar,放在固定目录,框架在启动时通过 Plugin Loader 加载并实例化。理解这套约定,自定义插件才可行。
插件目录约定
解压后的 DataX 包里,plugin 目录下分 reader 和 writer 两类,每类下每个插件一个文件夹,内含 jar 与 plugin_job_template.json。框架扫描这个目录,读配置,把插件名映射到具体实现类。这也是为什么你在 job.json 里写 "name": "mysqlreader",框架能找到对应的包。
# 2.3 插件体系与扩展机制(Plugin Loader) ls plugin/reader/ ls plugin/writer/ # 输出示例:mysqlreader/ hdfsreader/ ... streamreader/
Loader 的加载时机
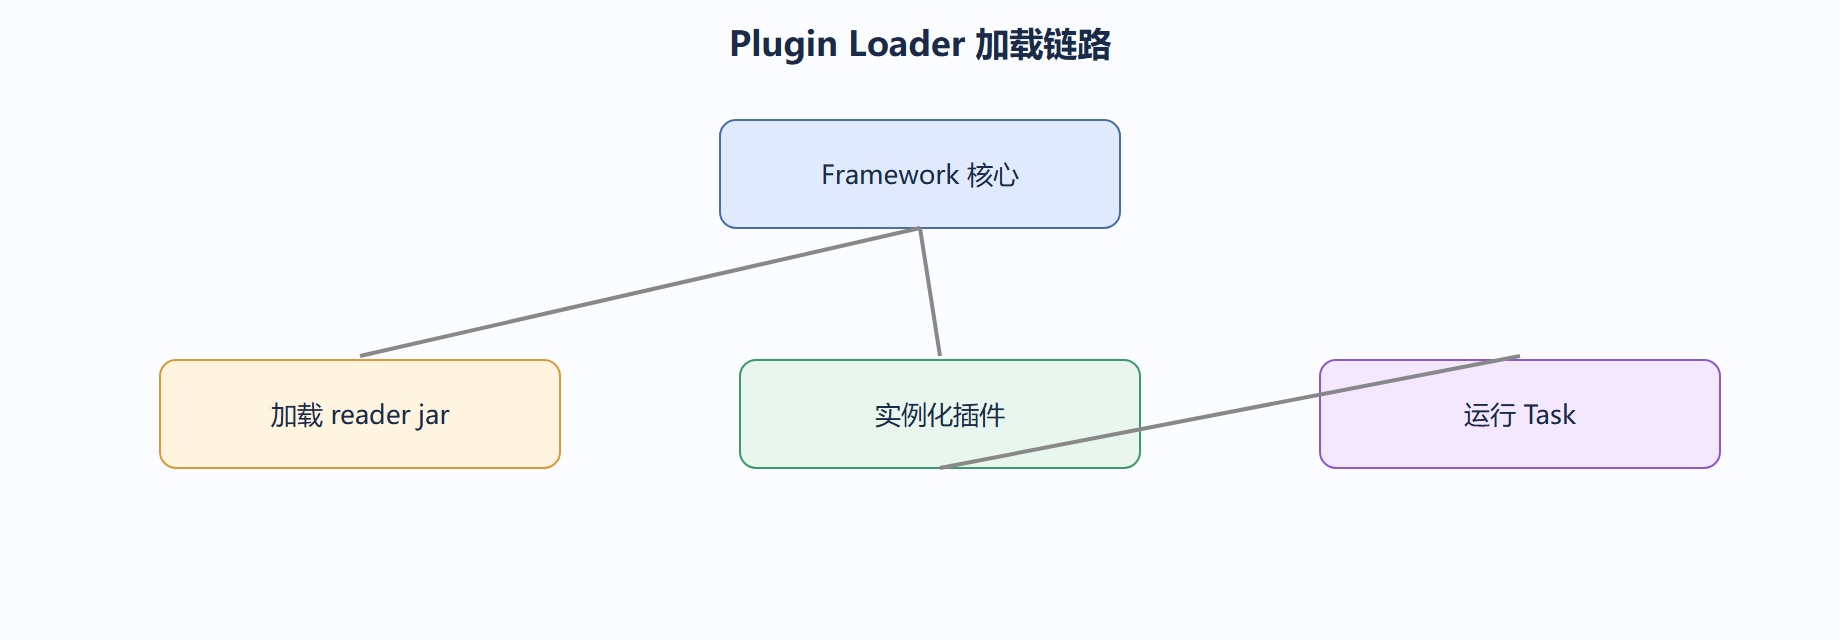
任务启动时,框架先解析 job.json,收集用到的 reader 和 writer 名字,再去 plugin 目录加载对应 jar 到独立类加载器。这样不同插件即使依赖了冲突版本的库,也能靠隔离的类加载器共存。这是插件体系的底层保障,也是为什么自定义插件要遵循它的打包结构。
接口契约
Reader 要实现 startRead、Writer 要实现 startWrite,它们通过框架传来的配置和 Channel 通信。插件只关心「怎么读这一片数据」「怎么写这一批数据」,调度、并发、容错全交给框架。这种职责切分,让写一个插件不需要懂整个引擎。
我们的实践提醒
自定义插件最容易犯的错误是依赖了和核心冲突的库版本。靠 Plugin Loader 的隔离能缓解,但最好还是在插件的 pom 里把冲突依赖设成 provided,避免把多余版本打进 jar。第七章会给出完整开发步骤。
类加载隔离的价值
Plugin Loader 用独立类加载器加载每个插件 jar,这让不同插件即使带了冲突版本的第三方库也能共存。比如插件 A 依赖库 X 的 1.0 版,插件 B 依赖 X 的 2.0 版,隔离后互不干扰。这是插件体系能横向扩展的底层保障。
| 做法 | 后果 |
|---|---|
| 依赖打进插件 jar | 可能与核心冲突 |
| 依赖标 provided | 干净,靠核心提供 |
| 共享类加载器 | 版本打架风险高 |
我们在写自定义插件时,把 datax-core 和公共库都标成 provided,只打自己的业务代码。这样插件包小、冲突少,加载也快。
延伸与提醒
全量基线加增量补充,是批流配合的常见稳妥组合。
插件目录名必须和 job.json 的 name 完全一致,大小写都不能错。
对象存储比 FTP 更适合做跨机房中转,因为它支持断点和内网加速。
权限收得越紧,凭据泄露的爆炸半径越小。
channel 数超过源端连接承受能力时,瓶颈会从 DataX 转移到数据库。
JVM 堆要给 Channel 缓冲留足空间,否则 GC 频繁拖慢吞吐。
配置进版本库、密码进环境变量,是跨环境复用的基础。
Hive 表的分区设计直接影响下游查询性能,写入时就该想清楚。
测试样本先小后大,几分钟校验能省下几小时排错。
源库索引评审应作为同步查询上线的前置环节。
任务可重跑幂等,是生产上线前的硬指标。
自定义插件最容易踩的坑是依赖冲突,provided 范围能治本。
日志里周期打印的读写速率,是定位瓶颈的第一手材料。
rowkey 的散列前缀设计,能避免 HBase 写入热点。
数据湖贴源层保留原始形态,方便后续 schema 演化。
DataX 的设计哲学是把连接差异收敛到插件,让核心只管调度与缓冲。
querySql 与 column 二选一,混用会直接报错。
机器核数、内存、带宽三者共同决定 channel 的甜点值。
限速不是限制能力,而是给其他任务留出生存空间。
任务的读写速率差,比绝对速率更能说明瓶颈在哪一段。
多租户隔离交给编排层,DataX 保持简单最稳妥。
插件描述文件 plugin.xml 声明了插件名与实现类。
<plugin> <name>myreader</name> <class>com.x.MyReader</class> <type>reader</type> </plugin>
背景
DataX 的插件体系让它「框架稳定、生态生长」。我们看看插件放在哪、框架怎么加载,再写一个引用自定义 reader 的最小配置。
操作:引用一个自定义 reader 插件
{ "job": { "content": [ { "reader": { "name": "mycassandrareader", "parameter": { "host": "10.0.0.5", "keyspace": "app", "table": "events", "column": ["id","payload"] } }, "writer": { "name": "hdfswriter", "parameter": { "defaultFS": "hdfs://ns", "path": "/data/events", "fileType": "text", "column": [ {"name":"id","type":"bigint"}, {"name":"payload","type":"string"} ] } } } ], "setting": { "speed": { "channel": 3 } } } }
启动命令
# 查看插件目录结构,确认 reader/writer 的 jar 与 plugin_job_template.json 就位 ls -R plugin/reader/mycassandrareader/ # 列表中出现插件即代表 Plugin Loader 能发现它 python bin/datax.py job/cassandra_to_hdfs.json
结果解读
DataX 启动时由 Plugin Loader 扫描 plugin 目录下各子目录,按 plugin_job_template.json 描述的依赖把 jar 加载进独立类加载器。你的 mycassandrareader 只要实现 Reader 抽象、打包进对应目录,框架无需改动就能识别。这种「约定优于配置」的扩展机制,是它生态庞大的根本原因。
变式
把 mycassandrareader 换成官方已带的 cassandrareader(若存在),或替换为任意自研 reader,配置写法完全一致——框架只认 name,不关心内部实现。
插件机制对照
| 部分 | 职责 | 你动的文件 |
|---|---|---|
| Loader | 扫描并加载 jar | 不用动 |
| Template | 声明依赖 | plugin 内置 |
| 实现类 | 读写逻辑 | 你写的 Java |
| 配置 | name 引用 | 你的 job.json |
💡 关键直觉:插件体系把「支持新数据源」的成本,从改框架源码降到「写一个实现 + 丢进目录」,这是 DataX 生态滚雪球式增长的关键。
⚠️ 常见坑:插件 jar 依赖与 DataX 核心依赖版本冲突,导致 NoClassDefFoundError 或 NoSuchMethodError。自研插件务必用 DataX 提供的 datax-common 依赖并 provided 作用域,避免打包冲突。