1.3 发展历程与重要里程碑
把时间轴拉直
本节把时间轴拉直:研究智能体不是某天突然冒出来的,它从"人用工具"走到"工具替人规划",中间有三个值得记住的拐点。在全册里,这一节负责给你一个历史坐标系——后面讲架构和算法时,你能知道某项能力是何时、为何被逼出来的。
最早是被动增强阶段。学者用搜索引擎、用引用网络追前沿,工具再好也只执行人的指令。AI 介入的头一波是提示工程:用精巧指令让大模型"假装"在做研究。但那是模式复述,模型并不真理解研究逻辑,遇到开放问题就容易胡编一串看起来合理的步骤。
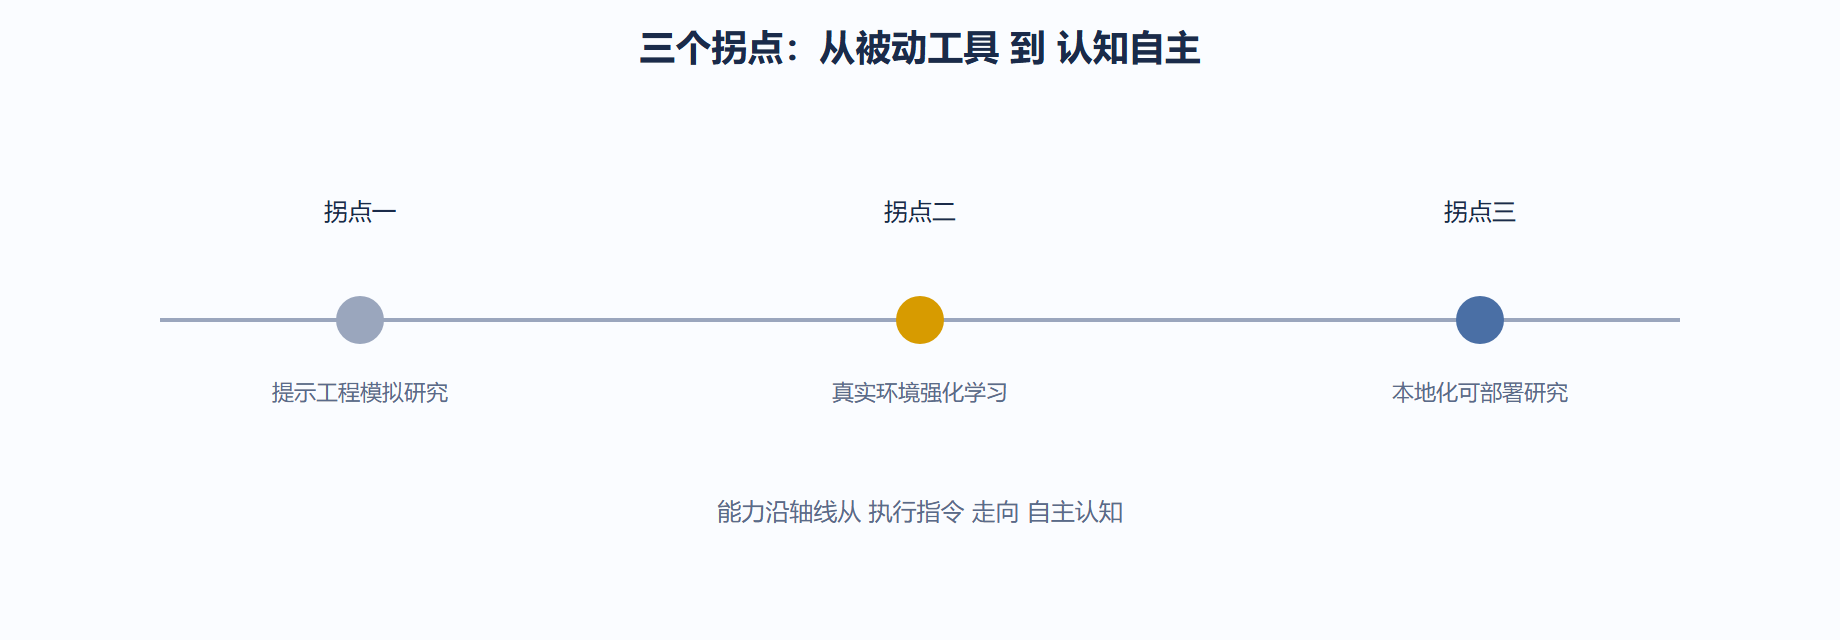
拐点二最关键:把训练场从静态库搬到真实互联网。前文(1.2)讲过泳池与海洋的差别,这里补一个工程事实——在真实环境端到端训练后,系统自发涌现"规划、反思、交叉验证"。注意"涌现"不是玄学:是奖励在无数次试错里把这几类行为强化成了默认策略。一个可观测的标志是,面对敏感问题它会主动找多个信源做三角验证,而非采信首条。
拐点三来自本地化。受迭代式"生成—搜索—反思"循环启发,有人发现不必非要云端巨模型,关键在研究范式本身。用本地托管的小模型配好循环,也能在长任务上打过云端大模型。这把研究智能体从"大厂玩具"变成"隐私敏感场景也能用"的实器械。
下面用一段代码模拟"里程碑识别":给定若干历史事件,标注它属于哪个拐点,这是你在读论文时真正会做的归类练习。
# 把一项工作归入发展里程碑,便于建立历史坐标系 MILESTONES = { "prompt_only": "拐点一 提示工程", "real_env_rl": "拐点二 真实环境强化学习", "local_loop": "拐点三 本地化循环", } def classify(work: dict) -> str: if work.get("trained_on_live_web"): return MILESTONES["real_env_rl"] if work.get("runs_local") and work.get("iterative_loop"): return MILESTONES["local_loop"] return MILESTONES["prompt_only"] # 会话说明:三条真实形态的工作描述 works = [ {"trained_on_live_web": False, "runs_local": False, "iterative_loop": False}, {"trained_on_live_web": True, "runs_local": False, "iterative_loop": True}, {"trained_on_live_web": False, "runs_local": True, "iterative_loop": True}, ] for w in works: print(classify(w)) # 输出:拐点一 提示工程 / 拐点二 真实环境强化学习 / 拐点三 本地化循环
运行输出依次是三个拐点标签。你读一篇新论文,先问这两件事:它在真实网上训过吗?它能本地跑吗?答案决定它在历史轴线的哪一段,也决定它的能力边界。
完整案例:背景→操作→结果→解读→变式
- 背景:某高校课题组要复现"会研究"的系统,但只有内网机器、不能接外网训练。
- 操作:他们放弃云端训练路线,采用本地小模型加迭代循环(拐点三思路),用校内文献库做检索后端。
- 结果:在"校内政策综述"任务上达到可用水平,但面对需要实时网页的任务偏弱。
- 解读:本地化牺牲了真实环境的广度,换来了数据不出域。这是拐点三的典型权衡,不是落后,是适配。
- 变式:若后续获准小流量接外网,可先用本地循环跑框架、再拿真实检索结果做校准,把两个拐点优点拼起来。
我们主张:看发展脉络别只记名词,要记"为什么走到那一步"。每一次拐点都是被上一个阶段的缺陷逼出来的——提示工程撑不起开放问题,静态训练扛不住真实噪声,云端依赖挡住隐私场景。带着这条因果链读第二章的架构,你会明白每个模块的来历。
怎么给一篇新工作定位历史坐标
读论文时,1.3 的分类函数(classify)只是第一步,更实用的是把若干工作串成"技术谱系":谁启发了谁、哪个拐点催生了下一个。用金融领域打个比方,早期提示工程像"只看单一指标做决策",本地化循环像"加了组合对冲",真实环境训练像"用实时行情回测"——每一跃迁都是对上一阶段盲区的补丁。
下面用一段最小谱系分析,给定若干工作的属性,自动找出"属于同代、可对照"的集群,帮你快速建立坐标系:
# 技术谱系聚类:按拐点属性把工作分代 def cluster_by_milestone(works: list) -> dict: clusters = {"拐点一": [], "拐点二": [], "拐点三": []} for w in works: if w.get("trained_on_live_web"): clusters["拐点二"].append(w["name"]) elif w.get("runs_local") and w.get("iterative_loop"): clusters["拐点三"].append(w["name"]) else: clusters["拐点一"].append(w["name"]) return clusters # 运行示例 papers = [ {"name": "A助手", "trained_on_live_web": True}, {"name": "B循环", "runs_local": True, "iterative_loop": True}, {"name": "C提示", "trained_on_live_web": False}, ] print(cluster_by_milestone(papers)) # {'拐点一': ['C提示'], '拐点二': ['A助手'], '拐点三': ['B循环']}
运行输出把三篇归到三个拐点。读文献时先跑一遍聚类,你就知道哪些工作其实是"同代不同皮",避免把换皮当创新。第四章的评估指标也能按代对比——同代工作才有可比性。
| 拐点 | 核心能力解锁 | 典型短板 | 何时该用它 |
|---|---|---|---|
| 一 提示工程 | 零训练即可上手 | 开放问题易编造 | 快速原型/演示 |
| 二 真实环境RL | 自主规划与验证 | 训练贵且不稳 | 需鲁棒的生产研究 |
| 三 本地化循环 | 数据不出域 | 广度受限 | 隐私敏感场景 |
💡 关键直觉:判断一项工作"先进"与否,不看发布时间,看它落在哪个拐点的能力谱上。一个晚发布但仍是纯提示工程的系统,能力上限低于早发布却真实训练的——时间不是进步,拐点才是。
⚠️ 常见坑:把"本地化"误读成"退化版真实训练"。本地循环补的是隐私短板,不是能力短板;它和真实环境训练是互补而非替代。若任务需要实时网页证据,纯本地循环会天然偏弱,应当用 1.3 案例里的"本地框架加小流量校准"拼法。