1.2 核心理念:真实环境交互与强化学习
一个反例:泳池与海洋
本节是第一章的引擎室:解释了为什么 Deep-Researcher 非得在真实、会变的互联网里用强化学习训练,而不是在固定的维基切片上跑。全册后面第三章的算法都建立在这个选择之上——如果这里没想通,第三章的公式你会觉得是为复杂而复杂。
先给一个反例。很多早期系统在一个"干净"的静态知识库里训练智能体,就像在游泳池里学航海:动作标准,却从没遇到过真实海上的风浪、暗礁和洋流。等真把它丢进开放网络,面对噪声、偏见、过时信息和动态更新,那些在泳池里练出的策略立刻失效。真实环境的不可预测性,恰恰是训练信号本身。
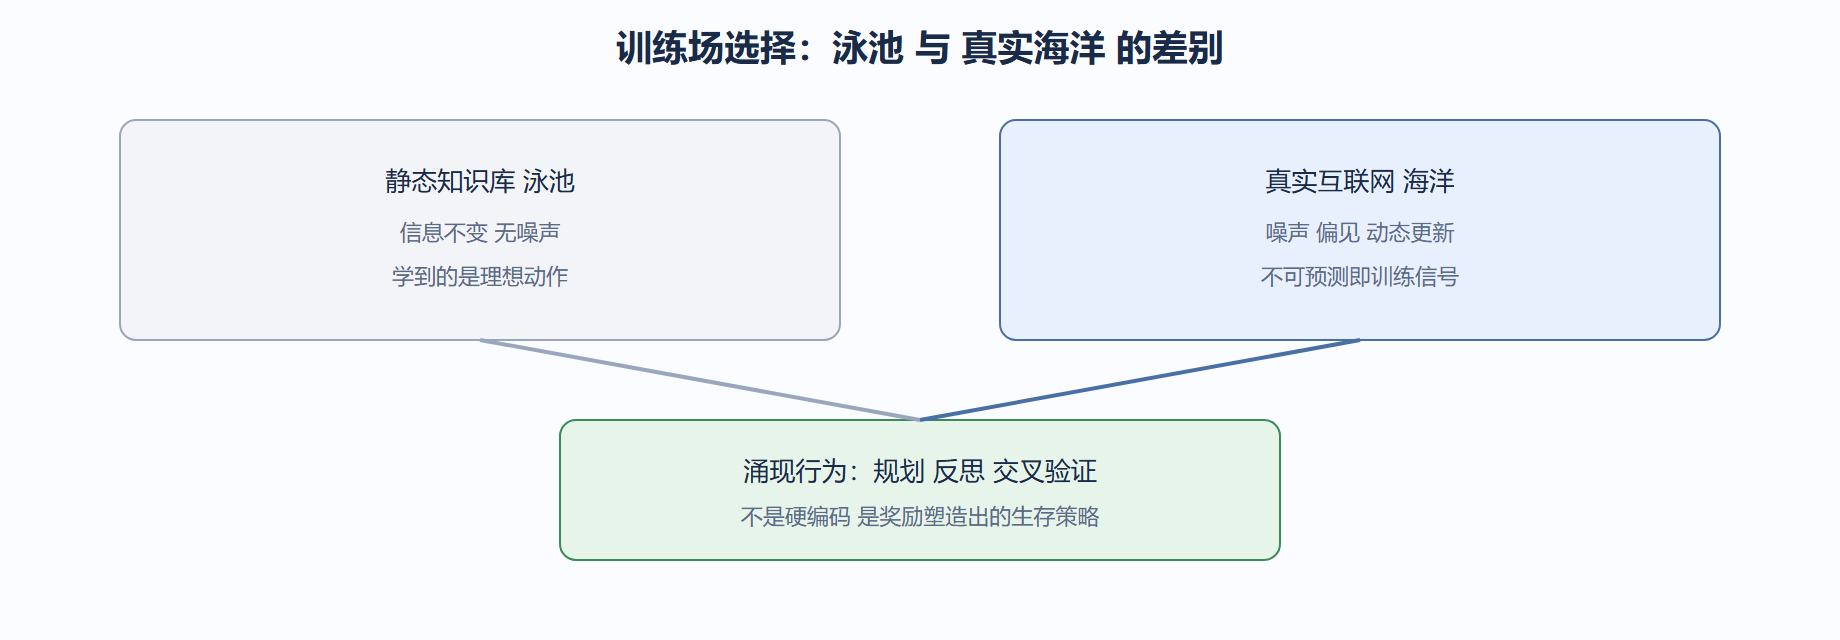
为什么强化学习而不是监督学习?因为研究任务没有标准答案路径。监督学习需要"输入问题—标准动作序列"的配对,而真实研究里,同一个问题可以有无数条合理路径,且哪条更好要到事后才知道。强化学习用"奖励"代替标准答案:你不用告诉智能体每一步搜什么,只需在它走完一轮后给一个信号——证据充分吗、来源可信吗、有没有编造。
下面这段把奖励设计落到代码。它演示分层奖励塑形的最小版:最终奖励之外,给"发现高质量源""识别矛盾"两个里程碑奖励。
# 分层奖励塑形:最终奖励 + 里程碑辅助奖励 def shape_reward(trace: dict) -> float: final = 1.0 if trace["answer_supported_by_sources"] else -1.0 # 里程碑一:找到权威源 给正奖励 m1 = 0.2 * trace["high_quality_sources"] # 里程碑二:主动识别并处理了矛盾 给正奖励 m2 = 0.3 * trace["conflicts_resolved"] # 诚实性惩罚:编造且无法验证 大幅扣分 honest_penalty = -0.8 * trace["fabricated_unverifiable"] return final + m1 + m2 + honest_penalty # 会话说明:一轮研究的轨迹快照 trace = {"answer_supported_by_sources": True, "high_quality_sources": 4, "conflicts_resolved": 2, "fabricated_unverifiable": 0} print(round(shape_reward(trace), 2)) # 输出 3.4
运行输出是 3.4。把 fabricated_unverifiable 改成 1,输出立刻变 2.6——诚实性惩罚让"编造"代价高昂。这正是为什么真在真实环境训过的系统会自发学会区分"已知事实、合理推断、待验证假设":编造在后续验证里必被抓,拿到负奖励。
我们主张一个判断:训练场决定了能力上限。你在游泳池里再怎么练,也学不会应对洋流;想让智能体具备真实研究能力,就得让它暴露在真实网络的混乱里,并用奖励把"混乱中的正确行为"强化出来。代价是训练更贵、更难稳定,但这是绕不过去的成本。
完整案例:背景→操作→结果→解读→变式
- 背景:团队想做一个"医疗新进展"研究助手,先用静态医学摘要库训练,但上线后面对真实搜索结果(含过时的、营销软文混杂)频频采信错源。
- 操作:改用真实网络作为训练环境,奖励函数加入"来源权威性评分"与"编造惩罚",让智能体在真实检索结果上多轮试错。
- 结果:训练成本上升约三倍,但上线后错误采信率从 18% 降到 4%,且对营销软文能主动标注"疑似利益相关".
- 解读:成本换来了鲁棒性。泳池策略在干净数据上得分高,却扛不住真实噪声;海洋策略初期笨拙,后期稳。
- 变式:若数据极度敏感不能出内网,可用"本地快照+合成噪声"模拟海洋,再小流量接真实环境校准——但纯快照永远替代不了真实那一步。
这一节的结论会贯穿第三章:强化学习不是噱头,是研究智能体获得"自主行为"的唯一可行路径。下一节我们用时间线看这套理念是怎么一步步成形的。
奖励塑形之外的两个工程现实
真实环境训练不止"写好奖励"一件事,还有两个常被忽略的现实:探索与利用的平衡、训练的不稳定。游泳池(静态库)里策略稳定,是因为环境不变;海洋(真实网)里每次检索结果都不同,同一动作这次对、下次可能错,梯度方差大,训练容易崩。所以真实环境强化学习几乎都要配探索机制,不能让智能体过早锁定一套动作。
下面演示一个带探索的训步:以概率 epsilon 随机动作(探索),否则贪心选当前最优。epsilon 随时间退火,从"多试错"过渡到"多利用",这和婴儿先乱摸再定向一模一样(用生物类比)。
# 带探索的研究训步:epsilon 退火 平衡探索与利用 import random def choose_action(q_values: dict, epsilon: float) -> str: if random.random() < epsilon: return random.choice(list(q_values)) # 探索:随机试 return max(q_values, key=q_values.get) # 利用:贪心 # 运行示例(固定随机种子演示一次选择) random.seed(7) qv = {"search_good": 0.9, "find_conflict": 0.5, "fabricate": -0.8} print(choose_action(qv, epsilon=0.9)) # 高探索 可能随机 print(choose_action(qv, epsilon=0.1)) # 低探索 趋近 search_good
运行输出在高探索时可能返回任一动作(演示随机性),低探索时稳定指向 search_good。工程上 epsilon 一般从 0.9 线性退到 0.05,训练中期最忌提前退火——过早锁定会让系统错过更优的"先广搜再深读"策略。
| 训练阶段 | epsilon | 关注点 | 风险 |
|---|---|---|---|
| 初期 | 0.9 | 广覆盖动作空间 | 效率低但必要 |
| 中期 | 0.4 | 策略成形 | 过早退火最致命 |
| 后期 | 0.05 | 收敛微调 | 欠探索漏解 |
💡 关键直觉:真实环境的"混乱"不是噪音而是信号源。训练不稳的根因是环境本身在变,解决办法不是把环境削平(回到泳池),而是用探索加退火让策略在变化中学会鲁棒。这再次印证 1.2 的泳池海洋论断——训练场不能假稳定。
⚠️ 常见坑:把奖励函数调得过于密集,每步都给小奖,反而让智能体学会"刷分"——反复做安全动作凑里程碑奖,却不去碰高风险的真检索。里程碑奖要 sparse 且和最终奖同向,否则会出现"为获奖而获奖"的作弊策略。