2.2 Deep-Researcher 内部模块组成
拆成四个零件
本节进入中间件内部:把 Deep-Researcher 拆成四个互相不越界的模块。全册讲到这里,你该拿到一份"零件清单",而且能说清每个零件不干什么——因为架构设计的核心不是堆功能,而是划清职责边界。边界模糊,模块就会互相耦合,后续换模型、加工具都寸步难行。
四个核心模块:其一,元认知协调层(负责"做什么"),把模糊问题转成子任务图;其二,MCP 管理器(负责"派给谁"),做任务分发与结果聚合;其三,深度分析器(负责"读懂"),从文本抽命题、找论证漏洞;其四,浏览器代理(负责"取到"),和真实网页交互。注意没有"写作模块"单独存在——成稿是综合层顺带完成的,不值得单列。
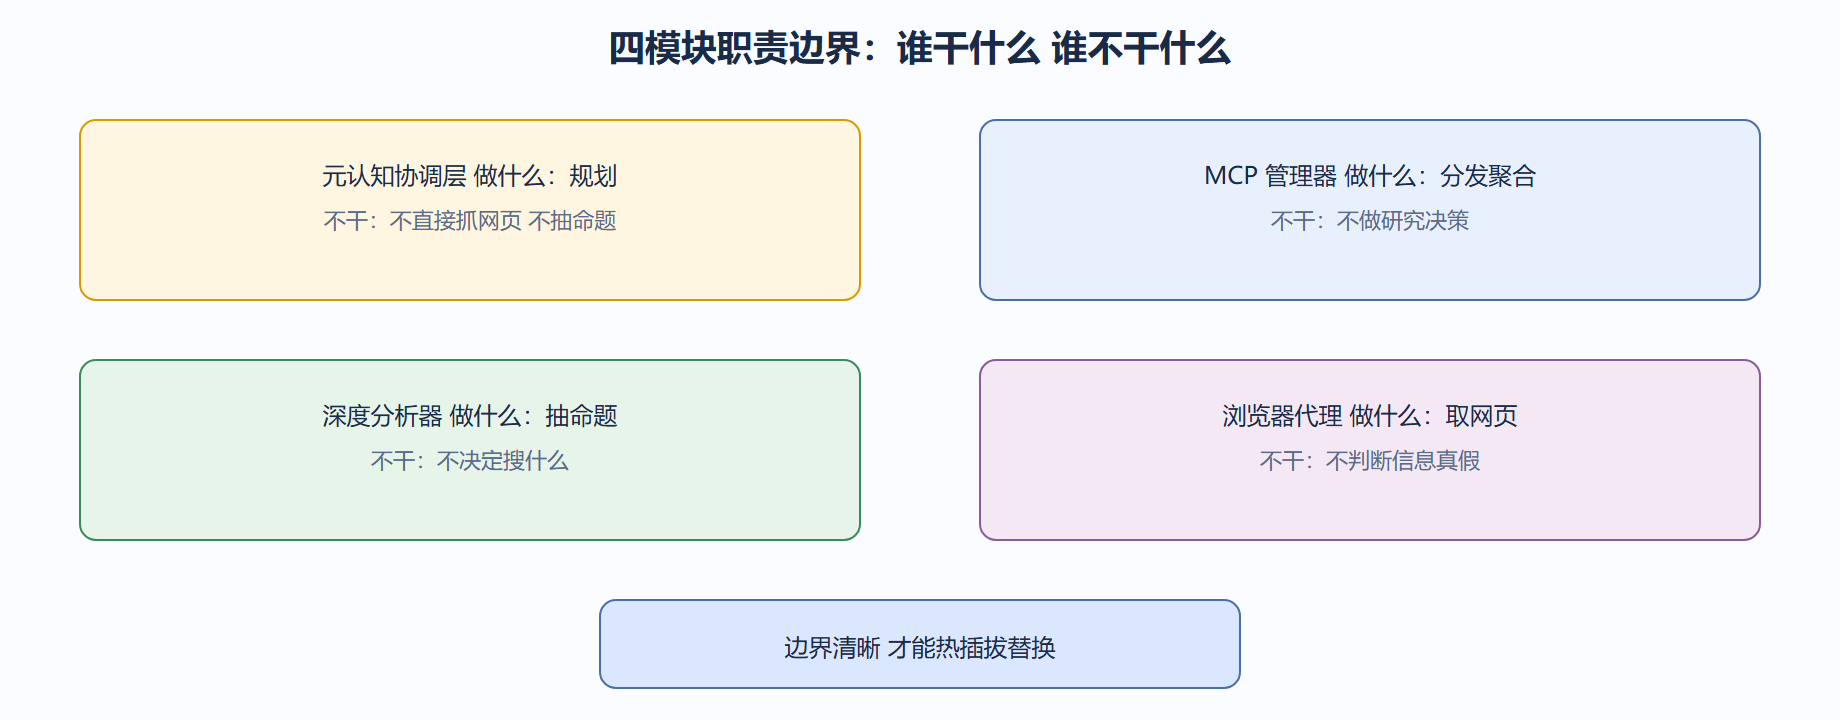
职责边界用什么来保证?工程上常用"能力注册表":每个模块上线时声明自己能处理哪类任务,MCP 管理器据此匹配,而不是写死调用。这样换一个更强的分析器,只要重新注册,协调层无感。下面是一段最小注册表:
# 模块能力注册表:声明职责,避免越界与硬编码调用 REGISTRY = {} def register(name: str, handles: list, do_not: list): REGISTRY[name] = {"handles": set(handles), "do_not": set(do_not)} register("planner", ["plan", "decompose"], ["fetch_web", "extract_prop"]) register("mcp", ["dispatch", "aggregate"], ["research_decision"]) register("analyzer", ["extract_prop", "find_gap"], ["decide_query"]) register("browser", ["fetch_web"], ["judge_truth"]) def can_handle(module: str, task: str) -> bool: info = REGISTRY.get(module) if not info: return False ok = task in info["handles"] violate = task in info["do_not"] return ok and not violate # 会话说明:校验调用是否越界 print(can_handle("analyzer", "extract_prop")) # True print(can_handle("analyzer", "fetch_web")) # False 越界被拦
运行输出 True 与 False。第二段说明分析器想抓网页会被注册表拦下——这就是边界的硬保障。没有这层,分析器某天"顺手"去抓网页,耦合就悄悄长出来,将来你换浏览器代理时会被它拖住。
我们主张:模块划分的判据是"能否独立替换"。能单独换掉而不动其他的,才配当独立模块;否则该合并。按这个判据,协调层和分析器必须分开(一个换模型、一个换抽取器互不影响),而"成稿"不必单列(它依附综合层)。
完整案例:背景→操作→结果→解读→变式
- 背景:初创团队把规划与抓取写进同一个大函数,上线后想换更快的抓取库,结果牵一发动全身,改出三处 bug。
- 操作:按上面注册表重构,把 planner 与 browser 拆成独立模块,各自声明 handles 与 do_not。
- 结果:更换抓取库时只改 browser 注册实现,协调层零改动,回归测试全绿。
- 解读:边界不是洁癖,是维护成本。模块数略多,但每个可被单独替换,长期更省。
- 变式:若团队极小、任务固定,可把"成稿"暂时并入综合层少写一个模块;但 planner 与 browser 的边界在任何规模都不该合并。
这一节给你零件清单,2.3 讲这些零件分别和哪些外部工具打交道,2.4 讲数据怎么在它们之间流动。
模块热插拔:替换一个而不动全局
2.2 强调"能否独立替换"是模块划分判据。真正落地时,热插拔能力靠运行时的"能力注册表查询"实现:协调层不直接 new 一个具体分析器,而是向注册表要"当前 registered 的 analyzer",换实现时只更新注册,调用方零改。这和金融系统换清算引擎一个道理——对外接口不变,内部实现可替换,交易不受影响。
下面演示运行时动态换模块:同一接口名,先后注册不同实现,协调层无感切换:
# 运行时热插拔:接口不变 实现可换 REGISTRY = {} def register(name, impl): REGISTRY[name] = impl def call(module, *a): return REGISTRY[module](*a) # 初版分析器:规则抽取 register("analyzer", lambda text: f"规则抽:{text[:6]}") print(call("analyzer", "量子计算药物进展")) # 规则抽:量子计算药物 # 换更强的模型版 不改调用处 register("analyzer", lambda text: f"模型抽:{len(text)}字命题") print(call("analyzer", "量子计算药物进展")) # 模型抽:8字命题
运行输出先打印规则版、再打印模型版,调用处 call("analyzer", ...) 一行没变。这就是"独立替换"的工程兑现:换模型不碰协调层,回归测试只针对新实现。
| 模块 | 常见替换场景 | 替换成本 | 是否该独立 |
|---|---|---|---|
| planner | 换更强模型 | 低 | 是 |
| analyzer | 规则→模型 | 低 | 是 |
| browser | 换抓取库 | 低 | 是 |
| 成稿 | 几乎不换 | 极低 | 否(并入综合) |
💡 关键直觉:边界的价值在"变化时"才显出来。平时模块边界像多余的开销,一旦要换模型、加工具,解耦的系统改一处、耦合的系统改一片。所以 2.2 说边界不是洁癖,是维护成本的对冲。
⚠️ 常见坑:注册表只声明 handles 却漏掉 do_not,导致模块"顺手"越界。比如 analyzer 偷偷接了抓网页,换浏览器代理时会和它打架、重复抓取。REGISTRY 里必须同时写 handles 与 do_not,并用 2.2 的 can_handle 在每次调用前校验,越界即拦。
模块边界速查
拿到一份新架构图,先用这张速查表核对边界是否清晰:协调层是否只做"决定做什么"、从不自己抓网页;分析器是否只抽命题、不决定查什么;浏览器代理是否只取、不判真假;综合层是否顺带成稿而非单列。四条满足,模块划得合格。任一条越界,按 2.2 注册表加 do_not 约束,下次调用即被拦。
| 模块 | 只做 | 绝不 |
|---|---|---|
| planner | 拆与排 | 抓网页 |
| analyzer | 抽与比 | 判真假 |
| browser | 取 | 信真假 |
| 综合层 | 成稿 | 独立决策 |