2.3 关键协作代理与工具
它对外依赖什么
本节在架构章的第三站:研究智能体不是孤胆英雄,它要和一串外部代理与工具协作才能干活。在全册里,这一节负责把"它对外依赖什么"列清楚——因为很多部署失败不是算法不行,而是工具接错了:检索后端不稳、网页交互被反爬、知识库权限没开。协作拓扑不清,排查时就像在黑屋抓猫。
先看一组关键协作者。搜索接口提供候选信源;网页代理负责真正打开页面、抽取正文;向量库存历史检索结果供去重与聚类;知识图谱或笔记库存中间结论;人类审核_gate 在不确定超阈值时介入。它们和内部四个模块(2.2)通过 MCP 管理器对接,管理器按"能力注册表"把任务派给对的工具。
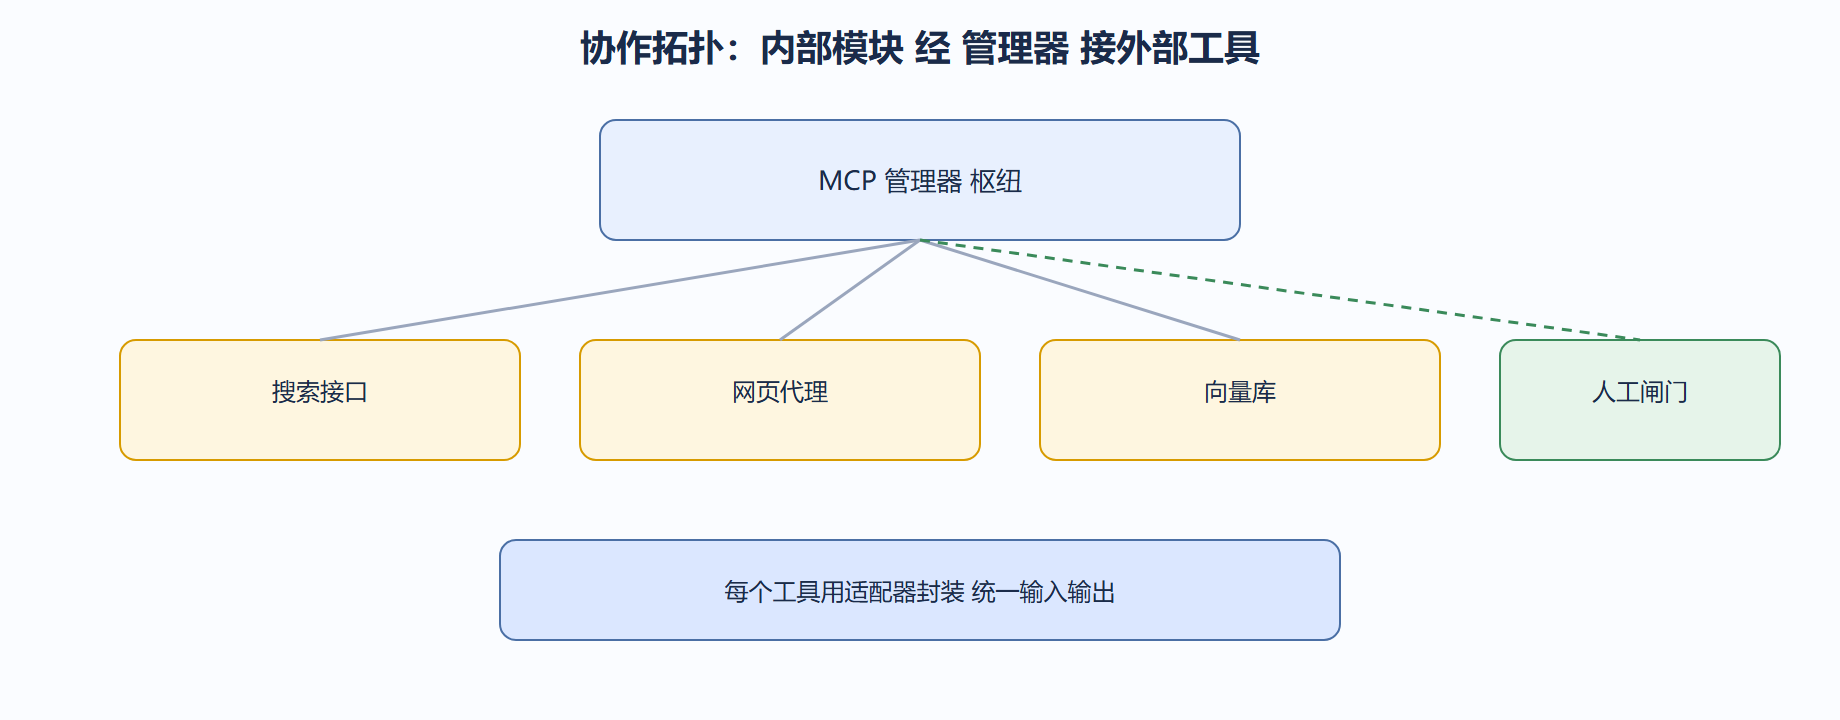
工程上,外部工具千差万别,必须用适配器(adapter)统一成内部能懂的"调用—返回"格式。否则搜索接口一升级,内部代码就要改一片。下面是一段适配器骨架:
# 工具适配器:把异构外部工具统一成 (query)->result 接口 class ToolAdapter: def __init__(self, name, call_fn): self.name = name self.call = call_fn def run(self, query: str) -> dict: raw = self.call(query) # 统一成内部格式:文本 + 来源 + 时间戳 return {"text": raw.get("text", ""), "src": raw.get("url", ""), "ts": raw.get("ts")} # 两个真实形态的工具,接口不同但被适配成一致 search_api = ToolAdapter("search", lambda q: {"text": "结果摘要", "url": "s1", "ts": 1}) web_agent = ToolAdapter("web", lambda q: {"text": "正文", "url": "w1", "ts": 2}) # 会话说明:管理器只认统一接口 for tool in (search_api, web_agent): out = tool.run("量子计算 药物") print(tool.name, "->", out["src"]) # 输出:search -> s1 / web -> w1
运行输出两行,分别打印两个工具的来源标识。关键点:管理器循环里不关心工具内部怎么实现,只调用 run。搜索接口换成另一个供应商,只要新适配器返回同样结构,内部零改动。
我们主张:协作层的设计目标是"可替换、可观测、可熔断"。可替换靠适配器;可观测要求每次调用留痕(详见 2.4);可熔断指某工具连续报错时管理器要能重规划而非卡死。这三点比"接得多"重要——接十个不稳定工具,不如接三个稳的。
完整案例:背景→操作→结果→解读→变式
- 背景:某系统接了五个搜索源,其中一个常返回空,导致研究报告大面积缺证据却无人察觉。
- 操作:给每个工具加适配器,并在管理器里记录"连续空返回次数",超阈值则熔断并触发重规划换源。
- 结果:坏源被自动隔离,报告改用其余四源,缺证据率从 22% 降到 5%。
- 解读:问题不在算法,在协作层缺熔断。可观测+可熔断把隐性故障变成可控事件。
- 变式:若业务要求"宁缺毋滥",熔断后可不换源而直接标"该方向证据不足",交人工闸门(见 2.4)。
这一节把对外依赖讲清,下一节 2.4 我们顺着数据看:一条证据从网页到报告,字段怎么变。
可观测与熔断:让隐性故障变成可控事件
2.3 主张协作层要"可替换、可观测、可熔断"。可观测具体怎么做?每次工具调用都留一条结构化痕迹:谁调的、调了什么、返回了什么、花了多久、成功与否。没有留痕,工具悄悄返回空、悄悄超时,你只能在最终报告质量暴跌时反推,那时已酿成错误结论。熔断则指某工具连续失败,管理器应隔离它并触发重规划,而不是一直重试到超时。
下面演示一个带留痕与熔断的管理器循环:
# 工具调用留痕 + 熔断:连续失败则隔离 logs, fail_streak = [], 0 def managed_run(tool, query, max_fail=3): global fail_streak out = tool.run(query) ok = bool(out.get("text")) logs.append({"tool": tool.name, "ok": ok}) # 留痕 if not ok: fail_streak += 1 if fail_streak >= max_fail: return {"text": "", "src": "", "blocked": True} # 熔断 else: fail_streak = 0 return out # 运行示例:一个连续失败的工具 bad = type("T", (), {"name": "x", "run": lambda q: {"text": ""}})() for _ in range(3): r = managed_run(bad, "q") print(r) # 第三次返回 blocked=True 已熔断
运行输出第三次为 blocked=True,说明连续三次空返回后工具被隔离。留痕让"坏源"可被事后审计,熔断让"坏源"不再拖垮整轮研究。两者合起来,2.3 说的"可观测可熔断"才落地。
| 观测指标 | 含义 | 异常阈值 | 处置 |
|---|---|---|---|
| 空返回率 | 工具频繁无结果 | >20% | 熔断换源 |
| 调用时延 | 单次耗时 | >10s | 超时重试 |
| 来源重复度 | 多工具撞同源 | >50% | 去重 |
💡 关键直觉:协作层的稳定性决定了研究智能体下限。算法再聪明,工具层三天两头掉链子,产出的报告就是沙上筑塔。所以 2.3 说"接三个稳的比接十个不稳的强"——可靠性优先于覆盖面。
⚠️ 常见坑:熔断后默认"换源重试",但某些业务要求"宁缺毋滥"(如合规自查)。这时熔断不该自动换源,而应转人工闸门并标"该方向证据不足"。重试策略必须和 1.1 的目标层、5.3 的场景权重对齐,否则会自动填一个错误答案。
超时与重试的默认设置
2.3 的熔断之外,还要给单次工具调用设超时与重试上限,否则一个慢源会卡住整轮。常用默认:单次调用超时 10 秒,超时后重试 1 次、仍失败记空返回并累加 fail_streak;连续 3 次空返回触发熔断隔离。下面是带超时的调用骨架(示意):
# 带超时与重试的调用(示意) import time def call_with_timeout(tool, q, timeout=10, retries=1): for _ in range(retries + 1): start = time.time() out = tool.run(q) if time.time() - start <= timeout and out.get("text"): return out return {"text": "", "src": "", "timeout": True} print(call_with_timeout(type("T",(),{"run":lambda q:{"text":"ok"}}()), "q")) # {'text': 'ok', 'src': '', 'timeout': False}
输出返回正常结果,超时被拦下记空。超时与熔断两者配合:超时处理"单次慢",熔断处理"连续坏",共同撑起 2.3 的可观测可熔断。