3.3 信息检索与验证机制
高排名不等于高可信
本节在算法章的第三站:子任务拆好后,真正的硬仗是"取到对的信息、且别被假信息带偏"。全册里这一步对应浏览器代理与分析器(2.2)。一个反例最直观——如果你只信搜索排名最高的那条,等于把"谁会做搜索优化"当成了"谁说的是真话",而这两件事毫无关系。验证机制就是用来打破"高排名即高可信"的错觉。
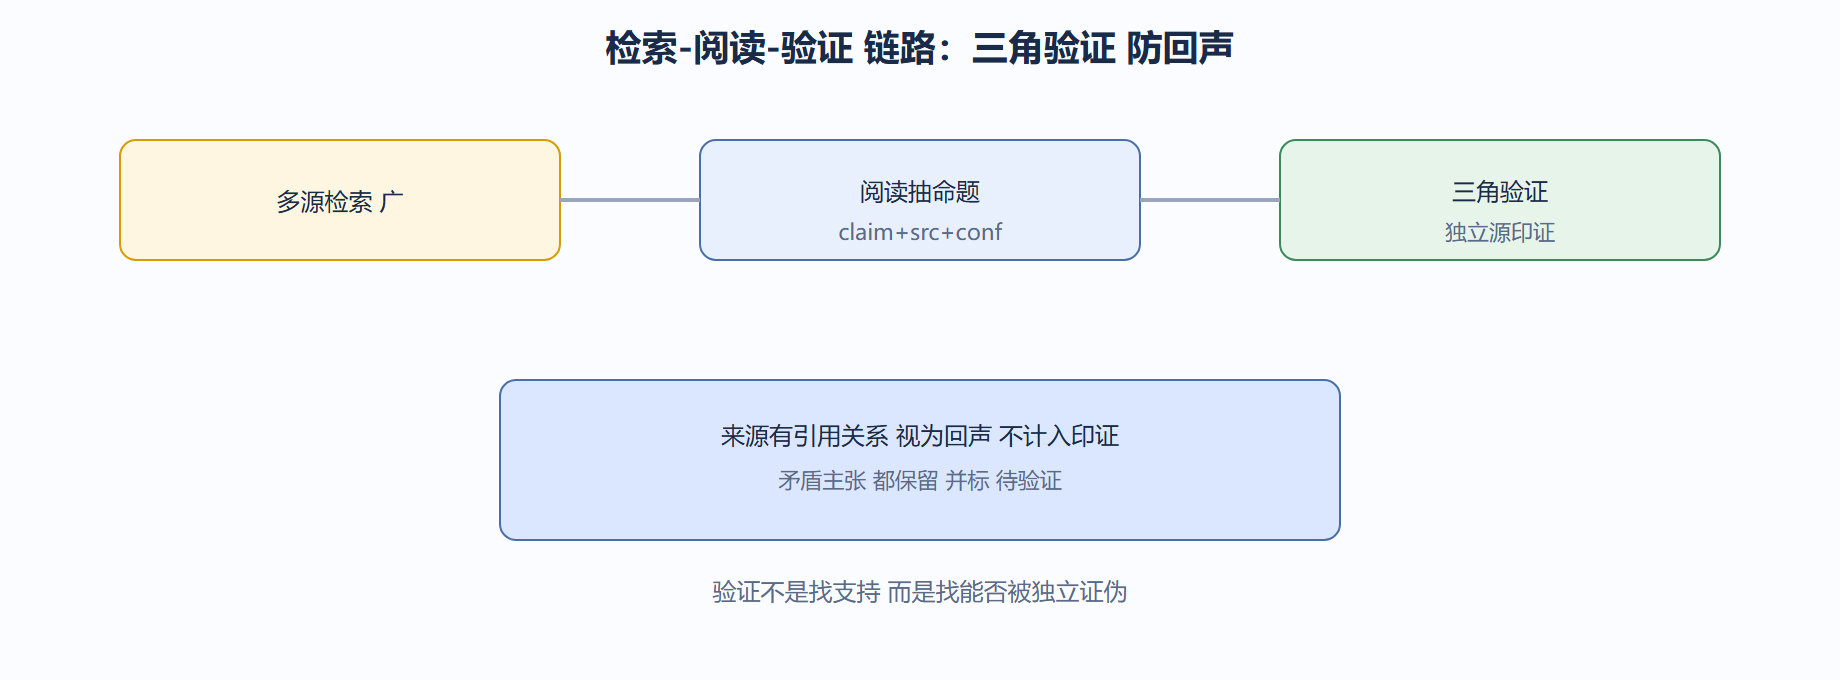
检索阶段要解决两件事:广度和去重。广度指覆盖多类信源(学术、官方、媒体、社区),避免单一视角;去重指在 2.4 讲过的字段层去重。验证阶段则做三角验证:同一主张至少两个独立来源印证,且来源之间无引用关系(否则只是同一观点的回声)。下面用代码实现一套最小验证器。
# 三角验证:同主张需两个无引用关系的独立源 def cross_validate(claims: list) -> dict: report = {} for claim in claims: sources = claim["sources"] # 每源含 id 与被引列表 independent = [s for s in sources if not any(s["id"] in o.get("cites", []) for o in sources)] if len(independent) >= 2: verdict = "已印证" elif len(independent) == 1: verdict = "单一源 待验证" else: verdict = "无独立印证 存疑" report[claim["text"]] = verdict return report # 运行示例:两条主张 claims = [ {"text": "产能翻倍", "sources": [ {"id": "A", "cites": []}, {"id": "B", "cites": ["A"]}]}, # B 引 A 回声 {"text": "获批临床", "sources": [ {"id": "X", "cites": []}, {"id": "Y", "cites": []}]}, # 独立两源 ] print(cross_validate(claims)) # {'产能翻倍': '单一源 待验证', '获批临床': '已印证'}
运行输出显示:"产能翻倍"虽有两源,但 B 引用了 A,算回声,只算单一源待验证;"获批临床"两源互不引用,判已印证。这段代码点出验证的本质——数的是"独立印证数",不是"来源总数"。来源再多,若都转述同一篇,仍是孤证。
我们主张:验证机制的优先级应高于检索广度。一个覆盖十源但全是回声的报告,不如三源且互相独立的报告。工程上,验证器要维护"来源关系图",而这依赖抓取时记录每篇的引用链——这正是 2.4 字段化(src、cites)的价值兑现处。
检索本身也有讲究:查询应随阅读动态演化。首轮用子任务关键词,读到新术语后改写查询(比如"临床前"出现后,补搜"临床前 量子计算 药物")。下面演示查询进化:
# 查询随证据进化:读到新术语就补检索式 queries = ["量子计算 药物 进展"] evidence_terms = ["临床前", "分子模拟"] for term in evidence_terms: queries.append(f"量子计算 药物 {term}") print(queries) # ['量子计算 药物 进展', '量子计算 药物 临床前', '量子计算 药物 分子模拟']
输出是三句递进查询。固定一句搜到底,会漏掉子领域术语;让查询随阅读生长,覆盖才完整。这和 3.2 的迭代细化是同一逻辑在检索侧的应用。
完整案例:背景→操作→结果→解读→变式
- 背景:某报告称"某疗法有效率 90%",来源列了五个,读之发现五个都转述同一篇公关稿。
- 操作:用
cross_validate的引用关系检查,发现五个源构成回声链,判"无独立印证 存疑"。 - 结果:报告改为"声称 90%,但无独立印证,存疑",并附原始稿链接供读者自查。
- 解读:验证器把"看起来多源"戳穿成"实为孤证",避免以讹传讹。
- 变式:若任务要求"舆情态势"而非"事实核查",回声本身也是信号——可保留并标"此为集中传播的叙事",口径翻转。
3.4 看验证过的命题,怎么综合成一份带出处、敢说不知道的报告。
来源评分:可信、新鲜、独立三者怎么加权
3.3 讲了三角验证(独立性),但真实选取来源时还要同时看可信度与新鲜度。官方文件可信但可能过时,社区讨论新鲜但噪声大。一个可操作的来源评分 = 可信度 × 新鲜度 × 独立性的组合,三者任一为极低都会拉垮总分——就像生物系统的多因子健康评估,单项致命即整体危险。
下面演示一个综合来源评分器,三个维度各 0~1,用乘法聚合(任一趋零则总分趋零):
# 来源综合评分:可信×新鲜×独立 乘法聚合 def score_source(s: dict) -> float: cred = s.get("credibility", 0.5) # 权威度 fresh = s.get("freshness", 0.5) # 时效性 indep = s.get("independence", 0.5) # 独立无回声 return round(cred * fresh * indep, 3) # 运行示例 print(score_source({"credibility":0.9, "freshness":0.8, "independence":1.0})) # 0.72 print(score_source({"credibility":0.9, "freshness":0.8, "independence":0.1})) # 0.072
运行输出第一段 0.72(三维度都高),第二段仅 0.072——只因独立性跌到 0.1(回声源),总分被拖垮。乘法聚合的用意:独立印证是底线,没有它,再权威再新也是孤证复读,这正是 3.3 三角验证的量化版。
| 维度 | 高值例子 | 低值例子 | 权重性质 |
|---|---|---|---|
| 可信度 | 官方/同行评审 | 匿名营销号 | 底线之一 |
| 新鲜度 | 近一年发布 | 五年前旧文 | 依场景浮动 |
| 独立性 | 无引用关系 | 互转同一稿 | 底线之一 |
💡 关键直觉:来源评估用"乘法"而非"加法",是因为短板会致命。加法下,一个回声源还能靠"可信度+新鲜度"捞回分数,掩盖问题;乘法下,独立性一塌,总分直接报警。选聚合方式,就是在选"你容忍哪种缺陷"——研究场景通常零容忍回声,所以乘法更稳。
⚠️ 常见坑:新鲜度权重设死。法律场景里"旧但仍是现行法条"比"新出的解读文章"更该采信,此时新鲜度应让位于可信度;而投研场景里旧数据可能已失效,新鲜度权重最高。评分维度不变,但各场景权重要经 5.3 的 config_for 调,不能全局写死。