3.2 任务分解与迭代细化
拆解的第一步
本节在算法章的第二站:研究智能体拿到一个模糊问题,第一步不是搜,而是拆。全册里这一步对应架构章的"元认知协调层"(2.2),现在看它内部怎么算。一个值得反问的事实是——同样一句"分析量子计算在药物发现的影响",人脑会瞬间蹦出几个子方向,而机器若不会拆,就会把整句话塞进搜索框,得到一堆无关结果。分解质量直接决定后面所有检索的命中率。
分解可建模成一张子任务图:节点是子任务,边是依赖或信息流。目标是选一组节点,使"信息增益总和"最大、而"执行成本"不超预算。这是个带约束的取舍,不是简单罗列。下面用代码演示一个贪心分解器:每拆出一个子任务,估它的信息增益与成本,按性价比排序直到预算用完。
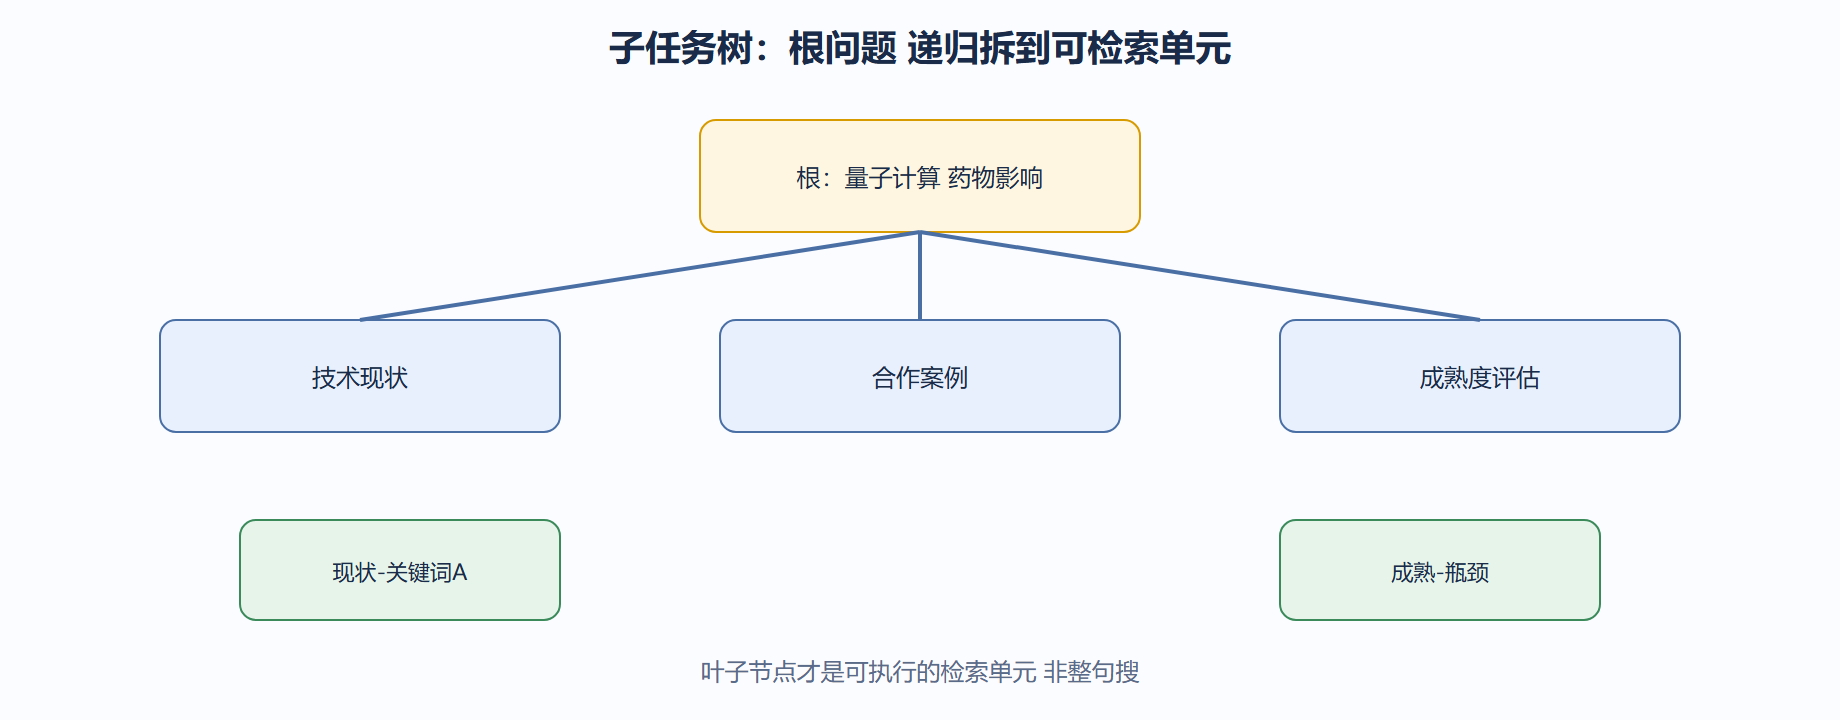
# 子任务分解:贪心按信息增益/成本 性价比选,预算封顶 def decompose(root: str, candidates: list, budget: float) -> list: # candidates: [(子任务, 信息增益, 成本)] ranked = sorted(candidates, key=lambda c: c[1] / c[2], reverse=True) chosen, spent = [], 0.0 for name, gain, cost in ranked: if spent + cost <= budget: chosen.append(name) spent += cost return chosen # 运行示例:根问题拆出的候选子任务 cands = [ ("技术现状", 0.9, 0.3), ("合作案例", 0.7, 0.2), ("成熟度评估", 0.8, 0.4), ("政策环境", 0.4, 0.3), ] print(decompose("量子计算药物", cands, budget=0.9)) # 输出 ['技术现状', '合作案例', '成熟度评估'] (政策环境超预算被弃)
运行输出是三个子任务,"政策环境"因预算不足被弃。这说明分解不是"列得越多越好",而是受预算约束的取舍——和架构章说的"资源限制"一致。若把预算提到 1.2,四个都会被选。
我们主张:分解的关键产出是"叶子节点粒度"。叶子必须小到能直接翻译成一条检索式,而不是另一个还需再拆的短语。很多人分解失败,是把"技术现状"当叶子去搜,得到的仍是泛泛结果;真正该搜的是"技术现状-近三年-临床前"这种粒度。
迭代细化是指:首轮分解不必完美。先搜一轮,新证据可能暴露原图漏掉的子任务,于是回头补节点——这正是数据流章(2.4)里"置信度不足回 planner"的算法侧实现。下面演示细化:
# 迭代细化:首轮后发现缺口,补子任务 plan = ["技术现状", "合作案例"] evidence_gaps = ["缺乏 成本侧 数据"] # 首轮阅读发现的空白 if evidence_gaps: plan.append("成本效益分析") # 补一个叶子 print(plan) # ['技术现状', '合作案例', '成本效益分析']
输出在原计划后追加了"成本效益分析"。这段看似简单,却是研究智能体区别于检索增强生成的核心循环:证据改变计划,而非计划一成不变。
完整案例:背景→操作→结果→解读→变式
- 背景:分析师直接搜"量子计算药物影响",得到 80% 泛泛科普,难以成文。
- 操作:用上面
decompose先拆成技术/案例/成熟度三叶子,各自检索,再迭代补"成本"。 - 结果:三方向命中率显著提升,且补出的成本维度让报告有了决策视角。
- 解读:分解把"一句话难题"转成"多道可检索小题",命中率与覆盖同步上升。
- 变式:若预算极紧,可只选性价比最高的"技术现状",其余靠综合层用已有证据推断并标不确定。
3.3 看这些子任务检索到的信息,怎么辨真假、怎么交叉验证。
子任务图的执行顺序:依赖决定先后
3.2 的分解产出一张子任务图,但"先搜哪个"不是随意的——有依赖的节点必须等前置完成。比如"成熟度评估"往往依赖"技术现状"的输出(要先知道技术到哪,才能评成熟度)。用建筑类比:你不会先装屋顶再打地基。把依赖关系显式成边,就能用拓扑排序排出合法执行序,避免智能体在信息还没就绪时就硬干。
下面演示对子任务图做拓扑排序,输出一条合法执行顺序:
# 子任务图拓扑排序:按依赖排出执行序 def topo_order(nodes: dict) -> list: # nodes: {任务: [依赖]} order, done = [], set() while len(done) < len(nodes): for n, deps in nodes.items(): if n in done: continue if all(d in done for d in deps): # 依赖已就绪 order.append(n); done.add(n); break return order # 运行示例 graph = {"技术现状": [], "合作案例": [], "成熟度评估": ["技术现状"], "成本分析": ["技术现状"]} print(topo_order(graph)) # ['技术现状', '合作案例', '成熟度评估', '成本分析'](或案例先于成熟度)
运行输出里"成熟度评估"一定排在"技术现状"之后(依赖约束),"合作案例"无依赖可先可后。拓扑排序保证:任何执行序都不会出现"还没知技术就评成熟度"的荒谬。
| 颗粒度 | 例子 | 能否直接检索 | 风险 |
|---|---|---|---|
| 粗 | 技术现状 | 否 | 搜出泛泛科普 |
| 中 | 技术现状-近三年 | 勉强 | 仍偏大 |
| 细 | 技术现状-近三年-临床前 | 能 | 最优检索式 |
💡 关键直觉:分解质量 = 叶子颗粒度。叶子必须细到能直接翻译成检索式,而不是另一个待拆短语。3.2 说"把'技术现状'当叶子去搜会得到泛泛结果",根因就是颗粒度停在粗层,没落到"近三年-临床前"这种可执行粒度。
⚠️ 常见坑:依赖画错方向。有人把"成熟度评估"标成"技术现状"的前置依赖,导致系统先评估再搜集技术,逻辑倒挂。依赖边必须表达"信息从哪流向哪",画反了拓扑排序虽不报错,执行出来的却是废顺序。建议画完图后用上面 topo_order 跑一遍,再人工核对首尾任务是否符合常识。
分解质量的自检清单
每次分解完,用三问自检:叶子是否都能直接翻译成检索式(不能就再拆);是否覆盖问题的所有关键侧面(漏了用 4.1 missing_aspects 补);依赖方向是否"信息从哪来回哪去"(画反用 topo_order 验)。三问全过,分解质量合格。这条清单把 3.2 的方法落成上线前必勾项,避免把粗颗粒度直接丢给检索。
| 自检项 | 不过的表现 |
|---|---|
| 叶子可检索 | 搜出泛泛科普 |
| 侧面全覆盖 | 报告漏风险/成本 |
| 依赖方向对 | 先评后搜逻辑倒挂 |