3.5 大型语言模型 (LLM) 的角色与集成
模型在哪出力
本节收束算法章:把前面所有步骤里"大模型在哪出力"说清楚。全册前两节(3.1–3.4)的算法,本质都跑在模型之上,但模型不是主角,是零件。我们给一个直接定义:LLM 在研究智能体里扮演"通用推理与生成单元",它读文字、出计划、写句子,但不知道网上发生了什么、也不该替你拍板——那些靠工具和闭环补足。
模型在四个位置出力。一,规划:把问题转成子任务(3.2 的 decompose 用模型生成候选)。二,抽取:从网页抽命题(3.3 的分析器)。三,验证:判断来源是否独立、主张是否矛盾。四,成文:把结构化句子润色成报告(3.4)。注意检索与执行不靠模型,靠工具——这是"模型负责想、工具负责做"的分工。
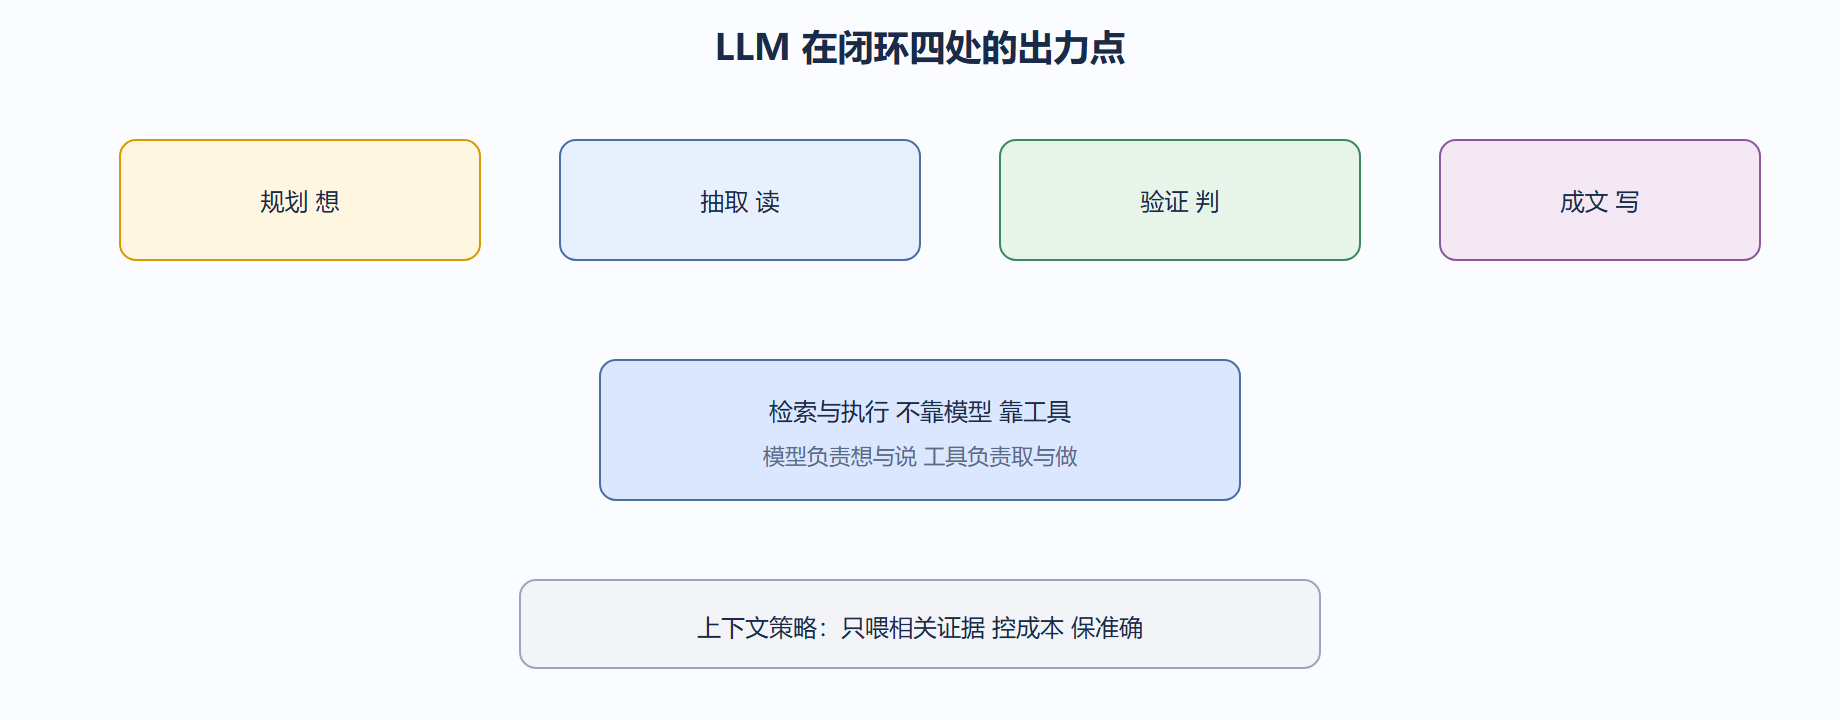
集成模型时最易被忽视的是上下文策略:把整篇网页塞给模型既贵又淹没了重点。正确做法是先抽取命题(字段化),再把"与当前子任务相关的命题"喂给模型。下面演示一个最小上下文选择器:
# 上下文策略:只选与当前子任务相关的命题喂模型 def select_context(propositions: list, subtask: str) -> list: # 简化:用关键词重叠判断相关性 kw = set(subtask.split()) scored = [(p, len(kw & set(p["claim"].split()))) for p in propositions] scored = [p for p, s in scored if s > 0] return scored[:3] # 最多三条例证 控成本 # 运行示例 props = [ {"claim": "产能翻倍 技术"}, {"claim": "合作 案例 医院"}, {"claim": "成本 下降 制造"}, {"claim": "政策 支持 国家"}, ] print(select_context(props, "技术 现状")) # [{'claim': '产能翻倍 技术'}]
运行输出只选出"产能翻倍 技术"——与子任务"技术 现状"相关。若把整本命题池都喂进去,模型会被无关信息干扰且 token 暴涨。上下文策略是"低成本高准确"的开关,比换更大模型更划算。
我们主张:模型选型看"在哪出力"而非"越大越好"。规划与成文吃推理质量,可用强模型;抽取与验证吃指令遵循,中等模型够用。混合部署(详见第五章)正是按这个分工配模型,而非全场一个巨模型。
完整案例:背景→操作→结果→解读→变式
- 背景:团队给研究智能体全场用顶级模型,月成本极高,但报告质量提升有限。
- 操作:按出力点拆分,抽取与验证改用中等模型,仅规划与成文用强模型,并加上下文选择。
- 结果:成本降约六成,报告质量(按第四章指标)几乎持平。
- 解读:模型不是越贵越对,用对位置才值。全场巨模型是懒政式的选型。
- 变式:若任务领域极专业(如法律),抽取也需强模型理解术语,则只在"成文"用中等模型,分工随领域浮动。
第三章收口:强化学习(3.1)、分解(3.2)、检索验证(3.3)、合成(3.4)、模型集成(3.5)已构成完整算法链。第四章我们给这条链一把尺子,量它到底研究得好不好。
混合部署:按出力点分配模型档位
3.5 说"模型选型看在哪出力"。落地成部署就是混合档位:规划与成文吃推理质量,用强模型;抽取与验证吃指令遵循,用中等模型就够。用交通类比——长途干线用高铁(强模型保质量),支线接驳用公交(中等模型控成本),整体既快又省。全场一个巨模型,等于全程高铁,贵且没必要。
下面演示一个按任务类型路由模型档位的调度器:
# 模型档位路由:按出力点分派强/中模型 TIERS = {"strong": "gpt-强", "mid": "gpt-中"} def route(task: str) -> str: if task in ("plan", "draft"): # 规划/成文 用强 return TIERS["strong"] if task in ("extract", "verify"): # 抽取/验证 用中 return TIERS["mid"] return TIERS["mid"] # 运行示例 for t in ("plan", "extract", "draft", "verify"): print(t, "->", route(t)) # plan -> gpt-强 / extract -> gpt-中 / draft -> gpt-强 / verify -> gpt-中
运行输出里 plan 与 draft 走强模型,extract 与 verify 走中模型。配合 3.5 的上下文选择器(只喂相关命题),中等模型在抽取验证上几乎不丢质量,成本却砍掉一大块——这正是 5.2 性能优化的核心思路。
| 出力点 | 吃的能力 | 推荐档位 | 理由 |
|---|---|---|---|
| 规划 plan | 推理/分解 | 强 | 影响全局路径 |
| 成文 draft | 语言组织 | 强 | 决定可读与严谨 |
| 抽取 extract | 指令遵循 | 中 | 模板化即可 |
| 验证 verify | 比对判断 | 中 | 规则可辅助 |
💡 关键直觉:模型的钱该花在"决定方向的环节"。规划错一步,后面全歪;成文差一句,客户看不懂。这两处值得强模型。抽取验证是确定性高的体力活,中等模型配好提示词足够,把预算从这两处释放出来,整体性价比最高。
⚠️ 常见坑:上下文选择器(3.5 select_context)阈值卡太死,比如只取相关度大于 0 的前 3 条,可能漏掉"相关度低但至关重要"的反例证据。反例往往关键词重叠少,却最能戳破结论。建议保留一个"低相关但高冲突"的兜底通道,专门捞对立信息,否则综合层会陷入同温层。
混合部署的具体档位配置
3.5 的路由落到配置,给一份可抄的默认:强模型用于 plan 与 draft,上下文窗口 16k;中模型用于 extract 与 verify,窗口 4k 足够;所有模型前加 3.5 的上下文选择器,单任务最多喂 3 条例证。下面是档位配置示例:
# 混合档位配置(可抄默认) CONFIG = { "strong": {"tasks": ["plan", "draft"], "ctx": 16000, "temp": 0.3}, "mid": {"tasks": ["extract", "verify"], "ctx": 4000, "temp": 0.1}, "selector": {"max_examples": 3}, } def model_for(task): for tier, c in CONFIG.items(): if task in c.get("tasks", []): return tier return "mid" print(model_for("plan"), model_for("verify")) # strong mid
输出 strong mid,与路由一致。强模型低温保严谨、中模型更低温度保指令遵循,配合选择器控成本,这套默认在大多数团队场景可直接用,再按 5.3 场景微调。