第四章:能力与性能评估
第三章给了算法,这一章给尺子。研究智能体最容易被玄学化——"感觉它变聪明了"不是评估。我们要的是可复现的指标:它规划得合不合理、能不能识别自己的知识空白、多源信息整合得干不干净、在答不出时敢不敢说不知道。我们主张评估必须"过程导向":一个答案正确但路径冗余的系统,不如一个答案稍弱但策略漂亮的系统有长期价值。
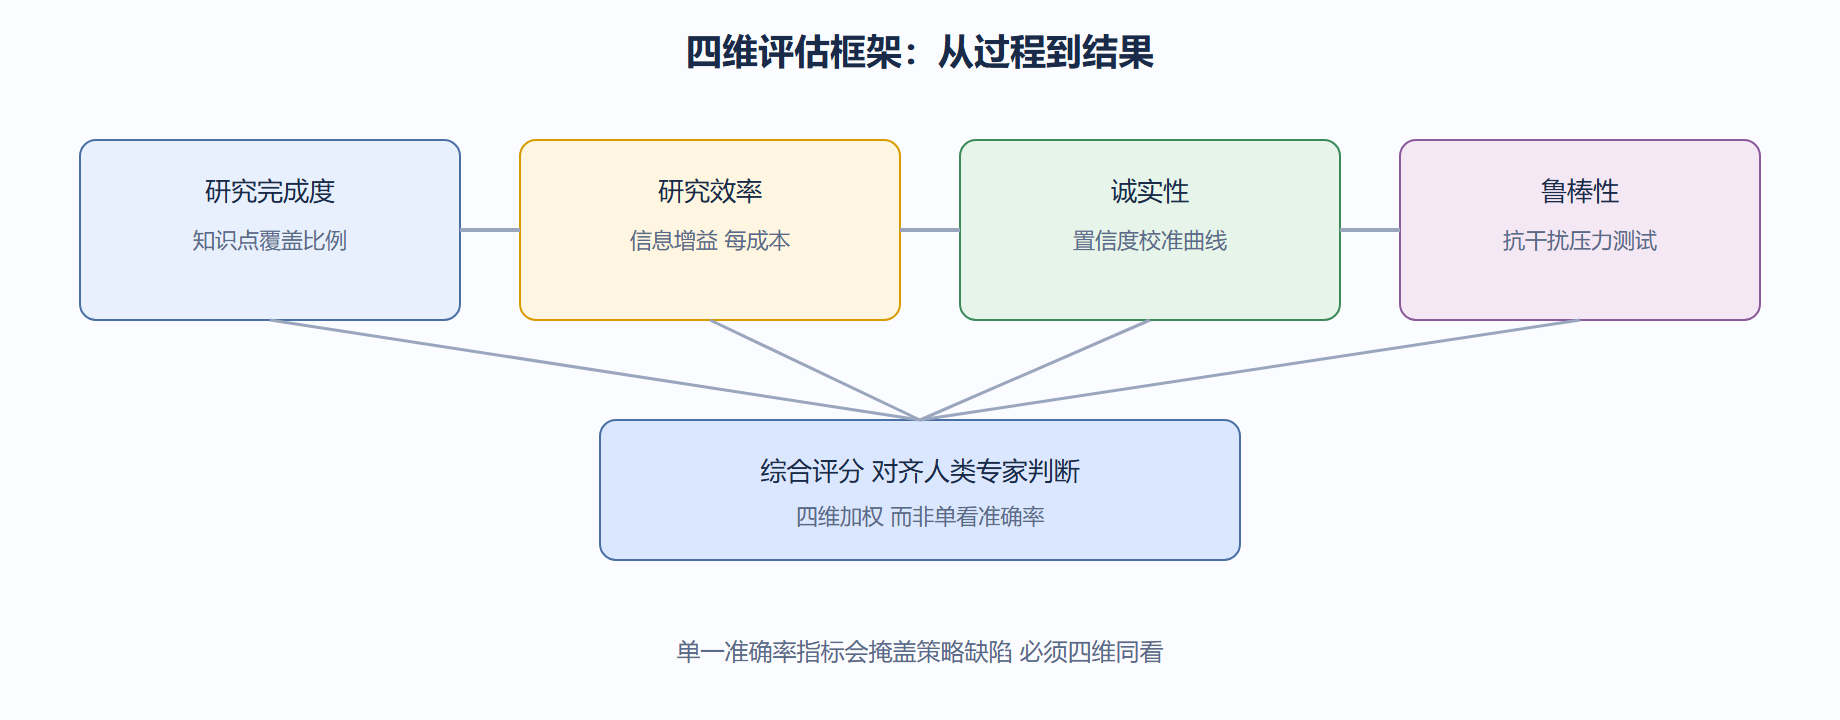
可考核知识点
- 能定义"研究完成度"为系统覆盖知识点与黄金知识点集合的比值,并说清黄金集为何是动态的。
- 能写出效率指标"信息增益除以成本"的含义,以及时间权重的作用。
- 能描述"置信度-准确率校准曲线"理想应贴近对角线,偏离说明什么。
- 能设计一项鲁棒性压力测试(如注入矛盾信息、随机让工具报错)。
- 能区分"答对了但靠运气"与"答对了且策略可靠"。
各节分工
| 节 | 解决的问题 | 读完你会 |
|---|---|---|
| 4.1 自主规划 | 策略好坏怎么量 | 评估规划轨迹 |
| 4.2 空白识别 | 它知不知道自己不懂 | 测知识边界认知 |
| 4.3 多源整合 | 多信源怎么揉 | 评估整合质量 |
| 4.4 诚实回答 | 答不出时表现 | 验不确定性表达 |
| 4.5 评估指标 | 总尺子怎么造 | 搭评估表 |
先决条件是第三章的算法已经理解,否则你看不懂"完成度"衡量的是什么过程。读完进第五章,那里讲怎么把这个已经被量过能力的系统真正跑起来、还能控制成本。
为什么必须有这一章(再展开)
第四章给算法一把尺子。没有评估,第三章的算法只是"感觉变强了"——无法复现、无法对比、无法改进。我们坚持过程导向:答案对但路径冗余,不如答案稍弱但策略漂亮。这一章让"好"从形容词变成可复现的数字。
读完这一章你能拿走的具象能力:
- 能定义"研究完成度"为覆盖知识点与黄金集的比值,说清黄金集为何动态。
- 能写效率指标"信息增益/成本"并解释时间权重。
- 能读置信度-准确率校准曲线,判断系统是否过度自信。
- 能设计鲁棒性压测(注入矛盾、随机让工具报错)。
各节分工(补产出列):
| 节 | 解决的问题 | 读完你会 | 产出 |
|---|---|---|---|
| 4.1 自主规划 | 策略好坏怎么量 | 评估规划轨迹 | 三维规划分 |
| 4.2 空白识别 | 知不知道不懂 | 测知识边界 | 空白探针 |
| 4.3 多源整合 | 多源怎么揉 | 评估整合质量 | 多样性/冗余分 |
| 4.4 诚实回答 | 答不出表现 | 验不确定表达 | 诚实核验 |
| 4.5 评估指标 | 总尺子怎么造 | 搭评估表 | 多维评估表 |
本章常见误区:只用答案正确率评估(掩盖脆弱);把来源计数当多样性;忽视校准曲线,以为高置信=高准确。
与邻章边界:第四章只讲"怎么量",不讲"怎么造算法"(第三章)也不讲"怎么跑起来"(第五章)。量完发现弱,回去改第三章奖励;量完发现贵,去第五章压成本。评估是连接前后两章的铰链。
本章速查清单
读完第四章,应能勾选:□ 定义研究完成度与黄金集;□ 写信息增益/成本指标;□ 读校准曲线判过度自信;□ 设计鲁棒性压测。四勾全满,你已有尺子,可进第五章把系统跑起来再量成本。少一项,评估会有盲区,量出来的"好"可能偏。
读这一章的两个提醒
第一,评估指标必须配套"黄金集"才有效。4.5 的总尺子里,"研究完成度"依赖黄金知识点集合,而黄金集是动态的——新问题有新的关键点。若拿旧黄金集评新任务,完成度会虚高。所以评估前先花力气建好黄金集,它比调指标权重更影响结论。
第二,过程指标与结果指标要一起报。只报答案正确率(结果)会掩盖脆弱,只报规划分(过程)又难对外解释。第四章主张两者并列:对外讲正确率,对内讲规划分,双轨才完整。
| 指标类型 | 代表 | 给谁看 |
|---|---|---|
| 结果指标 | 正确率/完成度 | 业务方 |
| 过程指标 | 规划分/校准 | 工程方 |
| 鲁棒指标 | 压测通过率 | 安全方 |