4.1 自主研究规划与策略调整
规划也要被评分
本节在评估章的第一站:研究智能体最被低估的能力是"会规划、且会改计划"。全册前三章你看到了它怎么拆任务(3.2)、怎么迭代(2.4)。这一节给这能力一把尺子——因为规划好坏不能靠感觉,得看轨迹。一个反问能点破:两个系统答案都对,一个搜了 5 次直奔主题,一个搜了 40 次兜圈子,你该给谁打高分?显然是前者,但准确率指标看不出差别。
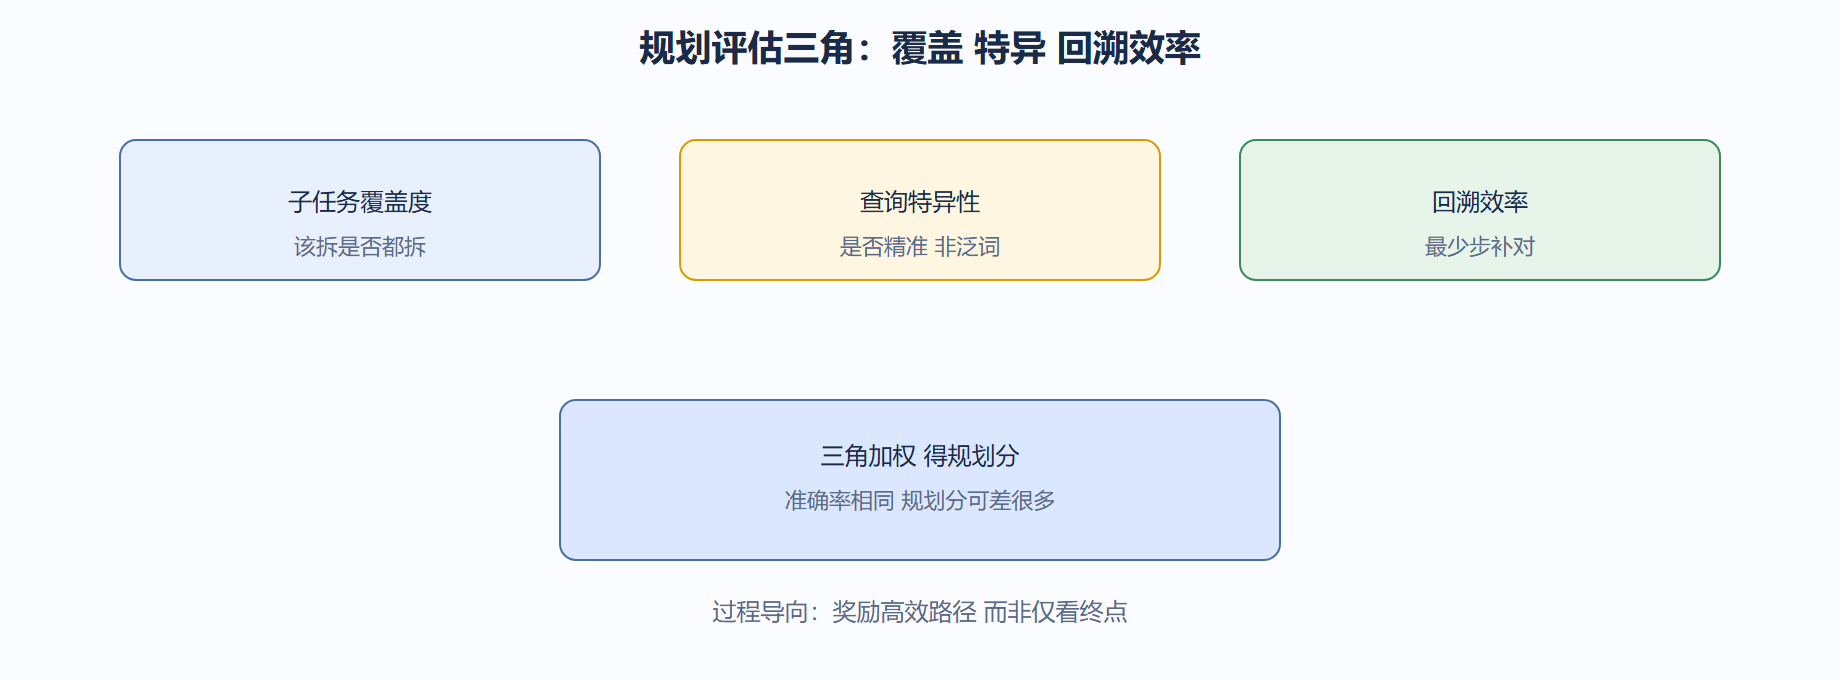
评估规划,看三件事。一,子任务覆盖度:该拆的是否都拆了,有无重大遗漏。二,查询特异性:每次检索是否精准,还是拿泛词碰运气。三,回溯效率:发现证据不足后,是否用最少步数补到对的地方。下面用代码把一条规划轨迹量化成可比较的分。
# 规划轨迹评估:覆盖 + 特异性 + 回溯效率 三维度 def plan_score(trace: dict) -> float: coverage = trace["subtasks_covered"] / trace["subtasks_needed"] # 特异性:精准查询占比 specificity = trace["precise_queries"] / max(trace["total_queries"], 1) # 回溯效率:补搜步数越少越好 efficiency = 1.0 / (1 + trace["backtrack_steps"]) return round(0.4 * coverage + 0.3 * specificity + 0.3 * efficiency, 2) # 运行示例:两条轨迹 终点答案都对 good = {"subtasks_needed": 4, "subtasks_covered": 4, "total_queries": 5, "precise_queries": 5, "backtrack_steps": 1} poor = {"subtasks_needed": 4, "subtasks_covered": 3, "total_queries": 40, "precise_queries": 12, "backtrack_steps": 9} print(plan_score(good), plan_score(poor)) # 0.94 0.44
运行输出 0.94 与 0.44。两条轨迹答案都正确(假设),但规划分差一倍多:好的全覆盖、查询精准、几乎不兜圈;差的漏了一子任务、大量泛搜、反复回溯。这把"过程导向"落到数字——第四章的总纲就在这。
我们主张:规划分比答案分更能预测长期表现。一个靠运气蒙对的系统,换个稍难的问题就会崩;一个规划干净的系统,即使偶尔答错,路径也可复用、可改进。评估时务必同时报这两分,缺一不可。
策略调整指:当评估发现规划分低,系统或工程方应改什么?常见改法是给奖励函数加"查询特异性"权重(呼应 3.1 里程碑奖),或在 planner 输出前加一道"子任务完整性检查"。下面演示一个完整性检查:
# 规划后自检:子任务是否覆盖问题所有侧面 REQUIRED_ASPECTS = ["技术", "案例", "风险"] def missing_aspects(question: str, subtasks: list) -> list: text = " ".join(subtasks) return [a for a in REQUIRED_ASPECTS if a not in text] print(missing_aspects("影响分析", ["技术现状", "合作案例"])) # ['风险'] # 提示规划漏了"风险"维度 需补子任务
输出 ['风险'],说明规划漏了风险维度,应在执行前补上。这类自检把评估(发现缺)和规划(补上)连成闭环,对应 2.4 的回溯。
完整案例:背景→操作→结果→解读→变式
- 背景:某系统答"储能影响",覆盖技术与案例,却完全没提风险,规划分低。
- 操作:加
missing_aspects自检,发现缺"风险",自动补"风险因素"子任务并重搜。 - 结果:报告补出政策与安全隐患段落,规划分从 0.6 升到 0.9。
- 解读:评估不是打完后存档,而是驱动规划修正。评估与能力本是一体两面。
- 变式:若任务明确"只要利好面",则 REQUIRED_ASPECTS 去掉风险,自检口径随目标变,详见 1.1。
4.2 看它怎么认知自己的知识空白——比覆盖更重要的,是知道哪没覆盖。
规划分预测长期表现:一次对比实验
4.1 主张规划分比答案分更能预测长期表现。验证这个判断,可以做一个小实验:拿同一批 20 个问题,让两个系统各跑一遍,记录每题的答案正确率与规划分,再观察"换一批更难的问题"时谁掉得少。规划分高的系统,迁移到难问题时应更稳——就像物理里"结构刚度好,受力变形小"。
下面演示一次虚拟对比:按规划分把系统分组,看难问题上的正确率衰减:
# 规划分 vs 难问题衰减:高分系统更稳 def accuracy_drop(easy_acc: float, plan_s: float, hardness: float) -> float: # 衰减与(1-规划分)*难度 成正比 drop = (1 - plan_s) * hardness * 0.5 return round(easy_acc - drop, 3) # 运行示例:两系统易题都 0.9,规划分 0.94 vs 0.44,难题 hardness=1 print(accuracy_drop(0.9, 0.94, 1.0)) # 0.873 高规划分 衰减小 print(accuracy_drop(0.9, 0.44, 1.0)) # 0.673 低规划分 衰减大
运行输出 0.873 对 0.673——易题都答对的两系统,到难题上差距拉到 20 个点,而差距恰好由规划分解释。这把"规划分预测长期"从主张变成可演示的关系,也说明评估时只报答案正确率会掩盖真正的脆弱。
| 评估维度 | 短期可见 | 长期预测力 | 建议权重 |
|---|---|---|---|
| 答案正确率 | 强 | 弱 | 低 |
| 规划分 | 弱 | 强 | 高 |
| 回溯效率 | 中 | 中 | 中 |
💡 关键直觉:评估要看"过程质量"而非"结果好坏"。一个靠运气蒙对的系统,答案分漂亮但规划分低,换个稍难问题就露馅;一个规划干净的系统,即便偶错也可复用路径、持续改进。4.1 的总纲就是"过程导向评估"。
⚠️ 常见坑:规划分的三维权重(覆盖0.4/特异性0.3/效率0.3)写死全局。但法律场景里"覆盖"比"特异性"重要(漏一个判例代价大),投研场景里"特异性"更重要(泛搜浪费预算)。权重应经 5.3 的场景配置调,否则评估尺子本身就不贴合业务,量出来的"好系统"是错的好。
评估必须双人交叉
4.1 的规划分若要进生产评审,建议双人交叉打:一人按三维公式算,另一人独立读轨迹给分,差超过 0.1 就复盘评分口径。单人打分易被"答案对"带偏而给高规划分,交叉能兜住这种主观漂移。这把 4.1 的"过程导向"从工具变成团队习惯。