5.1 开源实现与生态
站在谁肩膀上
本节在实践章的第一站:把前面四章的能力真正落到代码,第一步是选开源底座。全册讲到这,你已具备判断架构(第二章)与算法(第三章)的眼光,现在用这眼光挑"站在谁肩膀上"。设想一个场景:你要在两周内给团队搭一个能跑的研究助手,从头写训练循环不现实,选对开源套件能省掉九成脚手架。
开源生态大致三类。一类是"完整研究循环"框架,把 planner、检索、综合打包好,开箱可调;一类是"agent 编排"框架,只管模块调度(对应 2.2 的 MCP 管理器),检索与分析要自己接;三类是"检索/向量"专项库,只解决数据侧。选型看你的缺口在哪:要快出原型选一类,要深度定制选二类配三类。
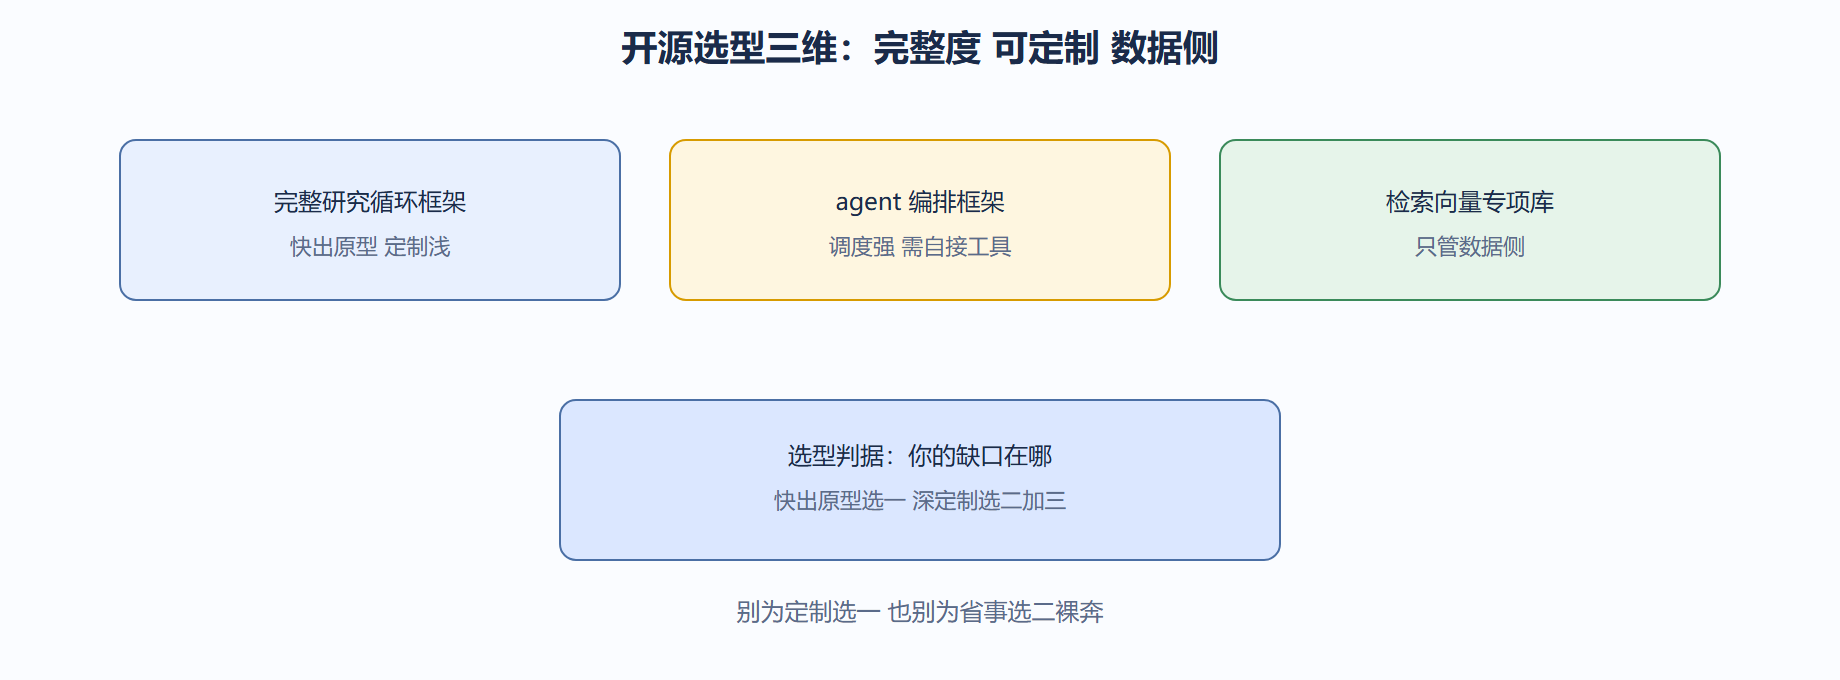
下面用代码做一个最小选型打分器,按你的诉求(原型速度、定制深度、数据掌控)给三类方案打分,避免凭印象选。
# 开源选型:按诉求权重给三类方案打分 def pick(stack_scores: dict, needs: dict) -> str: best, best_s = "", -1 for name, dims in stack_scores.items(): s = sum(dims[k] * needs[k] for k in needs) # 维度0-1 * 诉求权重 if s > best_s: best, best_s = name, s return best stacks = { "完整框架": {"原型速度": 0.9, "定制深度": 0.4, "数据掌控": 0.5}, "编排框架": {"原型速度": 0.5, "定制深度": 0.9, "数据掌控": 0.8}, "检索专项": {"原型速度": 0.3, "定制深度": 1.0, "数据掌控": 1.0}, } # 诉求:要快出原型 print(pick(stacks, {"原型速度": 0.6, "定制深度": 0.2, "数据掌控": 0.2})) # 完整框架 # 诉求:要深度定制 print(pick(stacks, {"原型速度": 0.2, "定制深度": 0.6, "数据掌控": 0.4})) # 编排框架
运行输出第一行"完整框架"、第二行"编排框架"——同一堆方案,诉求不同结论不同。选型没有"最好",只有"最配当前缺口"。这呼应 2.1 的定位优先原则:先定你要什么,再选底座。
我们主张:开源选型别追星。社区热度高的"完整框架"未必适合你——它可能把检索后端锁死,而你恰需要接私有库(呼应 5.2 混合部署)。反之,纯编排框架灵活但要从零接工具,小团队两周做不完。用上面打分器把诉求量化,比看 GitHub 星数靠谱。
完整案例:背景→操作→结果→解读→变式
- 背景:小团队跟风选了最热完整框架,结果检索后端锁死,无法接内网文档,卡两周。
- 操作:用
pick重算,诉求是"数据掌控 0.5、定制 0.3",结论转向编排框架加私有检索库。 - 结果:换底座后三天接好内网,原型如期交付。
- 解读:热度不等于适配。把诉求量化,选型从玄学变计算。
- 变式:若后续要接真实外网做训练(呼应 3.1),则"数据掌控"降权、"原型速度"升权,可能又回到完整框架——诉求随阶段变。
5.2 讲具体怎么把选好的底座配置成一个能跑的研究任务。
选型别只看星数:用维护信号给底座打分
5.1 的 pick 按诉求打分,但"诉求"从哪来?要先判断一个开源底座值不值得托付。星数是最容易被营销的指标(可刷、可蹭热点),真正该看的是维护信号:最近一次提交距今、issue 响应速度、是否有真实生产案例、文档是否随版本更新。用建筑类比——选地基看的是抗震报告和验收记录,不是售楼处的样板间。
下面演示一个开源底座健康度打分器,把维护信号落成可算分:
# 开源底座健康度:维护信号而非星数 def oss_health(meta: dict) -> float: score = 0.0 score += 0.3 if meta["commits_last_90d"] > 20 else 0.0 # 近期活跃 score += 0.3 if meta["issue_response_days"] < 7 else 0.0 # 响应快 score += 0.2 if meta["prod_case"] else 0.0 # 有生产案例 score += 0.2 if meta["docs_fresh"] else 0.0 # 文档随版更 return round(score, 2) # 运行示例 healthy = {"commits_last_90d": 45, "issue_response_days": 3, "prod_case": True, "docs_fresh": True} stale = {"commits_last_90d": 2, "issue_response_days": 40,"prod_case": False,"docs_fresh": False} print(oss_health(healthy), oss_health(stale)) # 1.0 0.0
运行输出 1.0 对 0.0——一个活跃有案例、一个停滞无案例。星数可能两者都高(老项目星多但已停更),但健康度一眼分清。把 oss_health 作为 5.1 pick 的准入门槛:分低于 0.5 的直接不进候选,再谈诉求匹配。
| 信号 | 健康阈值 | 易伪装度 | 权重 |
|---|---|---|---|
| 近期提交 | >20/90天 | 低 | 0.3 |
| issue响应 | <7天 | 中 | 0.3 |
| 生产案例 | 有 | 低 | 0.2 |
| 文档新鲜 | 随版更 | 中 | 0.2 |
💡 关键直觉:开源底座是你要"住在上面"的地基,稳定比时髦重要。一个更新频繁但每次大改 API 的项目,反而增加你的迁移成本;一个节奏稳、文档跟手、有真实上线案例的项目,才是长期省心的选择。所以 5.1 说别追星,追维护信号。
⚠️ 常见坑:被"完整框架"的开箱即用迷惑,忽略它把检索后端锁死(呼应 2.1 定位)。即便 oss_health 满分,若它的适配器不开放、连不上你的私有库,诉求里的"数据掌控"永远得 0 分。健康度只是准入,最终还要回到 pick 的诉求匹配,两关都要过。
准入后再看诉求匹配
5.1 的 oss_health 只是第一关,过了才进 pick 的诉求匹配。一个常见错误是健康度高分就直接采用,却没问"它的适配器开不开放"。补一段准入校验:健康度≥0.5 且适配器开放、能接你的私有检索后端,才进候选。否则即便星多、活跃,也连不上你的数据,诉求里的"数据掌控"永远 0 分。
| 准入关 | 条件 | 不过的代价 |
|---|---|---|
| 健康度 | ≥0.5 | 维护断层 |
| 适配器开放 | 是 | 锁死后端 |
| 私有库可接 | 是 | 数据掌控0 |
⚠️ 健康度与诉求要两关串行:先健康度筛掉烂摊子,再诉求匹配挑最贴的,顺序不能反。