1.1 Kettle定义、历史与核心价值
1.1 Kettle定义、历史与核心价值
为什么可视化 ETL 不是把脚本画成图那么简单
本篇是全册第 1 章第 1 节,承接导读的知识地图,为后面所有「转换」与「作业」操作建立统一的认知底座。
Kettle 是 Pentaho Data Integration 的俗称,底层完全用 Java 写成,因此它能在装了 JVM 的任何机器上运行,不必为操作系统重写逻辑。我们第一次把它引入项目时,最看重的不是拖拽界面,而是它把「一次数据处理」拆成了可独立重试的单元,这点后面会反复用到。
它的历史可以追溯到 2003 年,作者 Matt Casters 当时想解决商业 ETL 工具价格高、封闭、难以定制的痛点。开源之后,社区把两百多种数据源和处理器做成了插件,这让 Kettle 不像某些工具那样被厂商绑死。我们在选型时专门对比过,闭源方案二次开发成本明显更高。
所谓核心价值,我认为落在三点:可视化让血缘可追溯、模块化让组件可复用、声明式让开发者只关心「做什么」。这三者合起来,使一个新人也能在半天里看懂别人画好的转换,而不必逐行读脚本。把复杂度关进盒子里,是它最实在的工程贡献。
但要注意,可视化不等于零门槛。当转换里叠了三十个步骤、作业又嵌套了五层子作业时,图也会变成一团线团。我们吃过这个亏:一度以为拖拽能解决一切,结果维护成本反而上升。所以本册后面会强调「节的数量控制」和「命名约定」,那是从这里推导出的结论。
和手写脚本相比,Kettle 的代价是启动一个 JVM 的开销,以及图形元数据的学习成本。对于一次性、几十行就能写完的同步,脚本更轻;对于要长期跑、要被人接手、要可重试的管道,Kettle 的投入是划算的。因果很清楚:维护频次越高,可视化收益越大。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<trans> <name>demo_orders_sync</name> <step> <name>表输入</name> <type>TableInput</type> <sql>SELECT id, amount FROM src_orders WHERE day='${p_day}'</sql> </step> <step> <name>表输出</name> <type>TableOutput</type> <table>dst_orders</table> </step> <hop> <from>表输入</from> <to>表输出</to> </hop> </trans>
上面是一段最小转换的骨架:一个「表输入」步骤读取源数据,一个「表输出」步骤写入目标,hop 定义两者之间的数据流向。注意 SQL 里的 ${p_day} 是命名参数,运行时由 Pan 或 Kitchen 注入,这是后面参数化章节的基础。
# 用 Pan 在命令行跑一个转换,并注入运行参数 pan.sh /file:/jobs/demo_orders_sync.ktr \ -param:p_day=2026-08-25 \ -level:Basic # 退出码 0 表示成功,非 0 表示失败,可接入调度系统
命令行启动让转换可以脱离图形界面跑在服务器上。-param 把日期参数传进去,这样同一个 ktr 文件每天换参数就能复用,不必为每一天另存一份文件。我们把退出码接进监控,失败就自动告警。
背景
原先有一句 Shell 用 mysqldump 加 sed 做同步,字段一变就崩,且没人说得清某行数据经过了什么处理。
操作
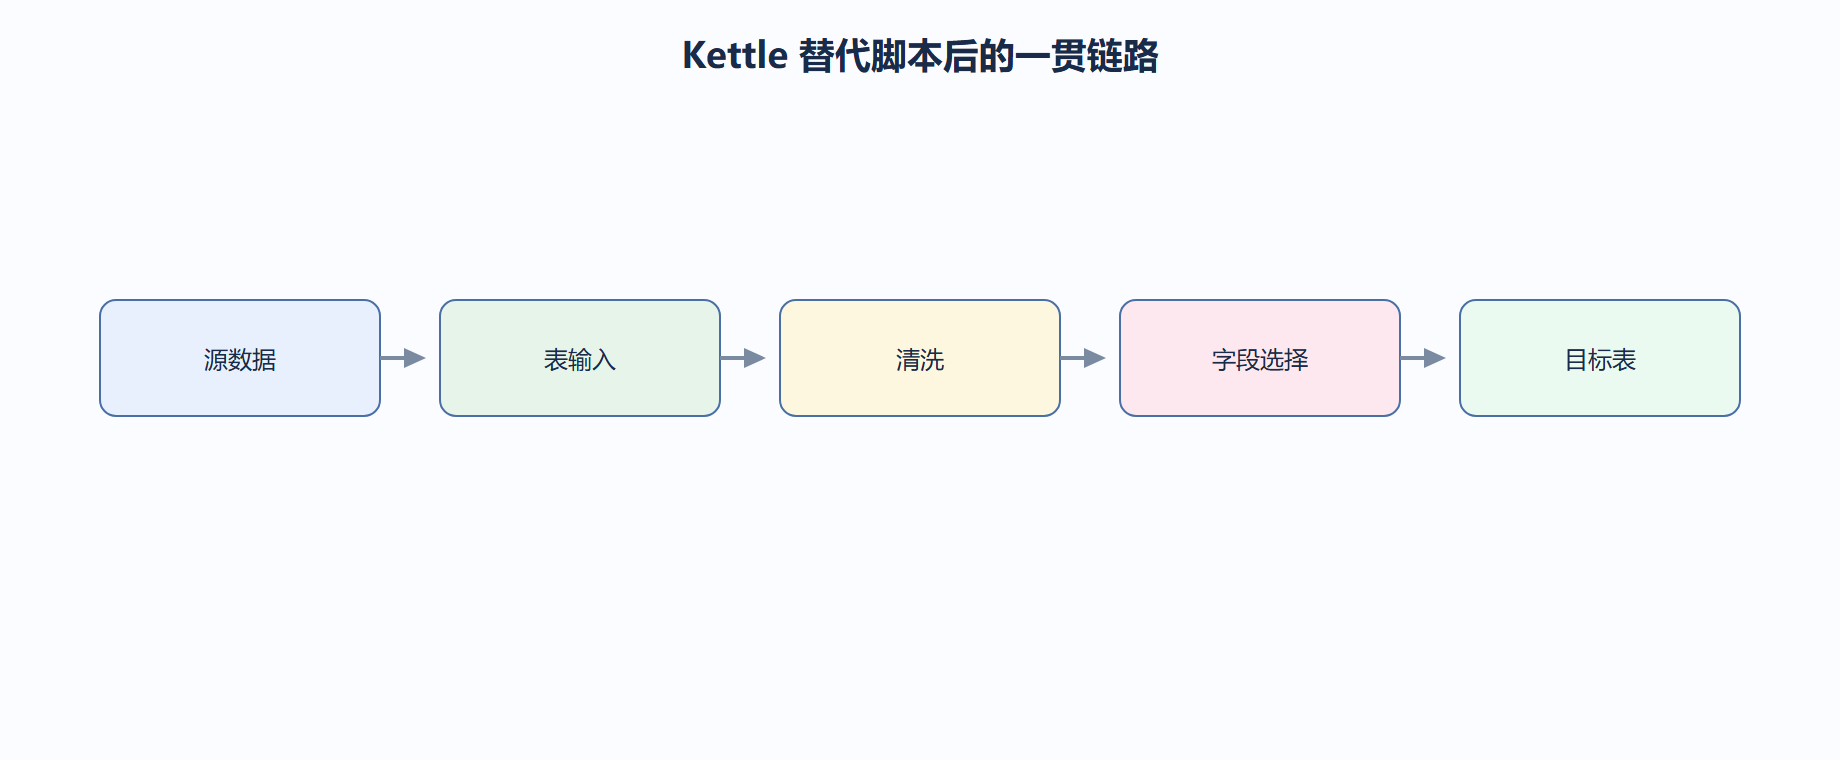
我们把它重画成一个转换:表输入读取、字段选择裁剪、值映射清洗、表输出写入。
<step><name>字段选择</name><type>SelectValues</type> <fields><field><name>amount</name><rename>amt</rename></field></fields> </step> <step><name>值映射</name><type>ValueMapper</type> <field_from>status</field_from><field_to>status_cn</field_to> </step>
结果
同步逻辑变成一张图,新同事十分钟看懂;字段改名、状态翻译都成了可点的配置。
解读
价值不在「快」,而在「可交接」。当原作者离职,图形元数据比脚本更易被人接手,这才是我们坚持用它的根因。
变式
若源端是接口而非数据库,只要把「表输入」换成「HTTP 输入」步骤,其余清洗逻辑完全不动,模块复用的好处立刻显现。
常见误区与工程取舍
误区一:以为装了 Kettle 就能不写代码。实际复杂清洗仍要写 JavaScript 或 SQL,工具只是把编排标准化。
误区二:把全部逻辑塞进一个巨型转换。我们建议单转换步骤数控制在二十以内,超出就拆成多个转换由作业串联。
取舍:一次性任务用脚本更省事;长期、多人维护的管道才值得用 Kettle 承载。
深入:可视化 ETL 的工程账怎么算
很多人纠结「到底用 Kettle 还是写脚本」,我们用一张账来算清。一次性、几十行能写完的同步,脚本更轻;但凡要长期跑、要被人接手、要可重试,Kettle 的投入就在维护成本上回本。具体看三个维度:血缘可追溯性(图形元数据天然记录每一步)、失败可重试性(步骤级重跑比全脚本重跑精细)、新人可接手性(看图比读脚本快)。三者权重越高,可视化收益越大。
-- 表输入步骤里的典型抽取 SQL(输入:业务库订单表;输出:下游转换的行集) SELECT id, order_no, amount, status, create_time FROM src_orders WHERE create_time >= TRUNC(SYSDATE) - 1 -- 增量抽取前一天 AND create_time < TRUNC(SYSDATE); -- 配合 ${p_day} 参数化后,可由 Kitchen 每天注入运行日,文件零拷贝复用
⚠️ 常见坑(选型与认知)
- 误以为装了 Kettle 就不写代码:复杂清洗仍要 JavaScript/SQL,工具只标准化编排。
- 误把全部逻辑塞进一个巨型转换:步骤超二十就该拆,否则图难读、难测、难排错。
- 忽视 JVM 启动开销:高频小任务反复起 JVM 反而比脚本慢,应合并批处理。
💡 关键直觉
- Kettle 的价值不在「快」,在「可交接」:原作者离职,图比脚本更易被人接手。
- 选型看维护频次:维护越频繁,可视化收益越大;一次性任务不必勉强上工具。
| 维度 | 手写脚本 | Kettle 可视化 |
|---|---|---|
| 血缘追溯 | 需读代码推断 | 图即文档,天然可见 |
| 失败重试 | 整体重跑 | 步骤级重跑 |
| 上手成本 | 低(会写即可) | 中(学元数据) |
| 长期维护 | 高(易腐化) | 低(结构化) |