第一章:Kettle概述与基础
第一章:Kettle概述与基础
本章要回答的三个问题
-
Kettle 到底是什么,它和手写脚本做 ETL 有什么区别
-
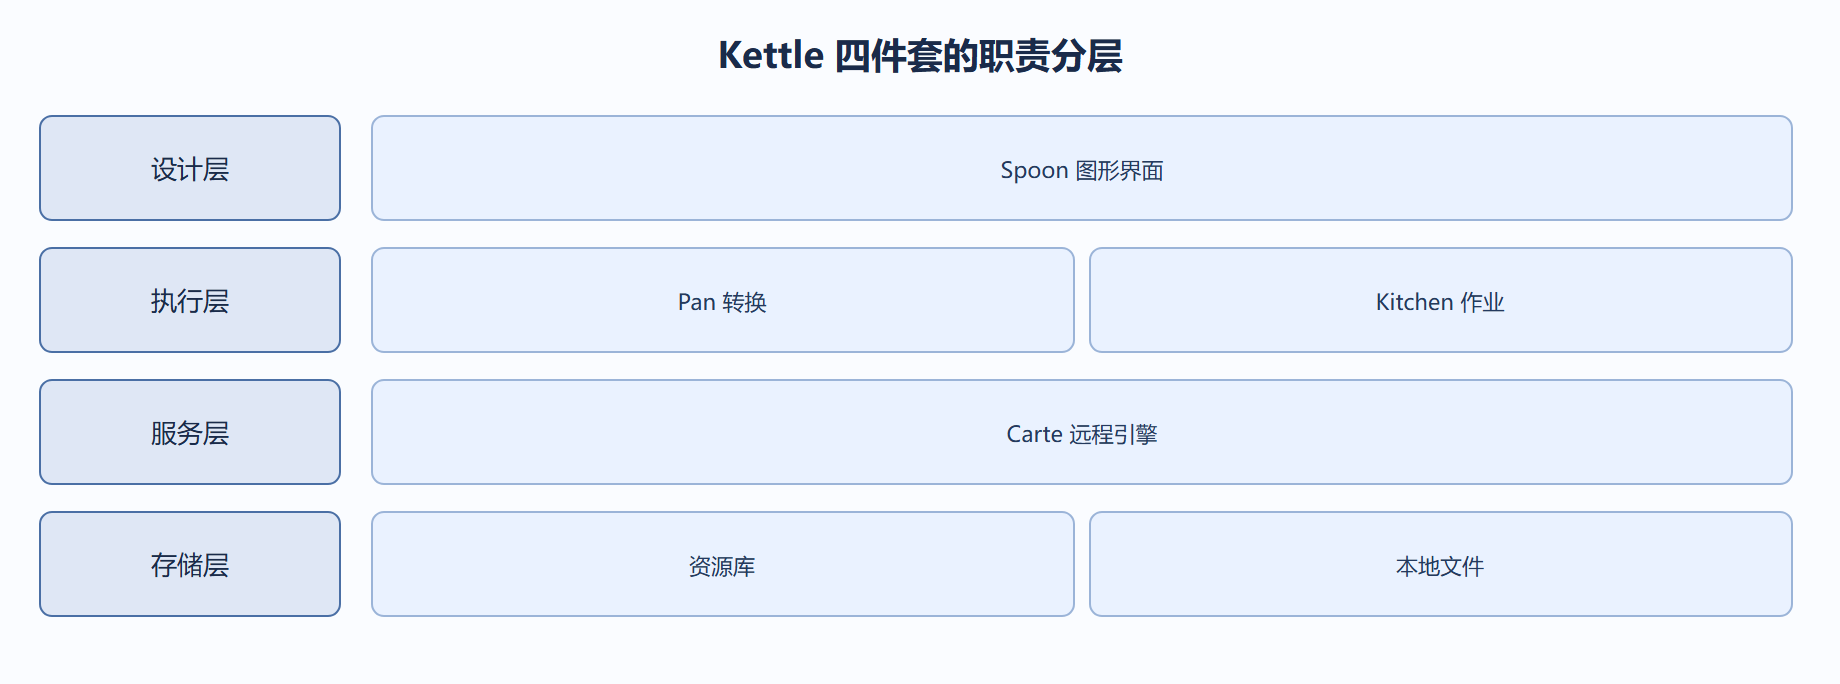
Spoon、Pan、Kitchen、Carte 各自承担什么职责
-
在 ETL 与 ELT 两种范式里,Kettle 站在哪一侧
为什么单独设这一章
很多团队一开始用 Python 或 Shell 脚本拼 ETL,规模小的时候没问题,一旦数据源涨到十几个、调度关系变复杂,脚本之间的依赖、重试、日志就成了一团乱麻。我们把这一章放在全册最前,是因为后面所有操作都建立在「先认清工具有几条执行链路」这件事上。只有先分清哪些是转换、哪些是作业,后面第三章和第四章才不会混着写。
读完能解决什么
读完后你能向同事讲清楚:为什么可视化拖拽不是噱头,而是把「数据血缘」和「可重试单元」固化下来的工程手段;也能在新建项目时判断到底该用转换还是作业来承载一段逻辑。
各节分工
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 1.1 | 定义、历史、核心价值 | 说清选型理由 |
| 1.2 | 组件与术语 | 看懂界面与文档 |
| 1.3 | ETL/ELT 概念与定位 | 判断范式与场景 |
先决条件
先决条件几乎为零:只要会在电脑上解压文件、配置环境变量即可。但建议带着一个真实的小需求来读,比如「把一张业务表按天同步到另一库」,这样后面的章节能直接对照。
往下走到哪
读完本章,建议直接进入第三章 Transformation 设计与开发,那是 Kettle 真正干活的单元;第二章的架构原理可以边用边回看。
本章常见误区
误区一:把 Kettle 当成「不用写代码」的银弹。实际复杂清洗仍要写 JavaScript 或 SQL,工具的价值是把编排、重试、血缘标准化,而不是消灭代码。
误区二:认为转换和作业可以混用。转换管「数据怎么流动」,作业管「事情按什么顺序发生」,把发送邮件、判断目录是否存在这类控制逻辑塞进转换,往往导致杂乱且难调试。
误区三:低估元数据即文件这一事实。一个 .ktr 本质上是一段 XML,这意味着它可以被版本库追踪、被 diff、被代码评审,也意味着手动改完文件要小心破坏结构。
与邻章边界
本章只建立认知,不碰具体操作:组件职责在 1.2 讲清后,运行时的内存流动细节留给第二章,画转换的实操留给第三章,编作业留给第四章。你如果在第一章就想知道「表输入步骤怎么配 SQL」,那是第三章的地盘,本章只需记住它在全册体系里的位置。
速查清单
- Spoon:图形设计器,画转换与作业的地方
- Pan:命令行跑单个转换
- Kitchen:命令行跑作业
- Carte:轻量 Web 服务,接受远程执行与集群任务
- 转换(Transformation):数据行级流水的载体
- 作业(Job):控制流与调度逻辑的载体
本章能产出的能力
读完本章你能向团队讲清:为什么我们选型可视化 ETL 而非纯脚本;在新建项目时该用转换还是作业承载一段逻辑;以及 Kettle 在 ETL 与 ELT 两种范式里分别适合站在哪一侧。这是后面九章反复引用的地基。
为什么这一章不能跳过
如果跳过本章直接去画转换,最常见的后果是:画到一半分不清该用转换还是作业,把「发邮件」「判断目录是否存在」塞进转换,结果图既难读又无法重试。我们在多个项目里见过这种返工——先补认知再动手,比先动手再返工省一整天。
本章最小上手练习
打开 Spoon,新建一个转换,拖入「表输入」与一个「表输出」,用 hop 连起来,写一句 SELECT 跑通预览;再新建一个作业,用「转换」条目调用刚才的转换,配一个失败分支连「发送邮件」。跑通这条最小链路,你就亲手验证了一遍本章的四个组件职责。
自测:你真的懂了吗
- 能否向同事说清 Spoon/Pan/Kitchen/Carte 各自的运行场景
- 拿到一个需求,能否判断第一段逻辑该落在转换还是作业
- 能否讲出在 ETL 与 ELT 两种范式下 Kettle 分别站在哪一侧