1.3 ETL/ELT概念与Kettle定位
1.3 ETL/ELT概念与Kettle定位
先装数据再算,还是先算再装,这是两条路
本篇是第 1 章第 3 节,也是第 1 章收尾,回答「Kettle 适合放在数据管道的哪一段」,为第二章原理做铺垫。
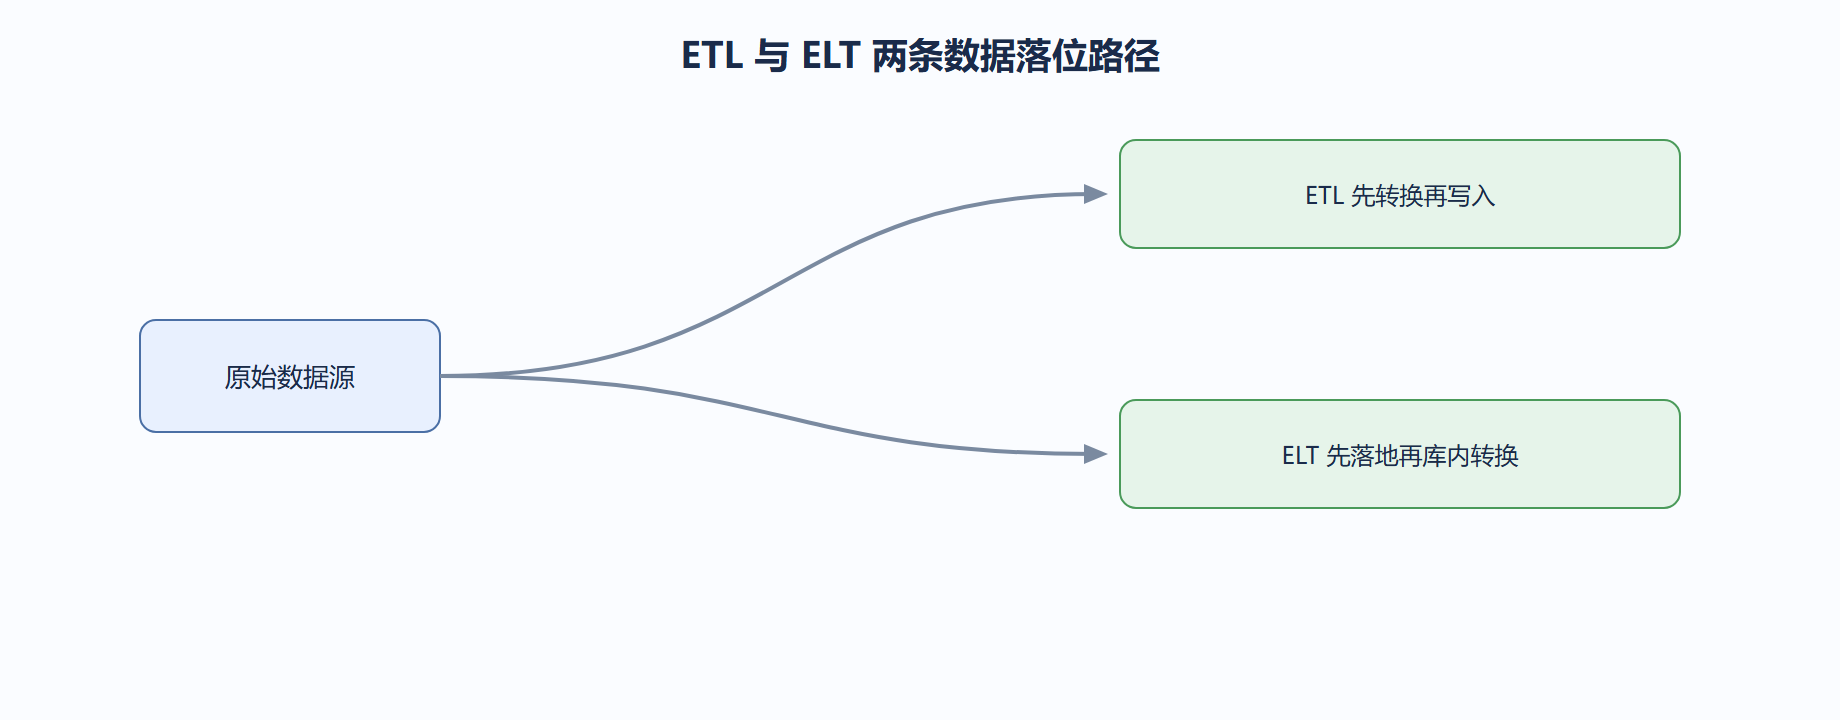
ETL 指抽取、转换、加载,顺序是先把数据洗好再写进目标;ELT 则反过来,先把原始数据整体灌进目标(通常是数据仓库),再用 SQL 在库内转换。我们用 Kettle 时,多数场景走 ETL,因为转换发生在写入之前,目标库负担小。
但 Kettle 并不排斥 ELT。它的「表输入」可以读、「数据库查询」步骤可以做维度补全、再用「表输出」写回同一库的暂存表,本质上把转换推到了库内。我们处理宽表时常用这招:先用 Kettle 把原始层落地,再让仓库的 SQL 做重计算。
Kettle 的定位因此是「连接器」而非「数据库」。它不存数据,只搬运和加工,这点和 Spark、Flink 不同——后者是计算引擎,Kettle 更像把各种源和目标缝起来的缝纫机。我们在架构图里始终把 Kettle 画在源与目标之间的那一层。
选型上,如果数据源杂乱、目标多样、又要可控的调度,Kettle 很合适;如果追求极致实时流、毫秒级延迟,那它力不从心,应让位给消息队列加流计算。我们踩过的坑是拿 Kettle 硬扛实时大屏,结果批处理节奏跟不上,后来切到了流处理。
还有批与流的边界:Kettle 本质是批处理,一次转换处理一批行。所谓「近实时」是靠缩短调度间隔(如每分钟一次)近似出来的,并非真正的事件驱动。认清这点,才不会在需求评审时过度承诺。
关键代码与配置
下面这段 sql 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
-- ELT 视角:Kettle 先把原始数据落地,仓库内再做转换 INSERT INTO stg_orders (id, raw_amount, etl_day) SELECT id, amount, '${p_day}' FROM src_orders; -- 随后在仓库内完成清洗(ELT 的转换阶段) UPDATE stg_orders SET amount_cn = amount * 7.2 WHERE etl_day='${p_day}';
这段 SQL 展示了 ELT 思路:Kettle 的表输出只负责把原始行搬进暂存表,真正的汇率换算交给仓库 SQL。我们用这种方式把重计算压到列式仓库里。
<step><name>表输入</name><type>TableInput</type> <sql>SELECT * FROM stg_orders WHERE etl_day='${p_day}'</sql></step> <step><name>字段选择</name><type>SelectValues</type></step> <step><name>表输出</name><type>TableOutput</type><table>dwd_orders</table></step>
而 ETL 思路下,转换发生在写入目标之前,上面的转换在 Kettle 内就把字段裁剪干净再写出。两种模式 Kettle 都支持,区别只在「转换发生在哪一侧」。
背景
一张订单宽表要在仓库里和十二张维度表关联,团队争论是让 Kettle 做关联还是落库后做。
操作
我们做了对比:Kettle 内用「数据库查询」步骤逐行关联,和先落地再用仓库 SQL 关联。
-- 方案B:Kettle 仅落地原始,关联交给仓库 CREATE TABLE dwd_orders AS SELECT o.*, c.name, p.cat FROM stg_orders o JOIN dim_customer c ON o.cid=c.id JOIN dim_product p ON o.pid=p.id;
结果
在千万行规模下,方案 B(ELT)比 Kettle 内关联快约三倍,因为仓库的列存和并行更擅长大关联。
解读
结论不是 Kettle 弱,而是「重关联」本该交给擅长它的引擎。Kettle 负责把数据准时、可靠地搬到位,这才是它的正确定位。
变式
若维度很小(几万行),反过来让 Kettle 的「数据库查询」做关联反而更快,因为省去一次全量落库。取舍看维度体积。
常见误区与工程取舍
误区:认为 Kettle 只能做 ETL。它同样能支撑 ELT,关键是转换步骤放在哪里执行。
误区:把 Kettle 当实时引擎。它是批处理,近实时靠高频调度近似,别承诺毫秒级。
取舍:重计算给仓库/计算引擎,搬运与编排给 Kettle,各司其职最省心。
深入:ETL 与 ELT 的边界到底在哪
传统 ETL 是「先抽取、在中间层转换、再加载到目标」,转换发生在 Kettle 所在机器内存里。ELT 则是「抽取后直接把原始数据灌进目标库(通常是数据仓库),转换用目标库的 SQL 算力完成」。Kettle 两种都能做:当你把它当成转换引擎用内存算,是 ETL;当你用「表输入做抽取、表输出先落库、再执行 SQL 步骤做库内变换」,就偏向 ELT。选型看谁的计算资源更便宜——目标库算力强就 ELT,源端数据敏感不允许全量出域就 ETL。
-- ELT 模式下,Kettle 先把原始落库,再用目标库 SQL 在库内完成清洗(输入:原始贴源表;输出:清洗结果表) INSERT INTO dwd_orders_clean (id, amt_cny, status_cn, dt) SELECT id, amount * rate AS amt_cny, -- 汇率换算在库内做 CASE status WHEN 1 THEN '已支付' ELSE '其他' END AS status_cn, '${p_day}' AS dt FROM ods_orders_raw WHERE dt = '${p_day}';
⚠️ 常见坑(范式与定位)
- 认为 Kettle 只能做 ETL:它同样能编排 ELT,关键在步骤怎么摆。
- 在 Kettle 内存里重复实现数据库擅长的聚合:海量数据应下推库内 SQL。
- 混淆场景边界:实时低延迟 Kettle 力不从心,它不是流处理框架的替代品。
💡 关键直觉
- 算力在哪,转换就在哪:目标库强就 ELT,源数据不许出域就 ETL。
- Kettle 的定位是「编排与搬运」,不是「计算引擎」;让它做擅长的连接与流程,把重算下推。
| 范式 | 转换发生地 | 适合场景 |
|---|---|---|
| ETL | Kettle 内存 | 源数据敏感、出域受限 |
| ELT | 目标数据库 | 目标库算力强、数据量大 |