第二章:核心原理与架构
第二章:核心原理与架构
本章要回答的三个问题
-
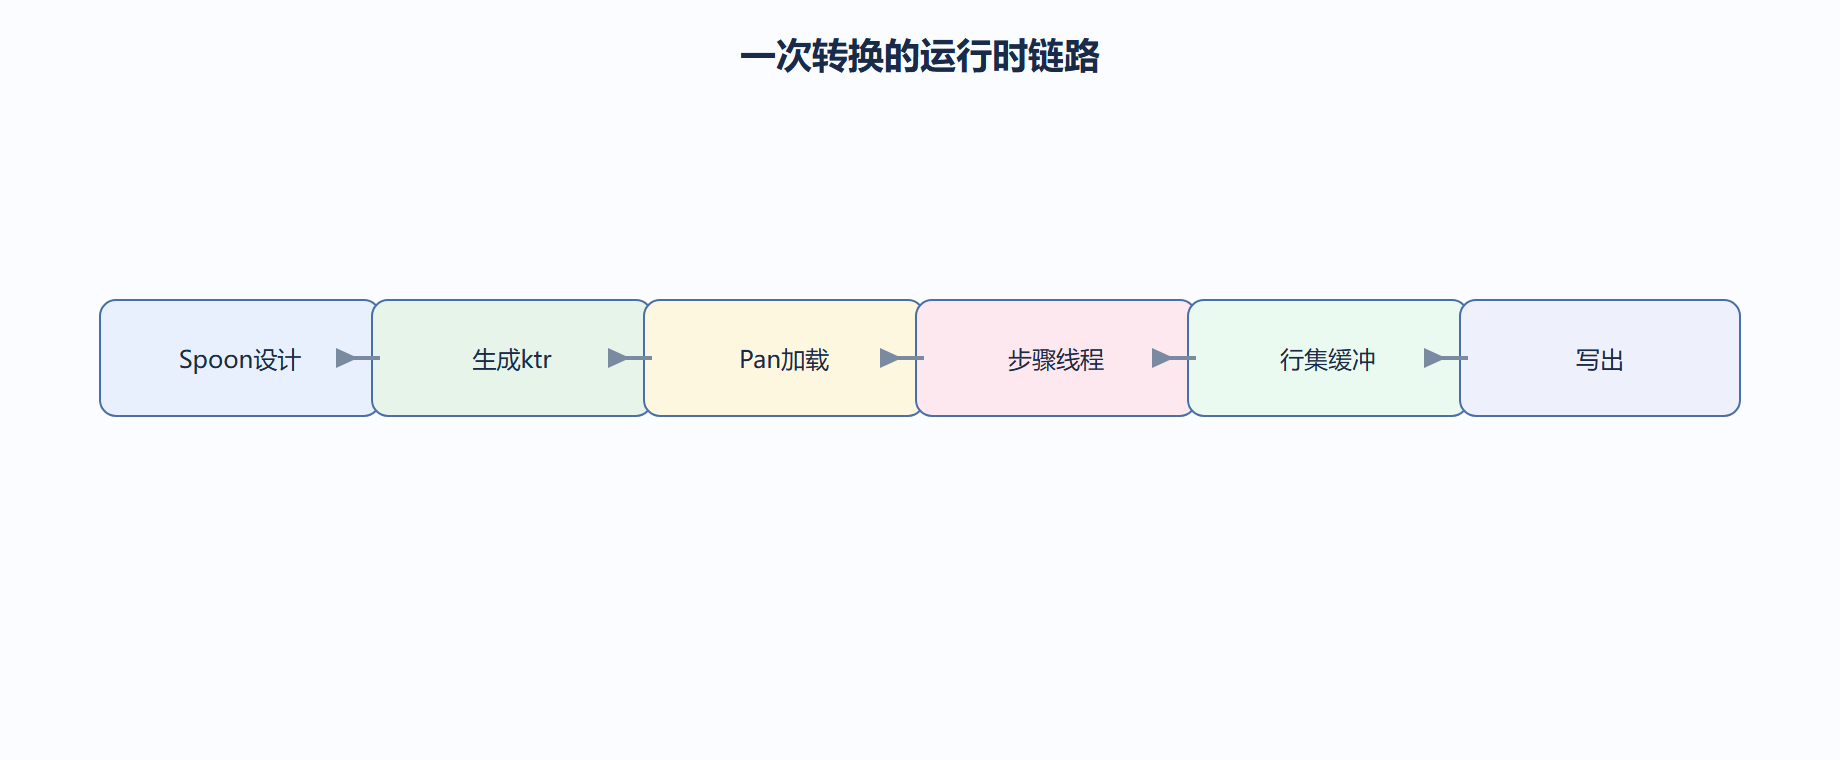
转换在内存里是怎么一行一行流动的
-
元数据除了 XML 文件还能存在哪里
-
不同数据库的类型在 Kettle 里如何对齐
为什么单独设这一章
第一张讲「是什么」,这一章讲「为什么能跑起来」。我们见过不少人会画图却调不好性能,根因是不懂步骤线程和行集缓冲,所以这章是后面性能章节的前提。
读完能解决什么
读完后你能看懂一次转换的执行链路,知道元数据存文件还是资源库各自的代价,也能解释为什么一张表读出来字段类型偶尔「变胖」。
各节分工
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 2.1 | 运行时架构 | 解释执行链路 |
| 2.2 | 元数据管理 | 选存储方式 |
| 2.3 | 数据类型系统 | 排查类型漂移 |
先决条件
建议先读完第一章,知道转换和作业的区别;同时本地装好 Spoon,能边读边点开一个现成转换对照。
往下走到哪
理解原理后,第三章会手把手带你画第一个转换,那时「步骤线程」这些东西会变成具体操作。
本章常见误区
误区一:以为转换是「一条 SQL 跑到底」。实际 Kettle 默认逐行(或按批)流过步骤,理解行集与缓冲队列,才能解释为什么某些写法在数据库里快、在 Kettle 里慢。
误区二:忽视元数据除了 .ktr/.kjb 文件还能存在数据库资源库里。小团队用文件即可,多团队协同时要早做资源库选型决策,否则后期迁移成本极高。
误区三:认为数据类型在源与目标间自动无损转换。跨数据库、跨文件时类型与字符集必须显式对齐,否则中文乱码、精度丢失会在下游才爆发。
与邻章边界
第二章讲「原理与结构」,但性能调优的具体手段在第六章,连接各类数据源在第五章,画转换在第三章。原理是「知道为什么会这样」,操作是「知道怎么配」,二者配合,调优才不会南辕北辙。
速查清单
- 转换执行引擎:逐行流过步骤,步骤间通过行集缓冲
- 元数据载体:文件(XML)或资源库(数据库)
- 类型系统:Kettle 内部类型到各数据库类型的映射表要查
- 并行度:步骤可设副本数,但要警惕有状态步骤并行出错
- 变量作用域:父作业变量可下传子转换
本章能产出的能力
读完你能解释一次转换如何在内存里逐行流动、元数据还能存在哪里、跨源类型怎样对齐——这些认知是后面性能调优与排错的前提,也是判断「该不该并行」「该不该下推 SQL」的依据。
为什么这一章不能跳过
不学原理直接调优,就像蒙着眼睛调车:你看到「慢」,却不知道是行集缓冲撑爆了内存,还是排序步骤在等全量到齐。我们见过有人给转换疯狂加并行副本,结果排序步骤并行后数据错乱——根因就是没理解运行时架构。原理是「知道为什么」,操作是「知道怎么配」,二者缺一不可。
本章最小上手练习
在转换里放一个「生成行」步骤和一个「写日志」步骤,预览时观察行集如何在两者之间流动;再故意加一个「排序」步骤,看预览为何要等全部数据到齐。亲手感受「流式」与「阻塞式」的差异,比读十遍概念都牢。
自测:你真的懂了吗
- 能否解释一次转换如何在内存里逐行流动
- 能否说清元数据除了 .ktr 文件还能存在哪里
- 能否讲出跨源类型对齐要在哪个环节完成
本章在你项目里的落点
把本章用起来,第一件事是用 Pan 在命令行跑通你已有的转换、用 Kitchen 跑通作业,确认生产入口与 Spoon 不同。第二件事是画转换前先问「这段该用转换还是作业」,把控制逻辑坚决留在作业里。做完这两件,你就避开了新手最容易踩的「混用」大坑。