2.1 Kettle运行时架构
2.1 Kettle运行时架构
一次「点运行」背后发生了什么
本篇是第 2 章第 1 节,处在原理章的开头,承接第 1 章的组件认知,向下为性能优化埋下伏笔。
当你在 Spoon 里点下运行,Kettle 先把 .ktr 解析成一组「步骤」对象和它们之间的「跳」。每个步骤会被分配自己的线程,步骤之间用「行集 RowSet」——一段内存里的队列——来传递数据。这就是所谓「流水线」:上一步还在处理第 N 批,下一步已经开始处理第 N-1 批。
行集是有上限的。我们第一次调优就是卡在这里:源端读得太快,行集被塞满,上游线程阻塞等下游消费,于是整体吞吐被最短的木板限制。后来把「排序」「去重」这类吃内存的步骤并行度调低,反而更快,因为行集压力小了。
转换引擎是单进程多线程模型,所有步骤线程共享同一个 JVM 堆。这意味着隔离性差:一个步骤 OOM 会拖垮整次转换。我们在大作业里会给 Pan 单独分配机器,避免和别的任务抢内存。这也是为什么生产部署要把 Kettle 放进独立容器。
作业和转换的运行时不同:作业是单线程顺序或按依赖执行「作业条目」,每个条目可能启动一个子进程(比如调 Pan 跑转换)。所以作业本身轻,重活在它派生的转换里。我们排错时先看作业日志定位卡在哪一步条目,再进转换看步骤线程。
Carte 把这套模型延伸到远程:主节点把转换拆成「从站」分发到多个 Carte,每个从站跑一部分步骤,结果再汇合。理解这个,才能看懂第七章的集群。我们建议先吃透单机多线程,再碰集群,否则日志会看得一头雾水。
关键代码与配置
下面这段 bash 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
# 限制 Pan 的堆内存,避免一个步骤拖垮整机 export PENTAHO_DI_JAVA_OPTIONS="-Xmx4g -Xms2g" pan.sh /file:big_load.ktr -level:Detailed # Detailed 日志会打印每个步骤的输入输出行数,便于发现行集阻塞
JVM 参数直接决定行集能撑多大。我们给生产 Pan 固定 4G 堆,并在监控里看「缓存行数」指标,超过阈值就预警。
<step> <name>排序</name><type>SortRows</type> <sort_size>1000000</sort_size> <!-- 内存中可排的行数 --> </step> <step> <name>分组</name><type>GroupBy</type> </step>
排序与分组这类步骤需要先把数据攒进内存或溢写到磁盘,sort_size 控制阈值。我们设太小会频繁落盘变慢,设太大又怕 OOM,这是典型的内存与速度的权衡。
背景
一个转换源端是高速 Kafka 落地表,下游是慢速 HTTP 写出,整体速率卡在每秒几百行。
操作
我们打开行集监控,发现「表输入」产出远大于「HTTP 写出」消费,行集常满。
# 查看步骤吞吐量 pan.sh /file:slow.ktr -level:Rowset 2>&1 | grep 'lines read/write' # 输出显示 表输入 50k/s,HTTP写出 300/s
结果
确认瓶颈在写出端而不是转换逻辑,于是把单线程写出改成批量聚合后分批,速率提到 3k/s。
解读
根因是流水线被最慢步骤阻塞,而非 Kettle 慢。看懂行集机制让我们没去无谓地加机器,而是改写出策略。
变式
若源端也能削峰,可在源端「表输入」加 LIMIT 分批或限速,使上下游节奏匹配,行集水位平稳。
常见误区与工程取舍
误区:认为加机器总能变快。单机多线程下,瓶颈常在行集和最短步骤,先定位再扩。
误区:把所有步骤并行度拉满。并行度越高行集越多,内存压力越大,适得其反。
取舍:步骤线程数默认即可,只在明确瓶颈处微调,且每次只改一个变量做对照。
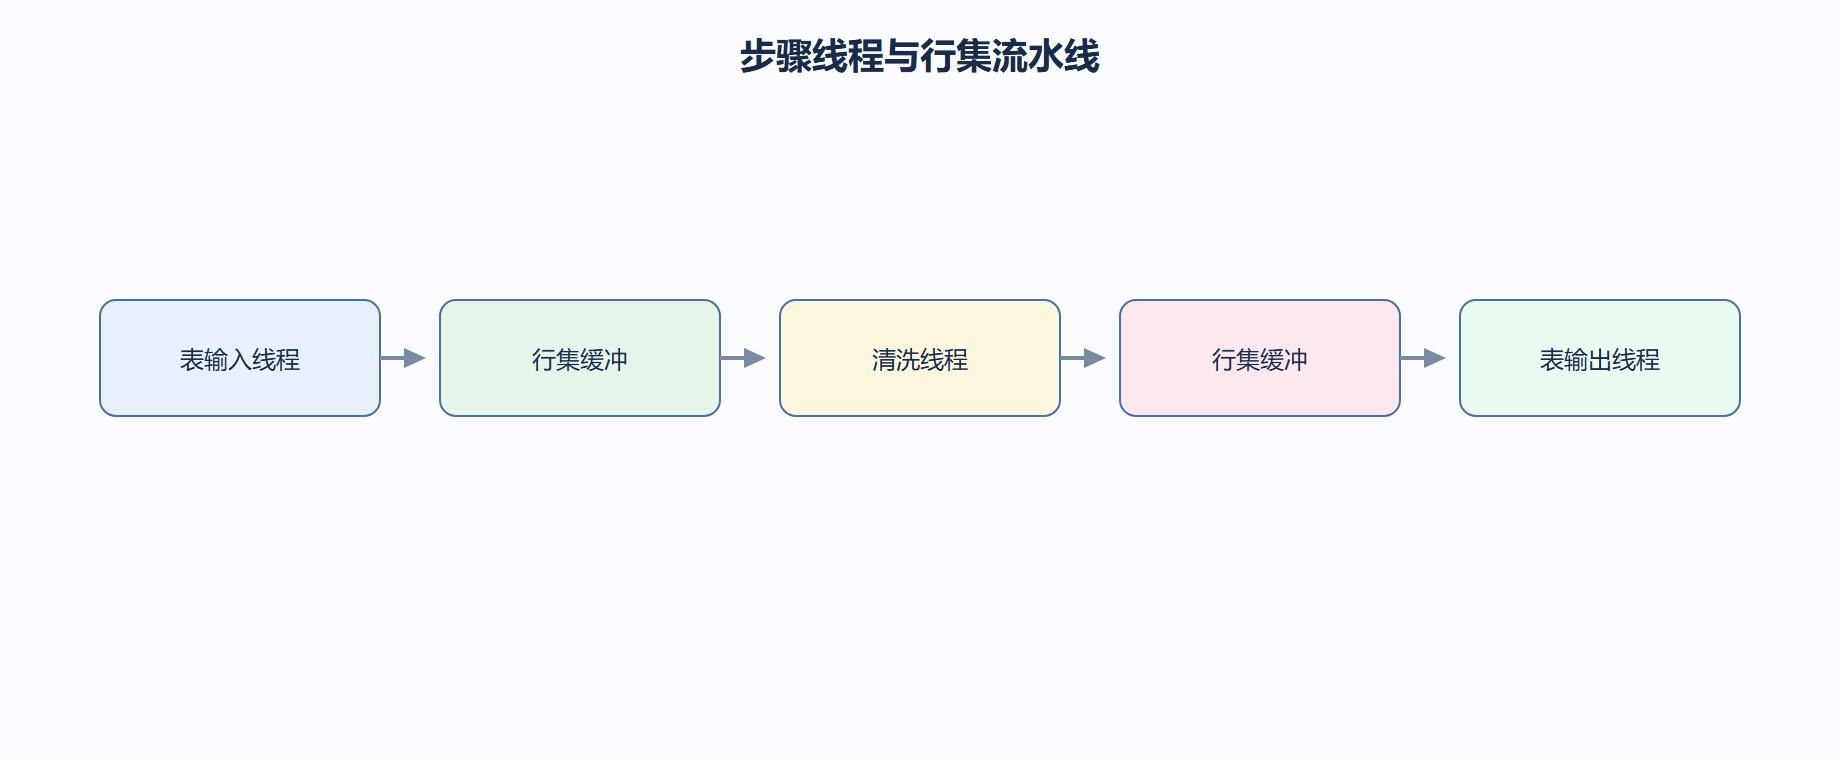
深入:一次转换在内存里怎么跑
Kettle 的转换不是「一条 SQL 跑到底」,而是数据以行为单位,从一个步骤经 hop 流向下一个步骤,步骤之间用「行集」做缓冲。每个步骤有独立的输入行集与输出行集,引擎按可用数据驱动各步骤并发执行——哪个步骤的输入行集里有数据,它就处理,处理完放进自己的输出行集。这种行级流水线意味着:上游慢不会阻塞下游无限等待(受行集容量限制),但也意味着你不能假设「下游一定看到上游全部数据后再开始」。
<step> <name>排序</name> <type>SortRows</type> <sort_fields> <field><name>create_time</name><ascending>Y</ascending></field> </sort_fields> </step> <!-- 排序/分组/去重这类步骤必须等「上游全部到齐」才能出结果,会打破行级流式,是性能与内存的关键拐点 -->
⚠️ 常见坑(运行时架构)
- 误以为转换是单线程顺序执行:实际按行集驱动并发,有状态步骤并行会错乱。
- 忽视排序/分组步骤的「全量到齐」特性:它们会囤积行集,内存压力陡增。
- 以为步骤越多越快:每多一个 hop 都有行集缓冲开销,无谓步骤只增不减。
💡 关键直觉
- 行级流水让转换「边读边算」,但遇到排序/分组这类「要等全部」的步骤,流水线退化成批处理。
- 调优第一问:我的瓶颈步骤是流式的还是阻塞式的?阻塞式才需要重点关照内存。
| 步骤类型 | 行为 | 资源特征 |
|---|---|---|
| 流式(过滤/映射) | 来一行算一行 | 低内存、可并行 |
| 阻塞式(排序/分组) | 等全部到齐 | 高内存、慎用并行 |
工程实录:定位一个阻塞式瓶颈
一条转换整体慢,但每个步骤单独看都不慢。
导出步骤指标,发现「排序」步骤读/写行数悬殊,确认它在等全量到齐。
<step><name>排序</name><type>SortRows</type> <sort_fields><field><name>create_time</name></field></sort_fields> </step> <!-- 排序必须等上游全部到齐才出结果,是行级流水的拐点 -->
把排序下推到源端 SQL 的 ORDER BY,转换恢复流式,提速明显。
阻塞式步骤打破流水线,能下推就别在内存等。
必须内存排序时,给它单独更大的行集与堆,避免拖累全局。
参数与阈值速查
| 步骤类型 | 行为 | 资源 |
|---|---|---|
| 流式 | 来一行算一行 | 低内存 |
| 阻塞式 | 等全量到齐 | 高内存 |