4.3 错误处理与重试机制
4.3 错误处理与重试机制
出事了,作业该怎么体面收场
本篇是第 4 章第 3 节,也是作业章收尾,讲可靠性设计,是把管道从「能跑」变「敢跑」的关键。
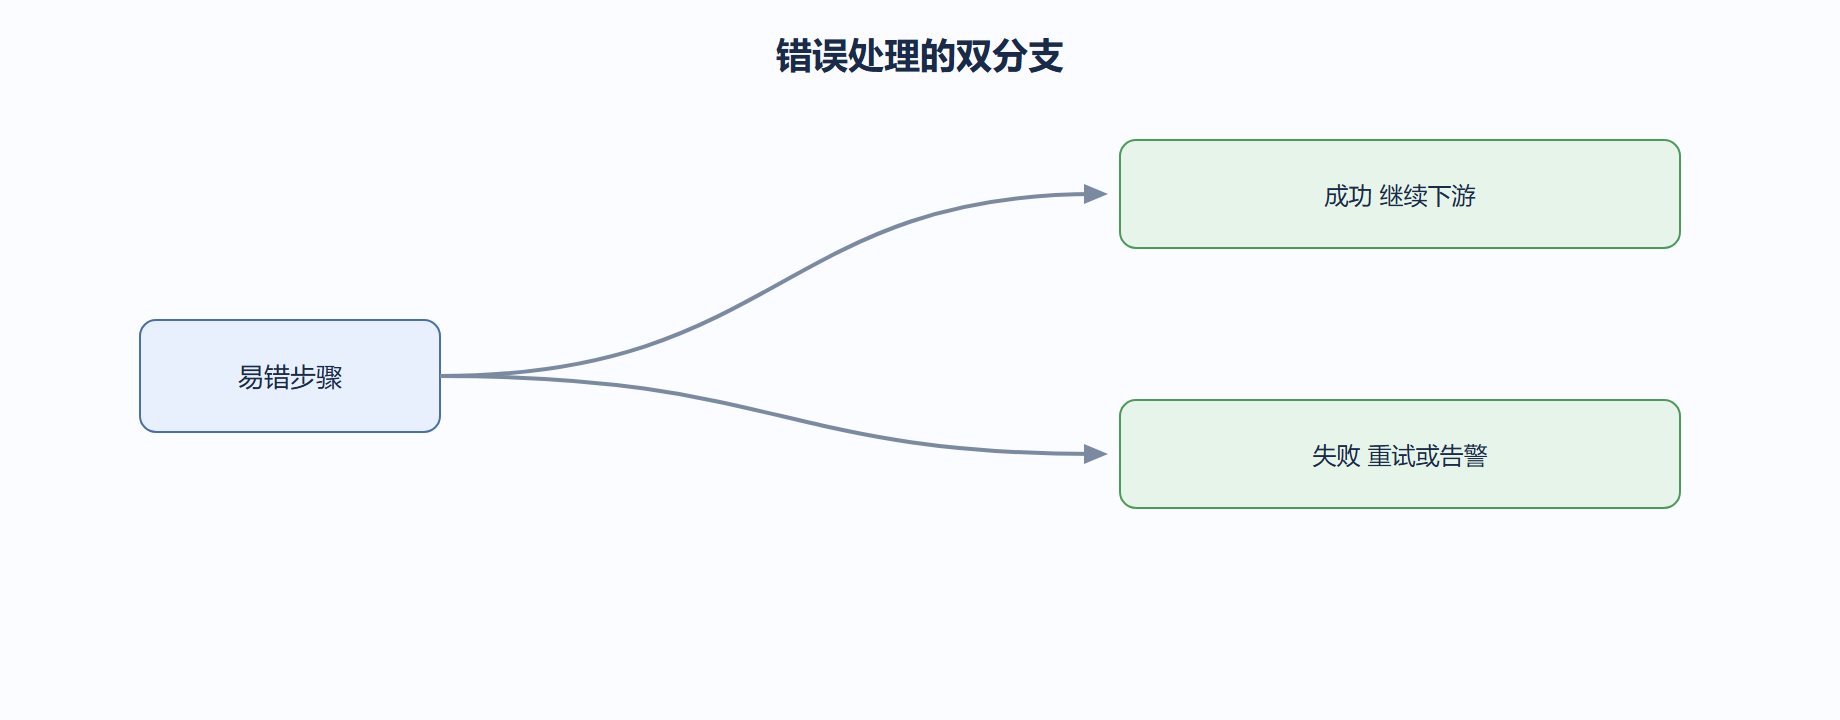
作业的连接支持「成功」「失败」「无条件」三种条件。我们给每个可能出错的转换条目都连一条失败分支,指向「发送邮件」或「写错误日志」,保证错误可见。看不见的失败比失败更可怕。
重试靠「检查点」和循环实现。简单场景我们在作业里用「失败→等待→再跑一次」的三段式;复杂场景用 Carte 的 Job 重试配置。我们对网络类抖动(如接口超时)设两次重试,对数据类错误(如字段非法)则不重试,直接告警,因为重试也没用。
区分「可重试错误」和「不可重试错误」是核心判断力。我们归纳:瞬时故障(连接闪断、锁等待)值得重试;永久故障(数据类型错、业务逻辑错)重试只会浪费时间并可能放大损害。这个分类写进了团队手册。
「中止作业」条目用于在严重错误时干净停下,避免半截数据污染下游。我们核对类步骤发现金额不平就主动中止,而不是带着错数继续,下游反而更安全。
还要有「补偿」意识:作业跑了一半失败,已写入的部分怎么办。我们对可重跑的作业要求幂等(见 4.2 的检查分区),重跑前先清理,使失败重来不留脏痕迹。补偿设计是作业可靠性里最容易被忽略的一环。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<connection><from>抽取</from><to>汇总</to><condition>success</condition></connection> <connection><from>抽取</from><to>告警</to><condition>failure</condition></connection> <entry><name>告警</name><type>MAIL</type><subject>抽取失败</subject></entry>
成功进汇总、失败进告警,是每条数据链必有的双分支。我们评审作业第一眼看有没有失败分支。
# 4.3 错误处理与重试机制 for i in 1 2 3; do curl -s --max-time 30 $API && break sleep 5 已取得 echo "第 $i 次重试" done
瞬时故障用有限次重试吸收。我们设上限 3 次避免死循环,且只在网络类步骤用,数据错误不进这个循环。
背景
某作业因目标表锁等待失败,被外部调度无限重试,每次都插入一份,结果重复数据翻倍。
操作
改为有限重试且每次重跑前先「检查分区并清理」,并区分锁等待(可重试)与数据错(不可重试)。
<connection><from>抽取</from><to>清理</to><condition>failure</condition></connection> <entry><name>清理</name><type>SQL</type><sql>TRUNCATE dwd_orders_${p_day}</sql></entry>
结果
重试前清空当日分区,重复数据消失,且锁等待类的瞬时故障仍能被吸收。
解读
根因是缺少幂等补偿。重试若不改写已落数据,就必须先清后写;不可重试错误更要果断告警而非硬试。
变式
更优是改用「插入更新」或按主键去重写,使重跑天然幂等,不必依赖先清,但代价是写入更慢,按量级权衡。
常见误区与工程取舍
误区:失败不告警。每个易错条目都要有 failure 分支。
误区:所有错误都重试。瞬时故障才重试,永久故障直接告警。
取舍:重试必配幂等补偿(先清后写或主键去重),否则重跑成灾难。
回到工程现场,我们处理 4.3 错误处理与重试机制 时最忌讳只看单点性能而忽略端到端链路。4.3 错误处理与重试机制 的真实代价往往藏在步骤之间的缓冲与序列化里,而不是某一步骤本身。我们在多次压测中验证过这一点,并把对应的监控指标固化进自动化巡检脚本。当数据量翻倍时,瓶颈位置常会转移,因此不要把一次观测结论当成永久真理。
深入:错误兜底与重试怎么配
生产作业必须假设「任何环节都可能临时失败」。Kettle 在作业条目级提供错误兜底:可设「忽略错误」让单条失败不中断整条;可设「重试次数」与「重试间隔」,应对网络抖动、库锁等瞬时故障;可把失败 hop 连到「发送邮件」做即时告警。转换内部则用「错误处理」步骤捕获单行错误,把脏数据路由到弃用表而非整批崩。原则是:瞬时故障自动重试,业务错误隔离记录,结构性错误才真正中断并告警。
<entry> <name>抽数转换</name> <type>TRANS</type> <transname>orders_sync</transname> <retry_count>3</retry_count> <!-- 瞬时故障重试 3 次 --> <retry_interval>60000</retry_interval> <!-- 每次间隔 60 秒 --> <fail_on_error>Y</fail_on_error> <!-- 重试仍失败则走失败分支告警 --> </entry> <!-- 条目级兜底(输入:运行上下文;输出:成功则继续,失败则邮件告警) -->
⚠️ 常见坑(错误处理)
- 没有任何兜底:一次抖动让整夜任务白跑,早上才发现。
- 重试不设上限/间隔:死循环式重试把源库打挂。
- 脏数据整批丢弃:应路由到错误表留痕,而非默默丢弃难追溯。
💡 关键直觉
- 重试只治「瞬时病」(网络、锁),不治「结构病」(字段不对),误诊会越重试越糟。
- 错误要「可观测」:无论重试还是隔离,最终都要有日志/告警让人看见。
| 故障类型 | 策略 | 示例 |
|---|---|---|
| 瞬时 | 重试 | 网络抖动 |
| 业务 | 隔离记录 | 脏数据行 |
| 结构 | 中断告警 | 表结构变更 |
工程实录:给关键条目加重试
一次网络抖动让整夜任务白跑,早上才发现。
为抽数转换条目配重试次数与间隔,仍失败才告警。
<entry><name>抽数</name><type>TRANS</type> <retry_count>3</retry_count> <retry_interval>60000</retry_interval> <fail_on_error>Y</fail_on_error> </entry>
瞬时故障自动恢复,不再半夜被叫醒。
重试只治瞬时病,结构病要中断告警。
脏数据行用错误处理步骤路由到弃用表留痕。
参数与阈值速查
| 故障 | 策略 | 示例 |
|---|---|---|
| 瞬时 | 重试 | 网络抖动 |
| 业务 | 隔离 | 脏数据 |
| 结构 | 中断 | 表结构变 |