第五章:数据连接与管理
第五章:数据连接与管理
本章要回答的三个问题
-
数据库连接怎么统一管理才不乱
-
除了数据库还能连哪些文件系统
-
如何用 API 把接口数据拉进 Kettle
为什么单独设这一章
前面几章默认你已连好数据源。这一章把这些「连接」本身讲清楚——因为连错库、连错编码是生产故障的头号来源,值得单独成章。
读完能解决什么
读完后你能统一管理数据库连接、读写多种文件系统、并把 REST 接口数据稳稳接进管道,不再被连接问题卡住。
各节分工
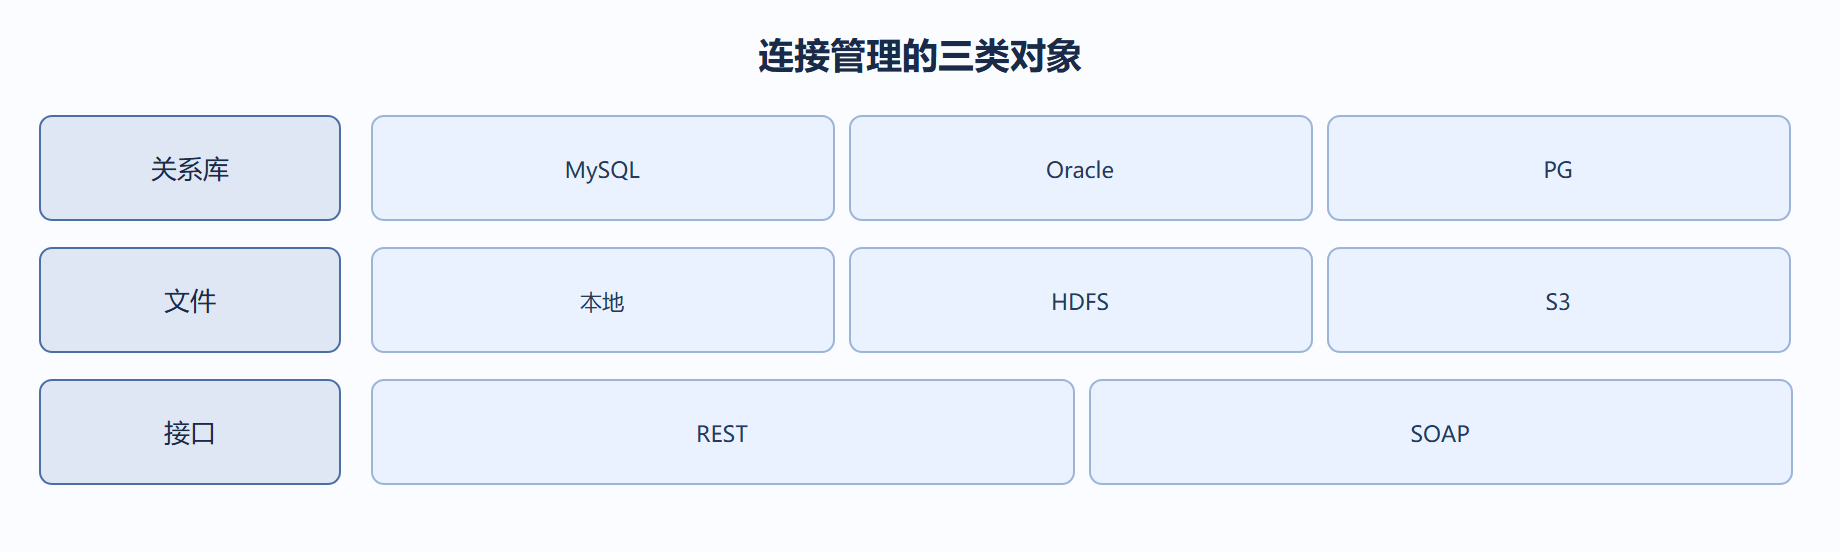
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 5.1 | 数据库连接 | 统一连接管理 |
| 5.2 | 文件系统 | 读写文件 |
| 5.3 | Web与API | 接接口数据 |
先决条件
需要第一章的连接概念;最好手头有一个可连的测试库和一个示例接口,跟着配一遍。
往下走到哪
连接搞定,第六章的性能优化才有具体对象可调;第七章的集群也建立在稳定连接之上。
本章常见误区
误区一:把数据库密码明文写死在连接里。生产环境必须用变量或秘钥管理注入,否则凭据随代码库泄露。
误区二:忽略字符集与驱动版本。同一个 .ktr 在开发库正常、到生产库乱码,多半是连接字符集或 JDBC 驱动版本不一致。
误区三:文件系统路径用绝对硬编码。换机器就失效,应该用变量或相对路径,并在作业启动时注入根目录。
与邻章边界
第五章只讲「怎么连上数据源」,不深入「连上之后怎么清洗」(第三章)也不讲「连不上的性能瓶颈」(第六章)。连接是地基,地基稳了后面的清洗与优化才有意义。
速查清单
- 数据库连接:JDBC 驱动、URL、字符集、连接池参数
- 文件系统:文本/Excel/CSV 输入输出的编码与分隔符
- Web/API:HTTP 步骤、认证头、分页与限流
- 凭据:用变量
${p_db_pwd}注入,禁止明文 - 共享连接:在连接库里集中管理,多个转换复用
本章能产出的能力
读完你能为数据库、文件、Web 接口三类数据源分别建立稳定连接,并掌握字符集、驱动版本、凭据管理这些高频踩坑点。你将能独立排查「连得上但读出来是乱码」「本地能跑服务器报错」这类连接层问题。
为什么这一章不能跳过
连接层是 ETL 故障的最高发地带:字符集不一致导致中文乱码、驱动版本错配导致生产才报错、密码明文随代码库泄露。这些坑一旦踩中,下游全部被污染。本章把连接层一次性讲透,是后面所有清洗的前提。
本章最小上手练习
建一个数据库连接,显式指定 UTF-8 与驱动版本,用变量注入密码;再建一个文本文件连接与一个 HTTP 连接,分别预览到数据。三种连接的「编码/凭据/分页」三件套亲手配一遍,以后遇到连接问题你就有排查地图。
自测:你真的懂了吗
- 能否为三类数据源分别建立稳定连接
- 能否说清字符集、驱动版本、凭据管理这三个高频坑
- 能否解释共享连接为什么比每文件各写一份更好
本章在你项目里的落点
落地第一件事:把数据库连接里的密码改成变量注入,并显式写死 UTF-8 与驱动版本,消除最常见的乱码与协议错配。第二件事:把三个连接(库/文件/API)各建一份共享连接,团队所有转换引用同一份,改一次全局生效。做完这两件,连接层就稳了,后面所有清洗都不必再为连不上背锅。
补充:连接层稳定后,建议把三类共享连接(库/文件/API)统一登记在团队的「连接清单」里,标注负责人与凭据来源,避免某人离职后连接成了无人认领的黑盒。