7.1 Kettle集群与负载均衡
7.1 Kettle集群与负载均衡
一台机器忙不过来,就多叫几台
本篇是第 7 章第 1 节,承接性能章,讲当单机优化到顶仍不够时,如何用集群把负载摊开。
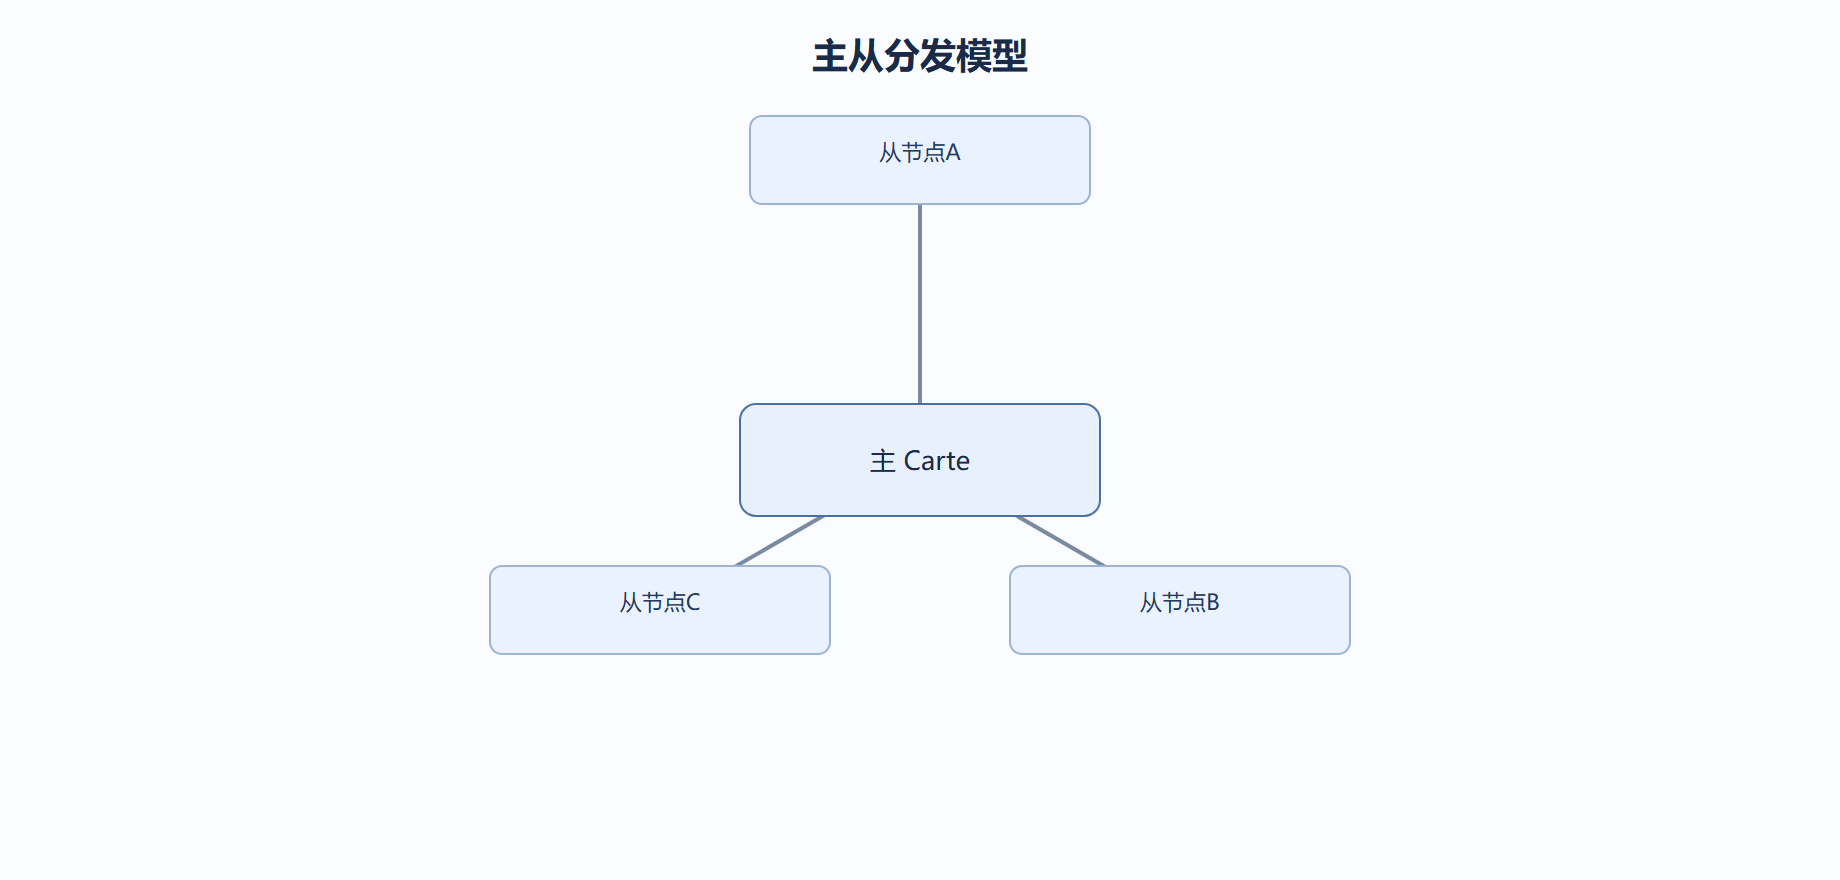
Kettle 集群由「主 Carte」和多个「从 Carte」组成。主节点把转换拆成分片,分发给从节点并行执行,结果再汇合。我们处理亿级日志时用四节点集群,吞吐近似线性提升,但要注意不是所有转换都适合分片。
分片依赖「分区方式」:按某个关键字(如用户 ID 取模)把行路由到不同从节点。这就要求处理逻辑对分片独立——不能有跨分片的全局排序、全局去重,否则分片失去意义。我们设计时就避开全局阻塞步骤。
集群的收益有边界。网络搬运分片本身有开销,若单转换逻辑很轻,分片反而因协调变慢。我们只在单转换预计超十分钟、且能干净分片时才上集群,小转换留在单机更划算。
Carte 本身是无状态执行容器,挂了可由调度系统重启,主节点重派。我们给每个 Carte 配健康检查,异常即剔除,避免任务卡死在坏节点。集群的容错靠外部调度补,不是 Carte 自带。
集群配置要统一:各节点 Kettle 版本、驱动、kettle.properties 必须一致,否则分片在 A 节点能跑、B 节点报类找不到。我们用同一镜像启动所有 Carte,从根源消除环境漂移。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<cluster> <name>etl_cluster</name> <master><carte>master:8080</carte></master> <slaves><carte>slave-a:8080</carte><carte>slave-b:8080</carte></slaves> </cluster> <step><name>表输入</name><type>TableInput</type> <cluster_schema>etl_cluster</cluster_schema> </step>
转换的步骤指定集群 schema 后,会在各从节点并行执行。我们只在能分片的步骤挂集群,其余留主节点。
# slave-a / slave-b 均执行 docker run -p 8080:8080 kettle-carte:9.4 # 主节点把转换分片下发,日志汇总到主
统一镜像是集群稳定的命门。我们所有 Carte 来自同一构建,杜绝「我机器能跑」这类环境差异。
背景
某转换上集群后,计数结果比单机多了一倍,排查发现分区键选了可空字段,null 全挤到一个节点且被重复处理。
操作
改用稳定非空的分区键(用户 ID),并在作业开头先过滤 null 行。
<step><name>分区</name><type>Clustered</type> <schema>etl_cluster</schema><key_field>user_id</key_field> </step>
结果
分片均匀,计数与单机一致,吞吐随节点数近似线性提升。
解读
根因是分区键不稳导致路由错乱。集群的前提是「分片独立且键稳定」,否则并行会放大错误。
变式
若没有天然分区键,可让「表输入」按主键范围分段、各节点领不同区间,等价分片但更可控。
常见误区与工程取舍
误区:什么转换都上集群。轻逻辑分片反慢,先估耗时与可分片性。
误区:分区键随意。必须稳定非空,否则路由错、结果错。
取舍:统一镜像启 Carte;集群容错靠外部调度,不依赖 Carte 自身。
回到工程现场,我们处理 7.1 Kettle集群与负载均衡 时最忌讳只看单点性能而忽略端到端链路。7.1 Kettle集群与负载均衡 的真实代价往往藏在步骤之间的缓冲与序列化里,而不是某一步骤本身。我们在多次压测中验证过这一点,并把对应的监控指标固化进自动化巡检脚本。当数据量翻倍时,瓶颈位置常会转移,因此不要把一次观测结论当成永久真理。
深入:集群怎么把活分出去
Kettle 集群由一个主 Carte 与若干从 Carte 组成。主节点把转换拆成「分区」,按分片键(如按 id 取模)把不同数据块分发到不同从节点并行执行,适合无状态、可独立分片的数据流。有状态步骤(排序、分组、去重)不能简单并行,否则结果错乱——这类步骤要么单节点跑,要么用数据库层做分片聚合。集群引入网络与一致性成本,所以只在「单机已优化到顶仍不够快」时才上,而不是作为第一选择。
<cluster> <name>etl_cluster</name> <base_port>8080</base_port> <slaves> <slave><name>slave1</name><hostname>node1</hostname></slave> <slave><name>slave2</name><hostname>node2</hostname></slave> </slaves> </cluster> <!-- 转换步骤上勾选「集群」后,按分区字段把数据分片到各 slave 并行(输入:全量行集;输出:各节点分片结果合并) -->
⚠️ 常见坑(集群)
- 把阻塞式步骤并行:排序/分组并行结果错乱。
- 过早上集群:单机未优化就堆机器,成本高性能没起来。
- 忽视网络开销:分片与合并的跨节点传输可能抵消并行收益。
💡 关键直觉
- 集群治「单机能扛但想更快」,不治「单步骤算法低效」。
- 分片键选得好,并行才线性加速;选不好数据倾斜,一个节点拖死全体。
| 场景 | 是否适合集群 |
|---|---|
| 无状态可分片 | 适合 |
| 排序/分组 | 不适合直接并行 |
| 单步骤算法慢 | 不适合 |
工程实录:集群分片加速
单转换已优化到顶,仍跟不上数据增长。
搭主从 Carte,转换勾选集群,按 id 取模分片并行。
<cluster><name>etl_cluster</name><base_port>8080</base_port> <slaves><slave><name>s1</name><hostname>node1</hostname></slave> <slave><name>s2</name><hostname>node2</hostname></slave></slaves> </cluster>
无状态数据流近线性加速。
集群治「能扛但想更快」,不治「单步算法慢」。
分片键选不好会数据倾斜,一个节点拖死全体。
参数与阈值速查
| 场景 | 是否适合集群 |
|---|---|
| 无状态分片 | 适合 |
| 排序/分组 | 不适合 |
| 单步算法慢 | 不适合 |