第七章:高级特性与扩展
第七章:高级特性与扩展
本章要回答的三个问题
-
数据量大到单机扛不住怎么扩
-
多团队共用如何做权限隔离
-
怎样让转换进版本管理和流水线
为什么单独设这一章
基础功能会用了,这一章讲的是「上规模、上组织」才需要的能力:集群、安全、CI/CD。它们不是炫技,而是团队从个人脚本走向生产平台的必经之路。
读完能解决什么
读完后你能规划 Kettle 集群分担负载、配置账号与权限隔离、并把元数据接入版本库与持续集成,支撑多人协作。
各节分工
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 7.1 | 集群与负载 | 横向扩展 |
| 7.2 | 安全与权限 | 隔离管控 |
| 7.3 | 版本与CI/CD | 协作交付 |
先决条件
需要前五章的运行与连接基础,尤其第六章的性能概念;集群部分建议先在测试机跑通再上生产。
往下走到哪
第八章会把 Kettle 放进更大的生态(大数据、云、BI),本章的能力是它对外衔接的内部地基。
本章常见误区
误区一:认为集群能解决一切性能问题。集群解决的是「单机能扛但想更快」的横向扩展,对单步骤算法低效无能为力,且引入网络与一致性成本。
误区二:把权限管理想成「给每个人全权限」。多团队共用一套 Kettle 时,必须按角色隔离连接与作业,否则一个误操作能拖垮他人管道。
误区三:元数据不进版本库。.ktr/.kjb 是文本 XML,不纳入 Git 就会丢失变更历史,出了问题无法回滚。
与邻章边界
第七章迈向规模化与组织化,依赖前三章的构件与第四章的编排基础。集群与权限是「从个人脚本到生产平台」的必经门槛,而持续集成(CI/CD)又和第九章的部署监控衔接。
速查清单
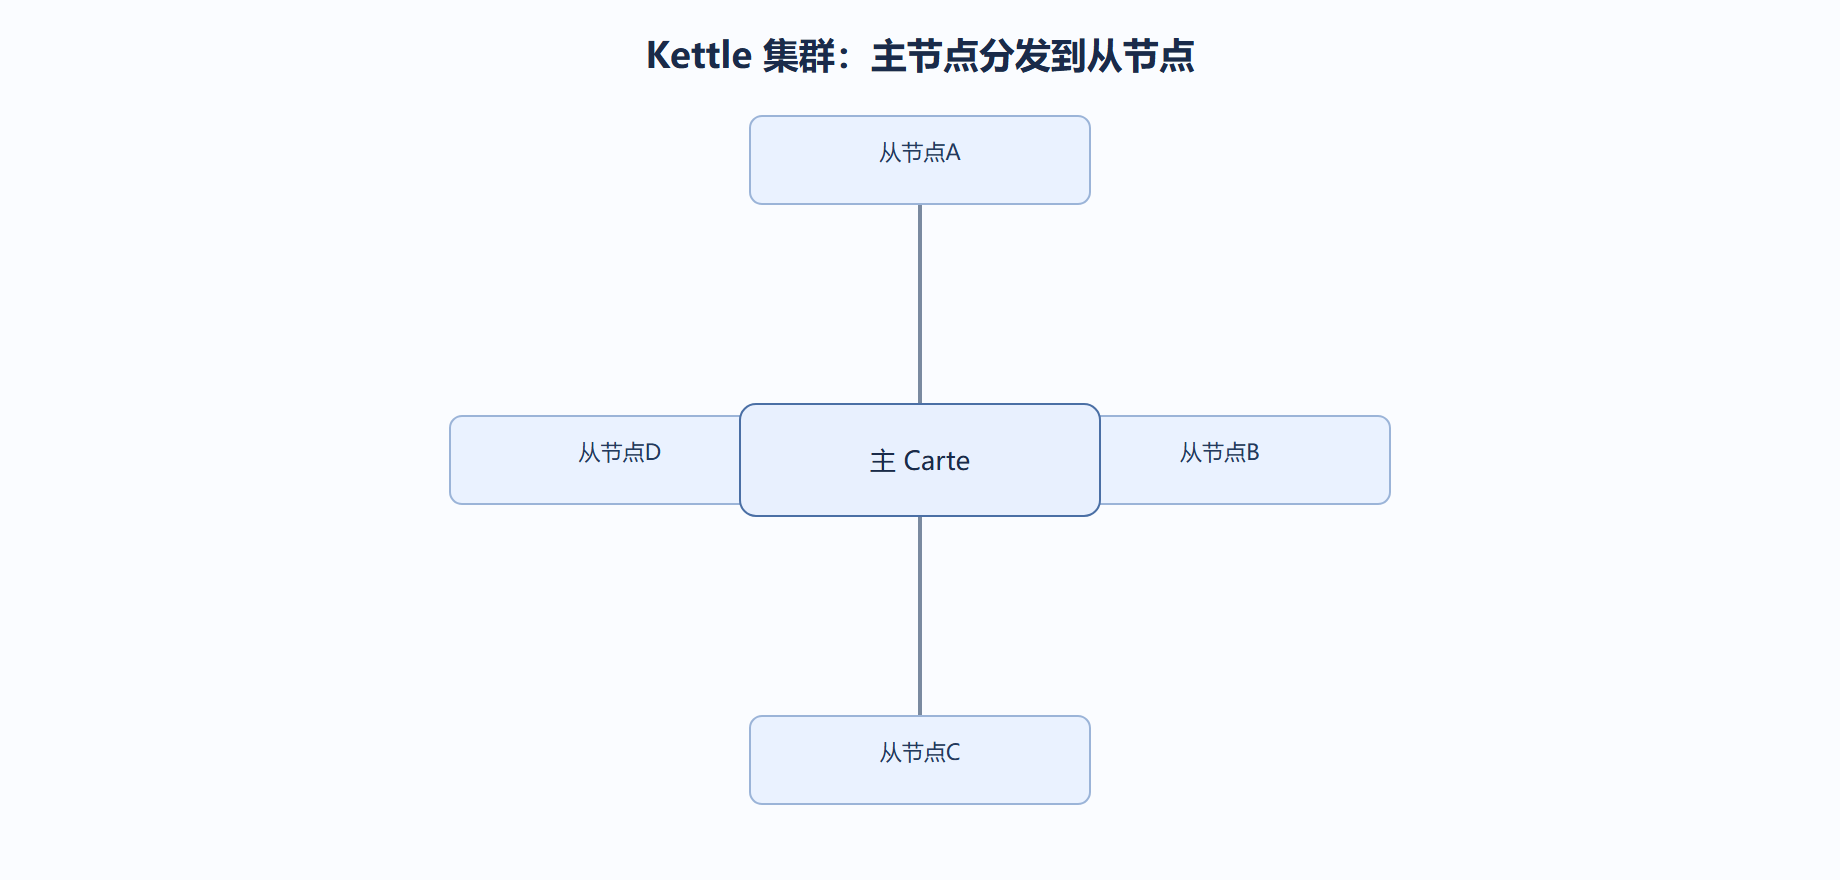
- 集群:Carte 从节点 + 主节点分发,适合无状态可并行转换
- 权限:连接、作业、资源库按角色授权
- 版本控制:
.ktr/.kjb纳入 Git,做 code review - CI/CD:提交即触发校验、单元测试、自动部署
- 一致性:集群下避免步骤依赖全局可变状态
本章能产出的能力
读完你能把单机的转换扩展到集群横向加速,能为多团队配置权限隔离,并能把元数据接入版本库与持续集成。这三点合起来,是把「我的脚本」变成「团队的平台」的关键一跃。
为什么这一章不能跳过
个人脚本走到生产平台,差的就是集群、权限、版本控制这三道关。没有它们,多人共用会互相踩脚,元数据改错无法回滚,单机瓶颈无法突破。本章是「我的脚本」变「团队的平台」的必经之路。
本章最小上手练习
把一份 .ktr 纳入 Git,做一次带 PR 的改动并 self-review;再尝试把一条无状态转换勾选「集群」跑在本地伪集群上,观察分片。这两个动作分别让你体验了版本控制与横向扩展的雏形。
自测:你真的懂了吗
- 能否解释集群适合什么、不适合什么
- 能否设计多团队的权限隔离方案
- 能否说出元数据进 CI/CD 带来的三重好处
本章在你项目里的落点
落地第一件事:把一份 .ktr 提交进 Git 并做一次带评审的改动,亲自体验元数据即代码。第二件事:为多人环境配置连接与作业的按角色授权,杜绝共用超级账号。这两步不动集群也能立刻提升协作安全与可维护性,是「个人脚本走向团队平台」最便宜的起点。
补充:版本控制与集群扩张往往一起出现——正因为有元数据进 Git,你才敢把转换分发到多节点并行而不怕改错无法回滚。二者是规模化的一体两面。