7.3 版本控制与CI/CD集成
7.3 版本控制与CI/CD集成
转换也是代码,该走和代码一样的流程
本篇是第 7 章第 3 节,也是高级章收尾,讲把元数据纳入工程化交付,是团队规模化的关键一跃。
我们把每个 .ktr/.kjb 当作源码进 Git,变更走 PR、做评审。这样谁改了「表输出」的 commit 一目了然,回滚用 revert。前面 2.2 提过我们因此躲过资源库迁移事故,这里落到流程上就是标准化。
CI 在每次 PR 做静态检查:YAML 里 ht_document_id 是否缺失、文件命名是否规范、有没有密码硬编码。我们用一段脚本扫改动文件,命中就拦下合并。这把低级错误挡在入库前。
CD 把合并后的元数据自动部署到对应环境:测试环境自动加载、生产环境经审批后加载。我们不让人在生产 Spoon 上手改后另存,所有变更必须经分支合并,保证生产状态可追溯、可重建。
测试也进流水线:每次合并跑一个最小转换验证连通性与行数。我们准备了一份「冒烟 .ktr」,CI 里用 Pan 跑它连测试库,失败则阻断。没有自动化测试,重构转换时心里没底。
元数据格式稳定很重要。XML 里含绝对路径、本地用户名等会变的内容会污染 diff。我们用变量替代这些、并在提交前用脚本清洗,使 diff 只反映真实逻辑变化,评审才读得动。
关键代码与配置
下面这段 bash 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
# CI 中对改动文件的静态检查(节选) for f in $(git diff --name-only HEAD^); do grep -q 'ht_document_id' "$f" || echo "缺少 id: $f" grep -q 'password=' "$f" && echo "疑似硬编码密码: $f" done
提交前扫描把缺 id、硬编码密码挡在门外。我们 CI 第一步就是它,省下大量评审精力。
# .gitlab-ci.yml 片段:合并后跑冒烟 stages: [test] smoke: stage: test script: - pan.sh /file:tests/smoke.ktr -level:Basic only: [merge_request]
冒烟转换进 CI,每次 MR 自动验证连通与行数。我们把它当单元测试,重构前先绿。
背景
运维在生成环境 Spoon 直接改了转换另存,没走 Git,结果一次发布把他的改动覆盖了,当天管道行为异常。
操作
禁止生产手改,所有变更回源到分支,CI 合并后由 CD 统一加载到生产。
# CD 发布:从 Git 取最新,加载到生产资源库/目录 git archive HEAD | tar -x -C /opt/kettle/jobs/ # 再由 Kitchen 按计划调用,状态唯一来源是 Git
结果
生产状态以 Git 为准,任何改动可追溯、可重建,覆盖事故不再发生。
解读
根因是「生产还有第二份真相」。元数据必须单源,Git 是唯一真相,手工改是失控之源。
变式
若用资源库而非文件,CD 改为导出到资源库 API,但原则不变:变更只经分支,生产不收手工写。
常见误区与工程取舍
误区:生产 Spoon 手改。必须单源,Git 是唯一真相。
误区:XML 含绝对路径。用变量替代,保持 diff 干净。
取舍:CI 做静态检查+冒烟,CD 经审批部署;改动全走 PR。
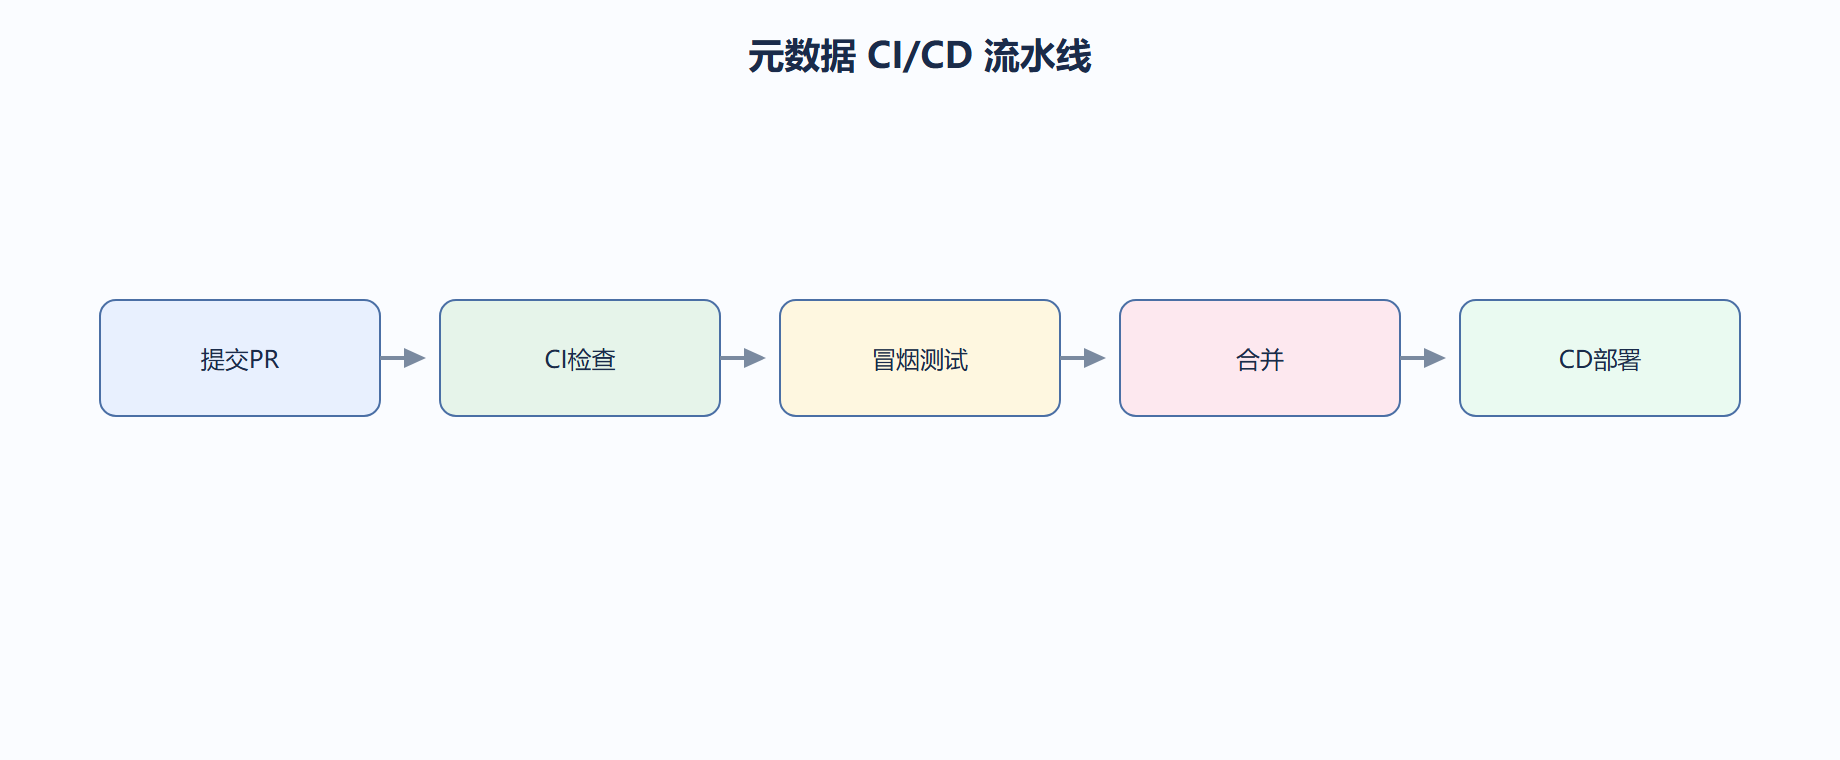
深入:元数据怎么进 CI/CD
.ktr/.kjb 是 XML 文本,天然适合进 Git。我们把它们纳入版本库,每次改动走 Pull Request,由同事做 code review——这正是把「我的脚本」变成「团队资产」的关键。CI 流水线在提交时自动跑校验(XML 合法、命名合规、变量在字典内),并可触发一个测试环境执行做冒烟。通过后由 CD 自动部署到目标环境。这样元数据有了变更历史、回滚能力与质量闸门,告别「谁改了啥全靠记忆」。
# 伪流程: git diff --name-only HEAD~1 | grep -E '\.(ktr|kjb)$' # 找出变动的元数据 python validate_kettle.py $files # 校验 XML 结构+命名+变量字典 # 校验通过才允许合并;合并后 CD 把文件同步到资源库/生产机
⚠️ 常见坑(版本控制)
- 元数据不进版本库:改错无法回滚,离职带走知识。
- 不评审直接上:坏转换直接进生产,下游遭殃。
- 变量野名:同义不同名导致参数接不上,CI 应扫描字典。
💡 关键直觉
- 元数据即代码:能 Git、能 review、能回滚,才算工程化。
- CI 的价值是把「规范」从自觉变成强制——命名、变量、结构不合格直接拦下。
| 环节 | 动作 |
|---|---|
| 提交 | Git + PR |
| 校验 | CI 静态检查 |
| 部署 | CD 自动同步 |
工程实录:CI 拦下野名变量
同义不同名导致参数接不上,运行时才爆。
提交时 CI 扫描变量是否在字典,野名直接拦下。
git diff --name-only HEAD~1 | grep -E '\.(ktr|kjb)$' python validate_kettle.py $files # 校验结构+命名+变量字典
规范从自觉变强制,坏转换进不了生产。
元数据即代码,能 review 能回滚才算工程化。
合并后 CD 自动同步到资源库。
参数与阈值速查
| 环节 | 动作 |
|---|---|
| 提交 | Git+PR |
| 校验 | CI 静态 |
| 部署 | CD 同步 |
现场口诀
元数据即代码:能进 Git、能 review、能回滚,才算工程化。CI 的价值是把规范从「自觉」变成「强制」——命名、变量字典、XML 结构不合格直接拦下,不让坏转换进生产。这套机制一旦建起,团队的 ETL 质量不再依赖个人自觉。
现场口诀(续)
把元数据纳入 CI/CD 之后,最大的隐性收益是「改动可见、可评、可回滚」:任何人提交转换都被 PR 记录,坏改动在合并前就被拦,线上问题能 git revert 秒级恢复。这把 ETL 从个人手艺变成团队工程,也是第八章规模化与第九章生产化的共同前提。