第八章:Kettle生态系统与集成
第八章:Kettle生态系统与集成
本章要回答的三个问题
-
Kettle 怎么和大数据的 Hadoop 系打通
-
云上的数据服务怎么接
-
做好的数据怎么喂给 BI 看
为什么单独设这一章
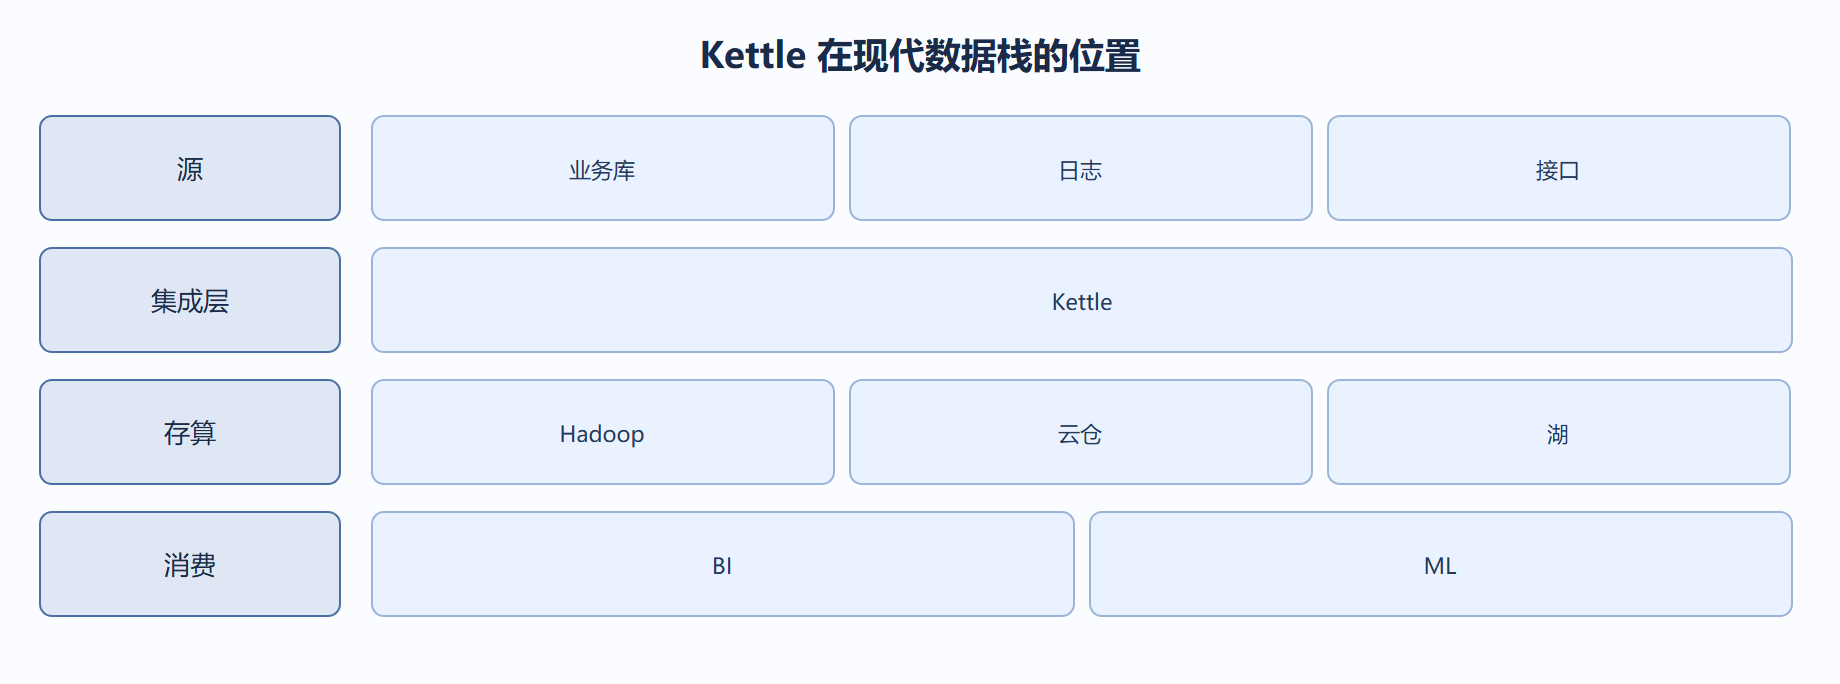
Kettle 不是孤岛。当企业已经有 Hadoop、云存储、BI 平台,它必须能嵌进去而不是另起炉灶。这一章讲对外集成,决定它在现代数据栈里的位置。
读完能解决什么
读完后你能把 Kettle 接进 Hadoop 生态、主流云数据服务,以及把结果送到 BI 工具,成为数据栈里那层灵活的集成。
各节分工
| 节 | 关注点 | 交付能力 |
|---|---|---|
| 8.1 | 大数据集成 | 接 Hadoop 生态 |
| 8.2 | 云集成 | 接云数据服务 |
| 8.3 | BI 集成 | 喂数据给可视化 |
先决条件
需要第五章的连接基础和第七章的集群概念,尤其 HDFS/S3 接入和集群分发。
往下走到哪
第九章会把这些能力落到生产部署、监控与最佳实践,完成从工具到平台的闭环。
本章常见误区
误区一:把 Kettle 当成数据栈里的孤岛。它真正的价值是「灵活的集成层」,把 Hadoop、云、BI 等不同世界的系统用统一图形语言串起来。
误区二:在 Kettle 里重复实现大数据引擎已擅长的计算。海量数据应下推到 Spark/Hive,Kettle 负责编排与搬运,而不是在内存里硬算。
误区三:BI 直连 Kettle 运行时。正确做法是 Kettle 把结果落到集市表,BI 再读集市,二者通过数据解耦而非进程耦合。
与邻章边界
第八章讲「对外集成」,但「数据怎么清洗好再出去」在第三章,「连 Hadoop/云/BI 的凭据与连接」在第五章,「结果表部署到生产」在第九章。集成是连接器,不是替代品。
速查清单
- 大数据:Hadoop File / Hive / Spark 输入输出步骤
- 云:对象存储、云数据仓库的连接与鉴权
- BI:把结果写入集市表供 BI 读取,而非直连
- 解耦:Kettle 产出数据,下游系统消费数据
- 鉴权:跨系统凭据统一由秘钥管理注入
本章能产出的能力
读完你能把 Kettle 嵌进现代数据栈:与 Hadoop 做批处理搬运、与云数据服务做弹性集成、与 BI 平台做结果对接。你将理解它该在什么环节出现、什么环节该让位给专用引擎。
为什么这一章不能跳过
把 Kettle 当成孤岛,你就浪费了它最大的价值——灵活的集成层。现代数据栈里它该把 Hadoop、云、BI 串起来,而不是自己硬算一切。不懂集成,管道就到不了「数据最终被人用起来」的终点。
本章最小上手练习
画一个转换:从业务库抽数 → 落 HDFS/云存储 → 调 Hive/云数仓做聚合 → 结果写回集市。哪怕用最小数据集跑通,你也验证了「Kettle 编排 + 专用引擎计算」的分工。
自测:你真的懂了吗
- 能否讲清 Kettle 在大数据栈里的角色定位
- 能否设计云上「原始区→清洗→集市」标准链路
- 能否解释为什么 BI 应读集市而非直连源库
本章在你项目里的落点
落地第一件事:画一条「业务库抽数 → 落 HDFS/云存储 → 调 Hive/云数仓聚合 → 写回集市」的最小链路并跑通,亲自验证 Kettle 编排 + 专用引擎计算的分工。第二件事:把 BI 指向集市而非源库,完成解耦。做完这两件,Kettle 就真正嵌进了你的现代数据栈。
落地第三件事:把云上「原始区 → 清洗 → 集市」做成标准链路模板,团队新接一个数据源时直接套用,而不是每人从零配一遍。模板化是集成效率的放大器,也是避免凭据散落的关键。