8.2 云平台数据服务集成
8.2 云平台数据服务集成
云上的数据,Kettle 也能搬
本篇是第 8 章第 2 节,讲与主流云数据服务的衔接,是上云企业的日常。
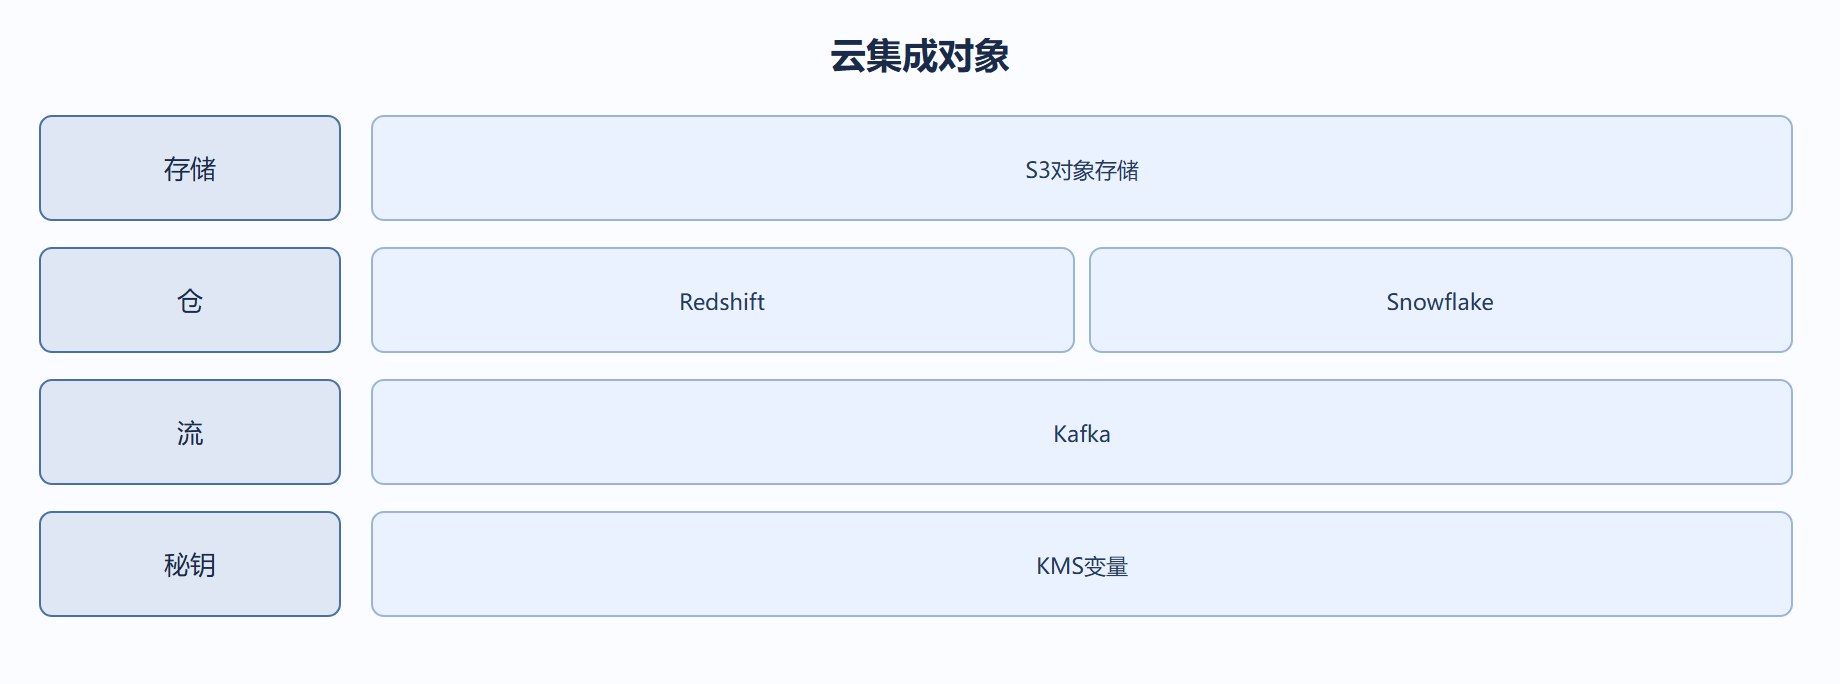
对象存储 S3 用「S3 文件输入/输出」,凭据走 AccessKey 变量。我们数据湖建立在 S3,Kettle 读取原始、写出加工结果都走它,天然适配云原生架构,且和第六章的批量加载配合做仓内装载。
云数据仓库(如 Redshift、Snowflake、BigQuery)通过 JDBC 连接即可,用法和本地库无异,但注意它们的批量加载有专属步骤(如 Redshift 的 COPY、Snowflake 的 PUT/COPY)。我们用专属步骤而非通用表输出,速度差很多。
云上消息队列(Kafka)可作为源或目标:「Kafka 消费者」步骤读topic,「生产者」步骤写。我们近实时场景用 Kafka 做缓冲,Kettle 按批消费落湖,兼顾实时感与批处理稳定。
云秘钥管理要接进去:AccessKey 放云 KMS 或 Secrets Manager,Kettle 启动时拉取注入变量。我们禁止把云密钥写死,云上泄露代价极高,这条比本地更严。
跨区域传输留意费用与延迟。我们在同区域内部署 Kettle 节点,避免数据出区域产生流量费。架构上让计算贴近存储,是云成本优化的铁律,Kettle 节点位置也按此选。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<step><name>S3读</name><type>S3Input</type> <bucket>lake-raw</bucket><key>orders/${p_day}.csv</key> <access_key>${AWS_KEY}</access_key><secret_key>${AWS_SECRET}</secret_key> </step>
S3 接入凭据走变量,区域就近。我们所有云读取默认同区域,省流量费也降延迟。
<step><name>Redshift装载</name><type>RedshiftBulkLoader</type> <table>dwd_orders</table> <s3_staging>lake-stage/reds</s3_staging> <!-- 先上S3再COPY --> </step>
云仓专属批量加载比通用表输出快得多。我们 Redshift/Snowflake 都用专属步骤,先暂存 S3 再 COPY。
背景
团队图省事用通用表输出写 Redshift,大表装载超时,且产生大量小事务。
操作
改用 Redshift 批量加载:Kettle 先写 S3 暂存,再 COPY 进仓。
COPY dwd_orders FROM 's3://lake-stage/reds/orders.csv' CREDENTIALS 'aws_access_key_id=...' CSV;
结果
装载从 40 分钟降到 4 分钟,事务数骤减,仓库压力释放。
解读
根因是用错了写路径。云仓都有专属高速装载通道,绕开它就是和自己过不去。
变式
Snowflake 同理走 PUT+COPY;若数据量小,通用表输出也行,但大装载必走专属通道。
常见误区与工程取舍
误区:云仓用通用表输出。必用专属批量加载,速度量级差。
误区:云密钥写死。接 KMS/Secrets Manager,变量注入。
取舍:Kettle 节点同区域部署,贴近存储省费降延迟。
深入:和云平台数据服务怎么集成
云时代数据源常在对象存储、云数据仓库、云消息服务上。Kettle 通过对应的连接/步骤对接:对象存储(如 S3 兼容)做文件交换,云数据仓库做分析与落库,云消息做流式摄取。鉴权走访问密钥或临时令牌,务必用变量注入而非硬编码。一个实践:把「云上原始区 → Kettle 抽取清洗 → 云数据仓库集市」做成标准链路,团队复用同一套连接配置,避免每人各接各的云账号。
# 8.2 云平台数据服务集成 export AWS_ACCESS_KEY_ID=${p_cloud_ak} # 临时密钥,变量注入 export AWS_SECRET_ACCESS_KEY=${p_cloud_sk} # 读取 Parquet 比 CSV 省带宽且类型自描述,云上优先列式格式
⚠️ 常见坑(云集成)
- 密钥硬编码:云账号泄露后果远大于内部库,必须变量/临时令牌。
- 用 CSV 而非列式:云上带宽贵、类型易错,优先 Parquet/ORC。
- 区域写错:跨区传输既慢又计费,存储桶区域要对齐计算区域。
💡 关键直觉
- 云上「带宽与存储都计价」,格式选列式、区域对齐,能省真金白银。
- Kettle 与云对接的本质是「用统一图形语言操作异构云服务」,复用连接配置是团队效率关键。
| 云服务 | 用途 | 注意 |
|---|---|---|
| 对象存储 | 文件交换 | 列式格式 |
| 云数仓 | 分析落库 | 区域对齐 |
| 云消息 | 流式摄取 | 鉴权 |
工程实录:云上标准链路
每人各接各的云账号,重复且泄露风险高。
建共享云连接,原始区→清洗→集市做成标准链路,令牌变量化。
export AWS_ACCESS_KEY_ID=${p_cloud_ak} # Hadoop File 输入:s3a://etl-bucket/incoming/orders_${p_day}.parquet
团队复用同一套连接,安全且高效。
云上带宽度价,列式格式+区域对齐省真金白银。
跨区传输既慢又计费,存储区域要对齐计算区域。
参数与阈值速查
| 云服务 | 用途 | 注意 |
|---|---|---|
| 对象存储 | 文件交换 | 列式 |
| 云数仓 | 分析落库 | 区域 |
| 云消息 | 流式 | 鉴权 |
现场口诀
云上集成记住:带宽与存储都计价,格式选列式(Parquet/ORC)、区域对齐计算区,能省真金白银;鉴权走临时令牌变量注入,绝不硬编码;对象存储、云数仓、云消息各司其职,用统一图形语言串联,团队才能复用同一套连接配置。