8.1 大数据平台集成
8.1 大数据平台集成
Kettle 怎么和 Hadoop 系做朋友
本篇是第 8 章第 1 节,承接第七章集群,讲与 Hadoop 生态的衔接,是处理海量数据的现实路径。
读 HDFS 用「Hadoop 文件输入」、写 Hive 可用「Hive 输出」或通过 HDFS 落文件再由 Hive 外表挂载。我们日志类数据先落 HDFS,再用 Kettle 转换写回 Hive 外表,绕开 Hive 慢写,整体更稳。
与 Spark 的分工:Kettle 做编排与轻加工,重计算交给 Spark。我们一条链路是 Kettle 抽取清洗后把中间结果写 HDFS,触发 Spark 作业做复杂聚合,结果再回 Kettle 装载到仓库。各用所长。
HBase 通过「HBase 输入/输出」步骤按 rowkey 读写,适合宽表点查。我们用户画像的维表放 HBase,Kettle 在转换里用「数据库查询」式步骤按 key 补全画像,避免全量 join。
Kerberos 鉴权是大数据的门槛。Kettle 要配 krb5.conf 和 keytab,我们以服务账号做免密登录,并定时续期。鉴权配错时错误信息很隐晦,我们专门写了接入 checklist 减少踩坑。
集群协同上,Kettle 的 Carte 集群和 Hadoop 的 YARN 是两套调度,别混。我们让 Kettle 集群独立跑编排,重计算下沉 YARN,职责清晰,排错也分得清是哪边的问题。
关键代码与配置
下面这段 xml 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
<step><name>HDFS落文件</name><type>HadoopFileOutput</type> <uri>hdfs://ns1/stage/orders_${p_day}.csv</uri> </step> <step><name>挂Hive外表</name><type>ExecSQL</type> <sql>ALTER TABLE ext_orders ADD PARTITION(dt='${p_day}') LOCATION '/stage/orders_${p_day}'</sql> </step>
先落 HDFS 再挂 Hive 分区,比直接写 Hive 快且不易锁。我们大数据写入默认走这条,稳。
# 8.1 大数据平台集成 kinit -kt /etc/keytab/etl.keytab etl@REALM # 再启动 Carte,Hadoop 步骤即可凭票访问 Carte.sh 8080
Kerberos 票据是 Hadoop 接入的前提。我们用服务 keytab 自动续期,避免票据过期导致半夜任务全败。
背景
某转换用 Hive 输出直写,遇到大分区时锁等待超时,反复失败。
操作
改为先写 HDFS 文件,再用 ALTER 挂分区,Hive 写被绕开。
ALTER TABLE ext_orders ADD PARTITION(dt='2026-08-25') LOCATION '/stage/orders_2026-08-25';
结果
写入从经常超时变成稳定秒级挂分区,下游查询立即可见新数据。
解读
根因是 Hive 写入的锁与事务太重。海量数据走 HDFS 落地+外表挂载,把重写在 Kettle 外解决,是大数据集成的常识。
变式
若需 ACID,可走 Hive 事务表分批,但速率更低;按场景在「稳」与「事务」间取舍。
常见误区与工程取舍
误区:Kettle 直写 Hive 大分区。锁重易超时,落 HDFS+挂分区更稳。
误区:Kettle 扛重计算。交给 Spark/YARN,它只编排。
取舍:Kerberos 配 checklist;Carte 与 YARN 两套调度别混。
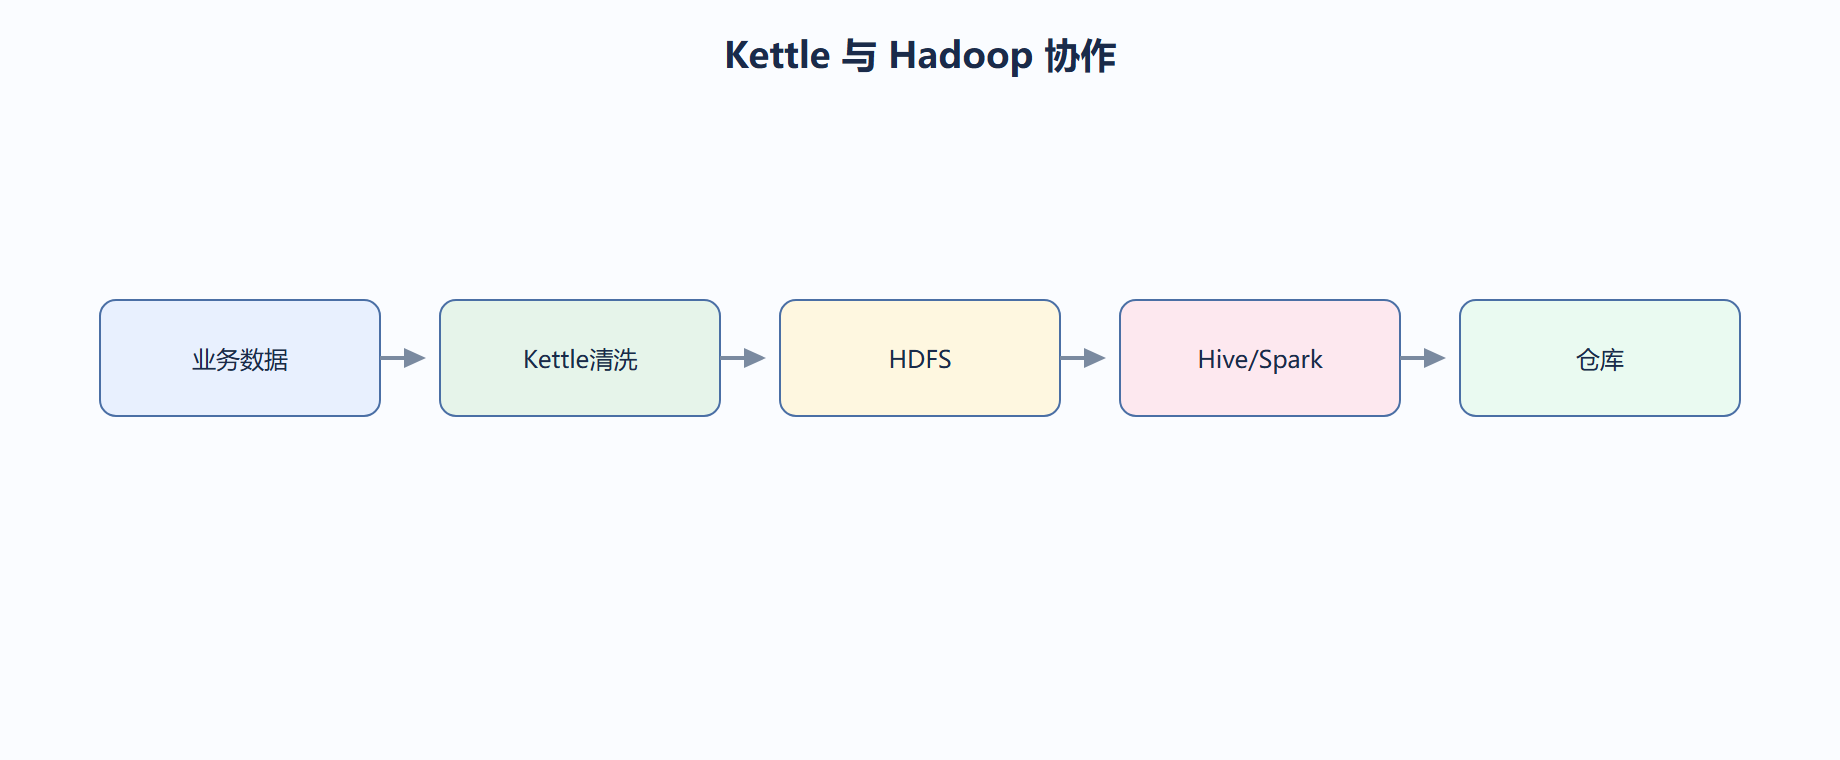
深入:和 Hadoop 生态怎么对接
Kettle 通过专用步骤与 Hadoop 生态对接:Hadoop File 输入输出读写 HDFS,Hive 输入输出直连数仓,还能把转换逻辑下推成 MapReduce 或 Spark 作业执行。关键是「让重计算发生在大数据引擎里」——Kettle 负责编排与搬运,不在内存硬算海量数据。典型链路:从业务库抽数 → 落 HDFS/仓 → 用 Hive/Spark 做清洗聚合 → 结果回写到服务库或集市供 BI。
-- 在 Hive 输出步骤目标里做库内聚合(输入:HDFS 上的原始数据;输出:Hive 集市表) INSERT OVERWRITE TABLE dws_user_amt SELECT user_id, SUM(amount) AS total_amt FROM ods_orders WHERE dt = '${p_day}' GROUP BY user_id; -- Kettle 只负责把数据送达与触发,聚合交给 Hive 引擎,避免内存爆掉
⚠️ 常见坑(大数据集成)
- 在 Kettle 内存硬算海量:应下推 Hive/Spark,否则 OOM。
- 忽略文件格式:HDFS 上用 ORC/Parquet 比文本快得多。
- 凭据散落:Hadoop 鉴权(如 Kerberos)用变量/凭据管理注入。
💡 关键直觉
- Kettle 在大数据栈里是「胶水与编排」,不是「计算引擎」;重活让专用引擎干。
- 对接 Hadoop 的第一原则:数据能不下搬就不下搬,计算能下推就下推。
| 组件 | Kettle 角色 |
|---|---|
| HDFS | 读写文件 |
| Hive/Spark | 承接重计算 |
| 业务库 | 抽取源头 |
工程实录:Kettle 编排 Hive 聚合
海量数据在 Kettle 内存硬算直接 OOM。
抽数落 HDFS,用 Hive 做聚合,结果回写集市。
INSERT OVERWRITE TABLE dws_user_amt SELECT user_id, SUM(amount) AS total_amt FROM ods_orders WHERE dt='${p_day}' GROUP BY user_id; -- Kettle 只负责送达与触发,聚合交给 Hive
内存压力消失,作业稳定。
Kettle 在大数据栈是胶水与编排,重活让引擎干。
用 Parquet/ORC 列式存储省带宽。
参数与阈值速查
| 组件 | Kettle 角色 |
|---|---|
| HDFS | 读写文件 |
| Hive | 接重计算 |
| 业务库 | 抽取源 |