9.5 维护与升级策略
9.5 维护与升级策略
上线只是开始,维护才是长仗
本篇是第 9 章第 5 节,讲长线运营,是管道生命力的来源,很多项目死在「上线即终点」。
版本升级要谨慎。Kettle 大版本间元数据格式、步骤行为可能变,我们升级前先在测试环境用全量小样跑一遍所有核心转换,diff 输出有无变化,确认无回归才上生产。升级不是点按钮,是带验证的项目。
依赖管理:JDBC 驱动、插件版本要随 Kettle 一起锁。我们曾因只升 Kettle 不升驱动,类型和连接诡异出错。现在驱动与 Kettle 同版本打包、同镜像,升级一体进行,杜绝半吊子。
技术债定期还:每月抽时间重构最复杂的几个转换,按 9.3 规范化简、补测试。我们设「债日」,否则业务催着加功能,图只会越来越臃肿,最终没人敢碰。
文档与血缘要随改随更新。我们规定改转换必同步更新其备注与简易血缘说明,否则下次排错又从零来。文档腐烂比代码腐烂更隐蔽,因为它不报错。
应急预案要演练。关键作业的重跑、回滚步骤写成 runbook,并定期演练,而不是出事才翻文档。我们每季度做一次「假设生产挂了」演练,确保恢复路径真能跑通。
关键代码与配置
下面这段 bash 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
# 升级验证:测试环境全量小样比对 pan.sh /file:order_sync.ktr -param:p_day=SAMPLE > new.out pan.sh /file:order_sync.ktr -param:p_day=SAMPLE > old.out # 旧版 # 非空则先排查步骤行为变化
升级前做输出 diff,是无回退风险的验证法。我们每次大版本都跑这套,挡过几次隐性行为变更。
# runbook 模板(关键作业) 1. 现象:作业连续失败 2. 定位:看 X 监控的 Y 指标 3. 重跑:kitchen.sh /file:nightly.kjb -param:p_day=YYYY-MM-DD 4. 回滚:git revert 最近一次转换改动 5. 升级:通知 oncall 与业务
应急 runbook 是维护的保险。我们关键作业都有,且演练过,出事不靠临场发挥。
背景
为修一个 bug 升级了 Kettle 大版本,忘记同步驱动,结果类型映射与连接行为变化,多个转换静默出错。
操作
把驱动与 Kettle 同版本打包进同一镜像,升级一体进行,并跑全量小样 diff 验证。
# 镜像内锁定 KETTLE=9.4 DRIVER=mysql-connector-8.0.x # 二者版本绑定,禁止单独漂移
结果
驱动与引擎一致后诡异错消失,且此后升级都带 diff 验证,再没踩过半吊子升级。
解读
根因是依赖未随主体一体演进。升级是系统工程,引擎、驱动、插件必须同版本、同验证,缺一不可。
变式
更稳是引入依赖清单 + 升级流水线,任何版本变更都走同一验证路径,人肉记忆不可靠。
常见误区与工程取舍
误区:升级只升引擎。驱动/插件须同版本一体升级。
误区:上线即终点。设债日定期重构,防臃肿失控。
取舍:升级前全量小样 diff;runbook 演练而非临场翻文档。
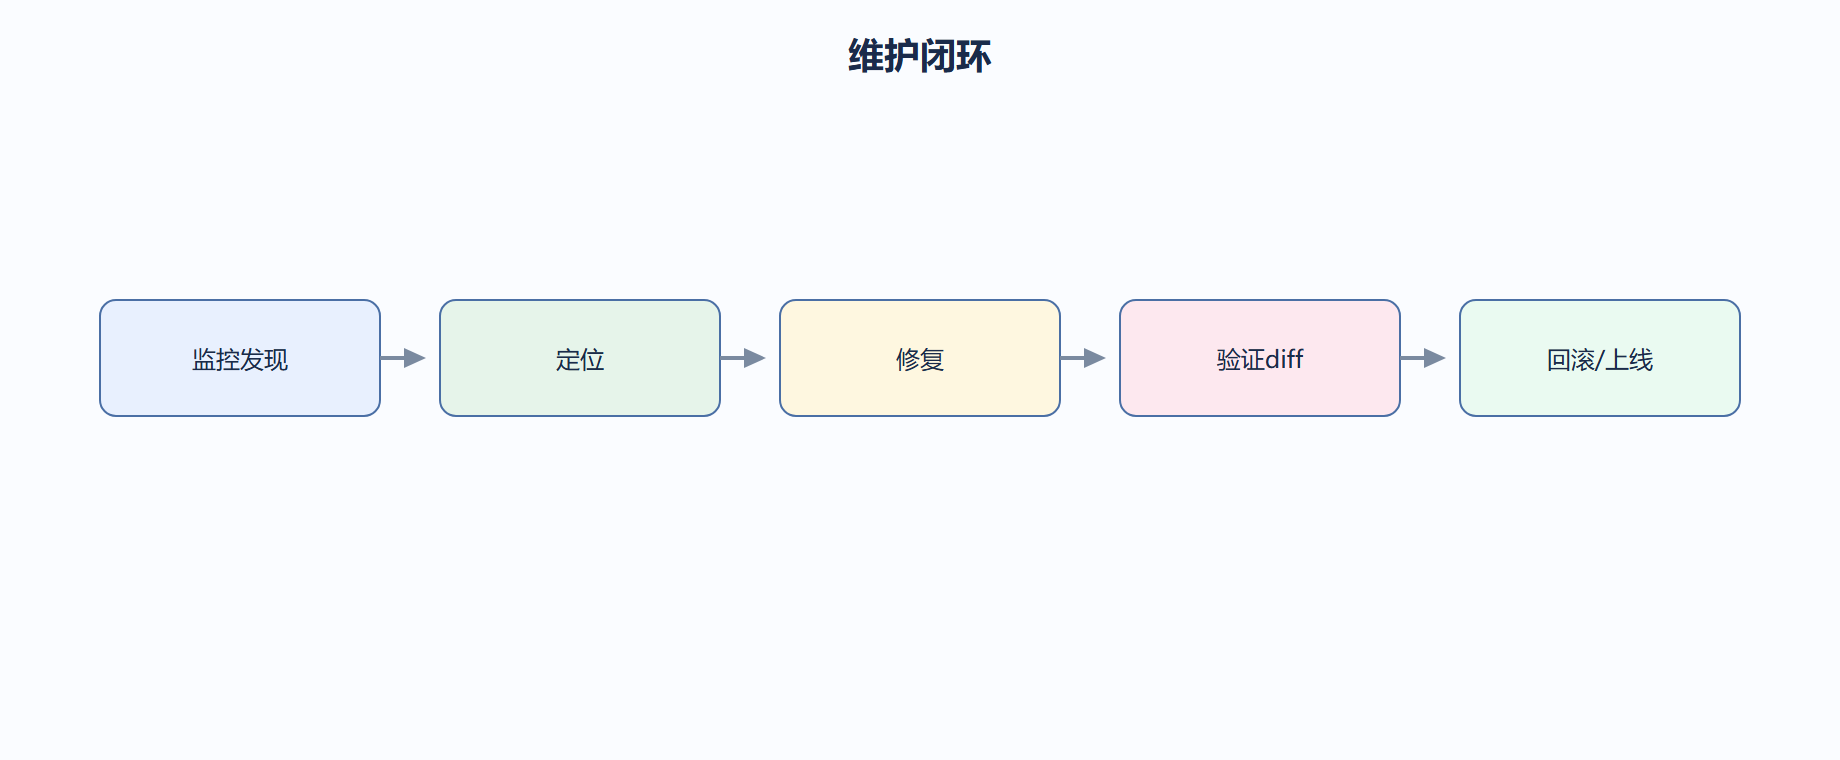
深入:长期维护与升级策略
管道上线只是开始,长期维护才是成本大头。我们建议:元数据纳入版本库,每次改动可回溯、可回滚;定期备份资源库与关键 .ktr/.kjb,防止误删;Kettle 版本升级先在测试环境验证插件兼容性与步骤行为差异,再灰度到生产,避免「一升级全册崩」。还要沉淀知识:把高频踩坑、复用子转换、典型连接模板整理成团队 wiki 与公共库,让经验可复用而非随人流失。
# 维护期例行动作(输入:版本库与备份;输出:可回滚、可恢复的元数据资产) git tag etl-2026-08-25 # 每次生产发布打标签,出问题 git checkout 回退 rsync -a /opt/etl/ /backup/etl/$(date +%F)/ # 每日备份元数据目录 # 升级流程:测试环境升 Kettle → 跑全量冒烟 → 灰度一台生产 → 全量
⚠️ 常见坑(维护升级)
- 不备份元数据:误删或升级翻车后无可回退,损失惨重。
- 直接升生产:插件/行为差异导致全册转换异常。
- 经验不沉淀:老人离职,踩过的坑新人重踩一遍。
💡 关键直觉
- 维护成本 > 开发成本,元数据备份与版本标签是「买保险」,便宜但救命。
- 升级要灰度:先在测试冒烟、再灰度一台,把「全册同时崩」的概率降到零。
| 动作 | 目的 |
|---|---|
| 版本标签 | 可回滚 |
| 每日备份 | 防误删 |
| 灰度升级 | 控风险 |
工程实录:灰度升级防全册崩
直接升生产,插件差异导致全册转换异常。
测试环境升 Kettle 跑冒烟,再灰度一台生产,最后全量。
git tag etl-2026-08-25 rsync -a /opt/etl/ /backup/etl/$(date +%F)/ # 升级:测试冒烟 -> 灰度一台 -> 全量
「全册同时崩」概率降到零,可回滚。
维护成本 > 开发成本,备份与标签是买保险。
沉淀通用子转换与连接模板进公共库。
参数与阈值速查
| 动作 | 目的 |
|---|---|
| 标签 | 可回滚 |
| 备份 | 防误删 |
| 灰度 | 控风险 |
现场口诀
维护成本远大于开发成本。元数据打版本标签、每日备份、升级先灰度,这三件事像买保险——平时觉得多余,出事时救命。尤其升级,先在测试环境跑全量冒烟,再灰度一台生产,把「全册同时崩」的概率降到零,而不是拿生产当试验田。
补充:知识沉淀与备份同等重要。把高频踩坑、复用子转换、典型连接模板整理进团队 wiki 与公共库,经验才不随人员流动而流失。维护不仅是保系统不宕,更是保团队不因一人离开而失忆——这和第二章「可交接」的初心一脉相承。
维护重于开发:元数据打标签可回滚、每日备份防误删、升级先测试冒烟再灰度生产。尤其升级,绝不直接动生产——先在测试环境验证插件与步骤行为差异,再灰度一台,把「全册同时崩」的概率降到零。沉淀复用子转换与连接模板,让经验不随人流失。